객체 번호 1은 1페이지가 아니다. 이 한 가지 사실이 PDF 처리 코드를 포맷의 그 어떤 부분보다 많이 넘어뜨린다. 그 이유는 뷰어가 렌더링하는 것만 보다가 뷰어가 실제로 읽는 객체 그래프를 보기 시작해야 비로소 드러난다
PDF 파일은 번호 매겨진 간접 객체들의 모음이다. 각 객체는 객체 번호와 세대 번호를 가지며, 다른 객체는 N G R로 쓰인 참조로 그것을 가리킨다. 3 0 R은 객체 3의 현재 버전이라는 뜻이다. 페이지도 다른 객체와 마찬가지의 객체지만, 파일의 어디에 앉았는지와 어떤 번호를 달고 있는지는 표시 순서에 대해 아무것도 말하지 않는다. 순서는 /Pages 트리에서 나온다. 객체를 번호순으로 훑으면 실제 세계 파일의 상당 수에서 페이지를 잘못된 순서로 조립하게 된다
트리는 덜 눈에 띄는 동작들도 살아 가는 곳이다. 트리 모양은 뷰어가 8,214페이지로 얼마나 빨리 건너뛸 수 있는지를 정하고, 내부 노드는 조용히 페이지 크기와 폰트를 아래의 잎들에게 물려주며, 구조 전체를 빠르게 만들어 주는 /Count 합계는 아무것도 강제하지 않는다. 셋 모두를 짚어 보자. 순서 자체부터
페이지 트리가 순서를 결정한다
모든 PDF에는 문서 카탈로그(ISO 32000-2 §7.7.2)가 있고, 카탈로그의 /Pages 항목이 페이지 트리의 루트 노드를 가리킨다. 그 루트는 /Type /Pages와 간접 참조의 /Kids 배열, 그 아래 잎 페이지 수를 주는 /Count를 가진 딕셔너리다. 표시 순서는 그 트리의 깊이 우선, 왼쪽에서 오른쪽 순회다. 규칙은 이게 전부다
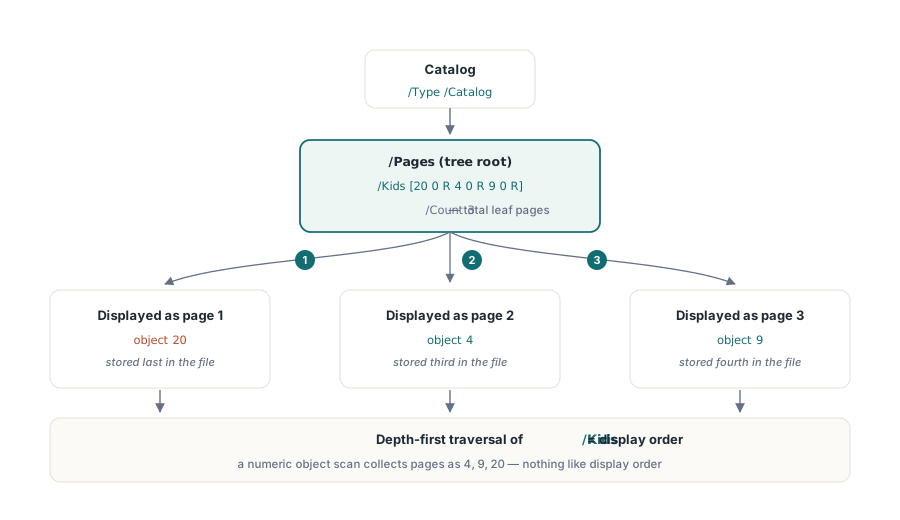
세 페이지짜리 최소 파일로 구체화해 보자:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% 객체 4는 파일에서 세 번째로 저장되지만 표시 순서로는 2페이지다
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% 객체 9는 네 번째로 저장되지만 3페이지다
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% 객체 20은 마지막에 저장되지만 1페이지다. 객체 번호가 아니라 Kids[0]가 결정한다
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj
/Kids 배열은 [20 0 R 4 0 R 9 0 R]로 읽힌다. 객체 20이 1페이지, 객체 4가 2페이지, 객체 9가 3페이지다. 객체를 번호순으로 순회하며 /Type /Page인 것을 전부 모으는 코드는 이 파일을 틀리게 처리한다. 더 나쁜 것은 출력이 여전히 그럴듯해 보인다는 점이다. 페이지 수는 맞고, 모든 페이지에 알아볼 수 있는 콘텐츠가 있고, 순서만 틀리다
생성기들이 이런 배치를 만드는 데는 평범한 이유가 있다. 모든 페이지의 객체 번호를 미리 확보해 두는 라이브러리는 생성 순서대로 번호를 매긴 뒤, 직렬화기에 맞는 아무 순서로나 바이트를 쓴다. 병합 도구는 충돌을 피하려고 소스 문서별 객체 번호를 다시 매기므로, 페이지 객체들은 합쳐진 객체 테이블에 흩어지고 새 루트 /Kids 배열이 올바른 순서를 쥐고 있게 된다. 그리고 증분 업데이트는 새 번호로 새 객체를 파일 끝에 덧붙이므로, 리비전에서 추가된 페이지는 1위 자리에 해당하더라도 바이트 스트림 끝자락에 산다
물어뜯는 것은 바로 이 마지막 사례다. 한 도구가 만든 테스트 코퍼스는 완벽히 통과하다가, 병합 워크플로에서 나온 파일이나 몇 번의 리비전을 거친 문서가 뒤섞여 나온다. 발견법적 수정은 버티지 못한다. 실패 여부가 생성기와 파일의 편집 이력에 달려 있기 때문이다. 진짜 수정은 짧다. 카탈로그에서 출발해 /Pages를 판별하고, /Kids를 재귀적으로 걷으며, 만나는 순서대로 잎을 내보내는 것. 페이지 순서 디버깅 사례 연구는 정확히 이 증상을 오진을 거쳐 근본 원인까지 따라가며, 재귀 순회 코드와 결과 확인용 qpdf 절차를 함께 보여 준다
팬 아웃은 성능 결정 사항입니다
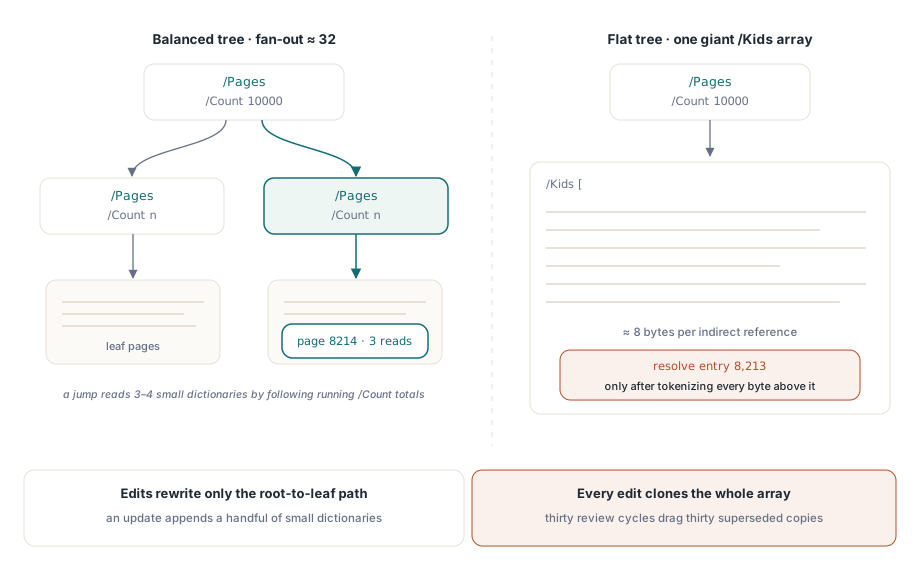
규격은 두 가지 모양을 허용한다. 단순한 생성기는 평면 트리를 내보낸다. 루트 /Pages 노드 하나의 /Kids가 /Page 잎만 담는 형태다. 작성기를 중첩으로 몰아 넣는 것은 아무것도 없고, 하나의 배열에 잎 참조 만 개를 담은 만 페이지 문서도 규격을 준수한다. 그럼에도 PDF Reference는 큰 문서에는 평형 트리를 권하고, 주류 생성기는 완만한 팬 아웃으로 그 조언을 따른다. 보통 중간 노드마다 자식 몇십 개이며, 각 중간 노드는 자기 /Kids와 자기 /Count를 가진다
그 이유는 뷰어가 무언가를 보여주기 전에 읽어야 하는 내용 때문입니다. 이 10,000페이지 파일의 8,214페이지로 바로 건너뛴다고 생각해 보십시오. 평면 트리(flat tree)의 경우 뷰어는 먼저 루트 노드를 파싱해야 하는데 그 루트 노드는 거대한 배열 하나입니다. 간접 참조당 약 8바이트라고 할 때, 8,213번 항목이 해결(resolve)되기 전에 끝에서 끝까지 토큰화해야 하는 80KB 크기의 객체입니다. 32개의 팬 아웃을 가진 평형 트리의 경우, 동일한 이동 과정에서 루트를 읽고, 누적된 /Count 합계를 비교하여 올바른 자식을 선택한 다음 내려갑니다. 즉 각각 수백 바이트인 작은 딕셔너리 서너 개만 있으면 됩니다. 이것이 트리가 제공하도록 설계된 O(log n) 무작위 접근(random access)이며 중간 노드에 /Count가 존재하는 전체 이유이기도 합니다. 이를 통해 리더(reader)는 전체 하위 트리를 열지 않고도 하위 트리를 건너뛸 수 있습니다
트리 모양은 편집 비용도 설정합니다. 한 페이지를 삽입하는 점진적 업데이트(incremental update)는 /Kids 또는 /Count가 변경된 모든 노드(즉, 새로운 잎의 부모에서 루트로 올라가는 경로)를 다시 작성해야 합니다. 평형 트리에서 이 경로는 파일에 추가되는 소수의 작은 딕셔너리들에 불과합니다. 평면 트리에서 "경로"는 개정 시마다 완전히 복제되는 거대한 단일 루트 배열입니다. 검토 및 주석 추가(review-and-annotate)를 서른 번이나 거친 계약서는 바이트 스트림 안에 쓸모없어진 동일한 80KB 배열의 사본 30개를 끌고 다니게 될 수 있습니다
처리 코드에는 중첩의 더 무딘 결과가 있다. /Kids의 첫 번째 수준에 페이지가 있다고 가정할 수 없으므로 모든 자식을 검사해야 한다. /Type /Pages면 재귀, /Type /Page면 잎이다. 첫 수준에서 멈추는 코드는 만나는 모든 평면 파일에서 잘 동작하다가, 생성기가 처음으로 중첩을 택한 순간 조용히 하위 트리 전체를 떨어뜨린다
내부 노드에는 상속된 속성이 포함됩니다
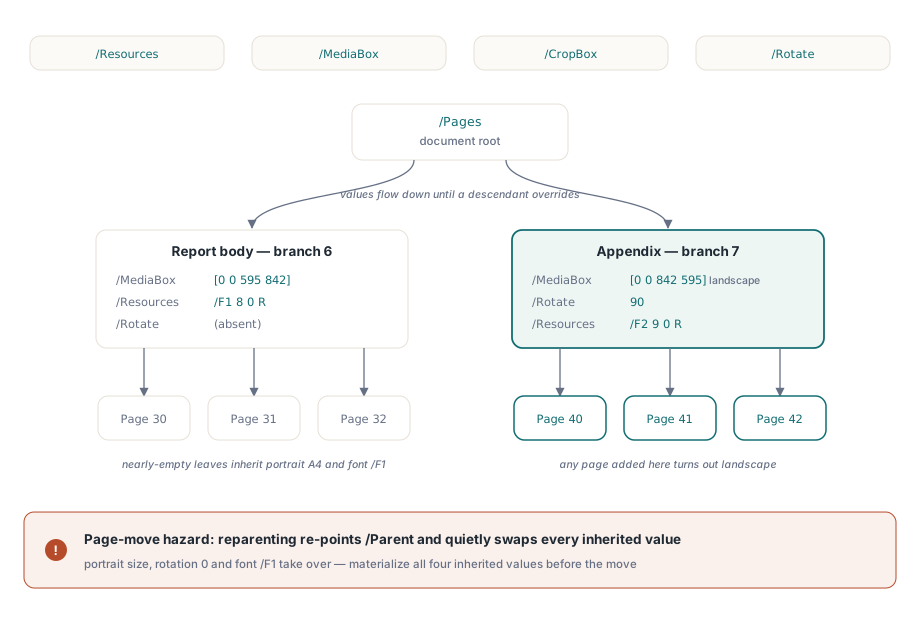
중간 노드는 탐색 경로 지정만 하는 것이 아니다. 네 가지 페이지 속성이 상속 가능하다(ISO 32000-2 §7.7.3.4). /Resources, /MediaBox, /CropBox, /Rotate다. 어떤 것이든 /Pages 노드에 놓일 수 있고, 그렇게 되면 자손이 재정의하지 않는 한 그 아래 모든 잎에 적용된다. 가로 방향 부록이 있는 보고서를 만드는 writer는 그 배치를 트리 자체로 표현할 수 있다:
5 0 obj   % 문서 루트
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % 보고서 본문: 세로 모드 A4, 본문 폰트
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % 부록: 가로 모드 A4, 회전됨, 자체 폰트
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % 부록 페이지: 크기, 회전, 폰트 상속
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
객체 40부터 42는 거의 비어 있다. 페이지 크기와 회전, 폰트 리소스는 모두 노드 7에서 도착하므로 파일은 간결하고 스스로를 유지한다. 부록 노드 아래에 네 번째 페이지를 추가해도 아무도 손대지 않았는데 가로 방향으로 나온다
이는 한 페이지의 속성이 전부 페이지 위에 있는 것도 아니라는 뜻이기도 하다. 객체 40에는 /MediaBox 키가 없는데 완전히 합법이다. 빠진 키를 기형 입력으로 취급하는 리더는 올바른 파일을 거부할 것이다. 탐색은 항목을 찾거나 루트에 닿을 때까지 /Parent 체인을 올라가야 한다. 그 올라가기에는 사이클 가드가 필요하다. 손상된 파일은 이미 방문한 노드를 다시 가리키는 /Parent 참조를 품을 수 있고, 방문 객체 집합이 없으면 탐색은 영원히 빙글빙글 돈다
동일한 메커니즘이 페이지 이동과 관련된 고전적인 위험(hazard)을 유발합니다. 어떤 도구가 두 개의 /Kids 배열을 편집하고 /Parent를 노드 6으로 다시 가리켜서 객체 40을 보고서 본문으로 옮겼다고 가정해 보십시오. 이 이동은 구조적으로 유효하지만, 이제 객체 40은 세로 모드(portrait) /MediaBox, 회전 없음, 폰트 /F1을 상속하는 반면 콘텐츠 스트림은 여전히 /F2를 선택하며 이는 더 이상 해결(resolve)되지 않습니다. 단 한 번의 편집으로 페이지가 축소되고 회전이 풀리고 텍스트를 잃습니다. 견고한 순서 변경(reordering) 코드는 상속 가능한 네 가지 속성 모두의 해결된 값들을 페이지 딕셔너리에 구체화(materialize)한 다음에 부모를 재지정(reparenting)합니다. 편집기에서 페이지를 끌어다 놓을 때 크기나 방향이 바뀌는 것을 본 적이 있다면 바로 이 메커니즘을 목격한 것입니다
평면화: 합법적이고 흔하며 때로는 비용이 많이 듭니다
상당수의 도구가 반대 길을 갑니다. 최소화된(minimal) 작성기는 단순성 때문에 단일 수준 트리를 출력하며, 많은 병합 및 분할 유틸리티(utilities)는 읽어 들인 트리가 무엇이든 /Kids 배열 하나로 평면화하여(flat) 재구축합니다. 왜냐하면 평형 구조를 생성하는 것은 추가 작업이고 평면적인 출력은 항상 사양을 준수하기 때문입니다. 올바른 재구축은 상속도 동시에 해결해야 합니다. 잎이 상속하던 모든 속성을 잎으로 복사하거나 문서 전체에 걸쳐 동일하다면 새로운 루트로 끌어올려야(hoist) 합니다. 그렇지 않으면 위 페이지 이동 사례와 정확히 동일한 방식으로 출력의 기하구조(geometry)가 변경됩니다
일반적인 문서의 경우 평면화(flattening)는 해롭지 않습니다. 평면화가 문제가 되는 것은 문서 규모가 클 때이며, 앞서 설명한 두 가지 방식으로 작용합니다. 즉 루트 배열이 거대한 하나의 객체가 되어 열기 작업과 모든 페이지 점프 시 이를 전부 구문 분석(파싱)해야 하며, 구조적 편집을 할 때마다 그 전체를 다시 작성하게 됩니다. 평면화가 파괴하지 않는 것은 간접 참조를 통한 공유입니다. 10,000페이지 모두가 동일한 /Resources 딕셔너리 객체를 가리키는 평면 트리라도 중복 제거는 유지됩니다. 잃게 되는 것은 단지 해당 항목을 페이지에 남겨두지 않고 조상(ancestor) 노드가 제공하도록 허용하는 선택지일 뿐입니다
/Count가 거짓말을 할 때
/Count는 순전히 장부 기입을 위한 것입니다. 노드의 하위 트리에 있는 잎 페이지 수와 같아야 하며, 파일 형식 자체에서는 이를 강제하는 것이 없습니다. 야생에서 보이는 거짓 수치(lying counts)들의 대부분은 두 가지 손상 패턴에 해당합니다
첫 번째는 점진적 업데이트(incremental update)가 남긴 오래된 수치(stale count)입니다. 편집기가 페이지를 삽입하고 새 /Kids 및 업데이트된 /Count로 바로 위 부모를 다시 쓴 다음 이들을 파일 끝에 추가하면서 조상들은 전혀 건드리지 않는 경우입니다
% 원본 리비전
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% 추가된 개정판: 가운데 분기에 한 페이지 삽입.
% 객체 14는 대체됨; 객체 12는 재작성되지 않음
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
이제 트리에는 잎(leaves)이 10개가 되었지만 루트에는 여전히 9개라고 쓰여 있습니다. 루트를 신뢰하는 뷰어는 페이지 카운터에 9페이지로 보고합니다. 페이지 이동 이진 검색(binary-search)에 내부 /Count를 사용하는 뷰어는 삽입 지점 이후의 모든 페이지에 대해 잘못된 인덱스를 계산하게 됩니다. 전체 순회(traversal)는 10개를 찾습니다. 하나의 파일, 세 가지 다른 답입니다
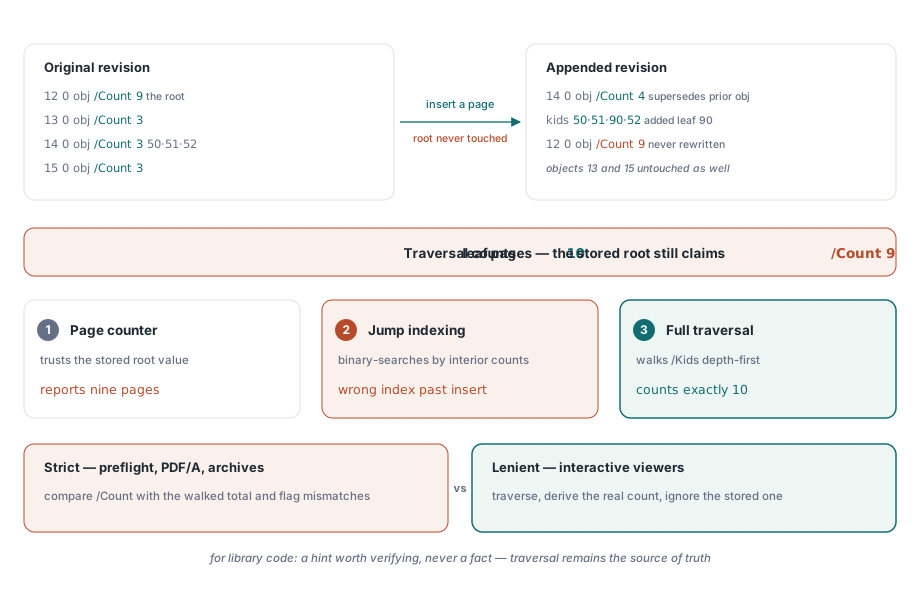
같은 파일에게 물어뜯기는 더 조용한 방법도 있다. 루트 개수를 읽고 트리 걷기를 시작해 그만큼 페이지를 모으면 멈추는 코드는 10페이지를 영영 보지 못한다. 예외도 경고도 없이, 그저 한 페이지 모자란 문서만 남는다. /Count를 루프 한도나 경계 검사로 쓰는 것이 실수다. 걷기는 저장된 숫자가 뭐라 하든 트리가 다 끝날 때까지 돌아야 한다
두 번째 패턴은 결코 맞을 수 없는 수치입니다. 음수, 하위 항목이 있는(populated) 노드에서의 0값 또는 터무니없이 큰 수치입니다. 이러한 수치들은 퍼징(fuzzing), 전송 오류(transmission damage) 및 간혹 편집기의 산술 버그에서 비롯됩니다. 이것들은 특히 할당(allocation) 시 /Count를 신뢰하는 코드에 위험합니다. -3이라는 /Count로부터 배열 크기를 정하는 것은 기껏해야 범위(range) 오류를 일으키고 20억이라는 /Count로 그 작업을 수행하는 것은 서비스 거부(DoS) 할당입니다. 파일 안의 여느 다른 수치와 마찬가지로 이 값은 신뢰할 수 없는 입력입니다
이 모든 것에 대해 파서(parsers)는 두 진영으로 나뉩니다. 엄격한(strict) 소비자(프리플라이트(preflight) 도구, PDF/A 검증기, 아카이빙 파이프라인)는 /Count를 순회(traversal) 결과와 비교하고 파일을 거부하거나 플래그를 지정합니다. 대화형 뷰어는 거의 보편적으로 관대합니다. 그들은 순회하고, 실제 개수를 파악하며 저장된 개수를 소리 없이 무시합니다. 이것이 바로 오래된 수치를 가진 파일이 어떤 자동화 워크플로 내부에서 더 엄격한 파서를 만날 때까지 여러 해 동안 불평 없이 유통될 수 있는 정확한 이유입니다. 라이브러리 코드를 위한 방어적인 중간 타협점은 /Count를 힌트(사전 할당 및 검증 후 하위 트리 건너뛰기에 유용)로 취급하되 순회 결과가 진실의 원천(source of truth)으로 남아 있도록 하는 것입니다
실전에서 이런 실패는 트리 문제로 자기소개하지 않는 경우가 많다. 뒤섞인 페이지, 병합 끝에서 사라진 페이지, 재정렬 뒤 크기나 방향이 바뀐 페이지의 모습으로 나타난다. 디버깅 사례 연구는 그런 보고 하나를 트리를 거슬러 추적한다. 주변의 파일 해부(객체, 교차 참조 데이터, 트레일러)는 PDF 파일 구조 개관에서 시작하는 것이 좋다
HotPDF Delphi Component는 이 모든 것을 내부적으로 처리한다. 어떤 깊이의 중첩 트리든 순회하고, 페이지를 복사하거나 옮길 때 상속된 속성을 판별하며, /Count를 신뢰하는 대신 실제 잎 수와 대조한다. 덕분에 그 API의 페이지 인덱스는 항상 논리 페이지를 뜻한다