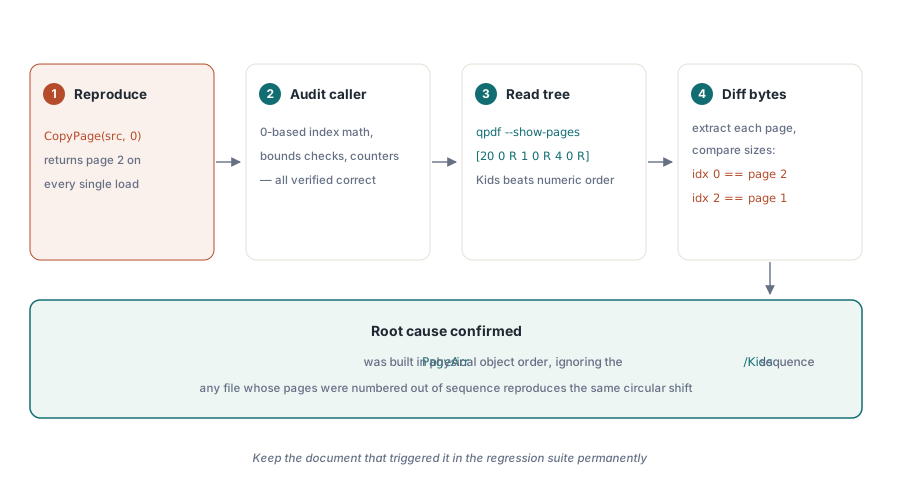
고전적인 증상은 오프바이원처럼 보입니다: 페이지 복사 루틴이 3페이지 문서의 페이지 1을 요청하는데 일관되게 페이지 2를 돌려받습니다. 인덱싱 로직은 문제가 없어 보입니다. 호출은 0 기반 논리 인덱스를 쓰고, 산술은 올바르고, 경계 조건도 정상입니다. 그런데도 매번 잘못된 페이지가 나옵니다
원인은 복사 코드 어디에도 없습니다. 로더가 페이지 배열을 만드는 방식에 있으며, PDF 파싱에서 가장 빠지기 쉬운 함정 중 하나입니다
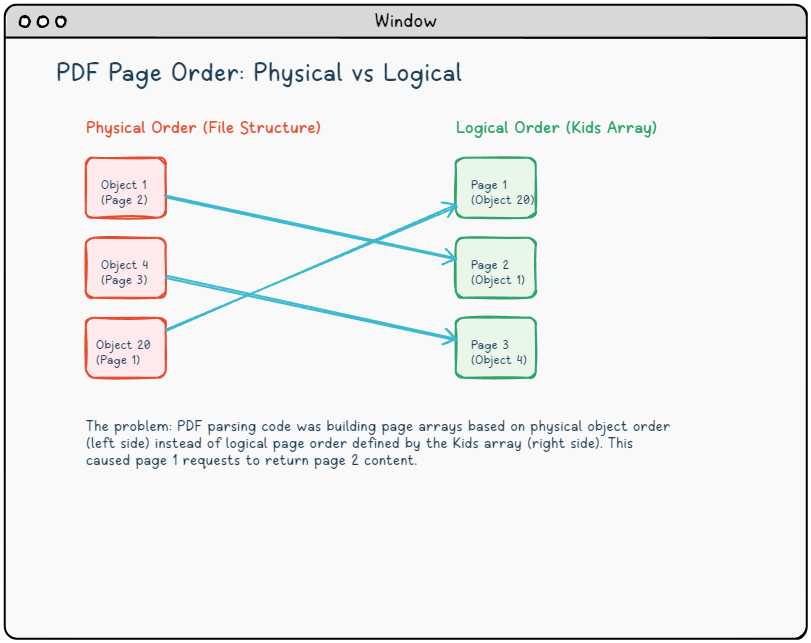
두 가지 순서, 그리고 혼란의 원인 한 가지
PDF 파일은 각자 객체 번호로 식별되는 간접 객체(indirect object)들의 모음입니다. 파일 구조는 그 번호들이 읽기 순서를 반영할 의무를 부과하지 않습니다. 객체 1이 페이지 2를 담을 수 있고, 객체 20이 페이지 1을 담을 수도 있습니다. 실제 읽기 순서를 정의하는 것은 페이지 트리입니다. /Pages 딕셔너리들의 계층 구조로, 그 /Kids 배열이 뷰어가 표시해야 할 순서대로 페이지 참조를 나열합니다(ISO 32000-1 §7.7.3)
이 함정을 드러내는 페이지 트리는 다음과 같습니다:
{ Pages 트리 루트, 객체 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { 논리적 페이지 1 }
         1 0 R    { 논리적 페이지 2 }
         4 0 R]   { 논리적 페이지 3 }
>>
endobj
이 파일은 우연히 바이트 스트림에서 객체 20 이전에 객체 1과 객체 4를 나열하고 있었습니다. 파일 순서대로 간접 객체를 순회(iterated)하며 페이지-유형 딕셔너리를 발견할 때마다 PageArr에 이를 기록하는(stamped) 파서(parser)라면, 결국 인덱스 0에 객체 1을, 인덱스 1에 객체 4를, 인덱스 2에 객체 20을 위치시키게 됩니다. 논리적 페이지 1은 PageArr[2]에 자리하게 됩니다. 인덱스 0의 페이지를 요청하면 그 대신 논리적 페이지 2를 가져오게 되는 것입니다
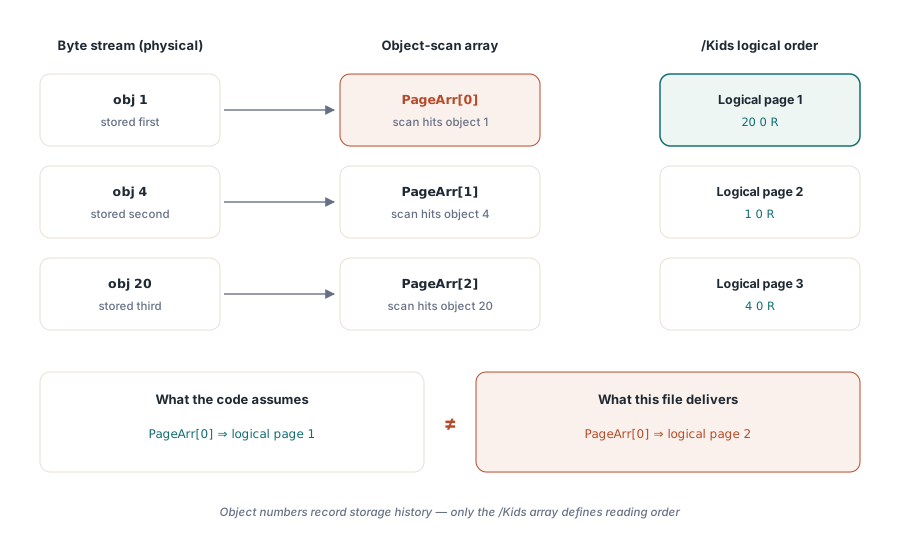
가설 확인하기
코드를 바꾸기 전에, 가정하지 말고 불일치를 증명하십시오. qpdf 명령줄 도구가 이를 간단하게 만들어 줍니다:
{ shell }
qpdf --show-pages input.pdf
{ 출력은 Kids 순서를 보여줌: 20 0 R, 그다음에 1 0 R, 그다음 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ 읽기 순서대로 /Kids를 포함한 Pages 딕셔너리를 보여줌 }
각 페이지를 개별적으로 추출해 파일 크기를 비교하면 매핑이 확인됩니다: 객체 스캔 방식의 PageArr[0]가 만들어내는 것은 논리적 페이지 2에 속한 콘텐츠이고, PageArr[2]는 논리적 페이지 1을 담고 있습니다. 원형 이동(circular shift)이 결정적 증거입니다. 이는 증상이 서로 다른 많은 소스 문서에서 나타나는 이유도 설명해 줍니다: 페이지 객체들이 우연히 어떤 앞선 논리 페이지보다 낮은 객체 번호를 가진 PDF라면 무엇이든 이 문제를 일으킵니다
PDF가 이런 상태에 놓이는 데에는 단순한 이유가 있습니다. 증분 업데이트는 자신이 바꾸는 객체들의 번호는 유지하지만, 추가하는 것들 — 앞에 삽입된 표지 페이지가 대표적입니다 — 은 파일에 이미 있던 모든 것 위의 새 번호를 받으며, 그 참조는 Kids 배열의 앞쪽으로 갑니다. 문서를 병합하거나 재편성하는 도구는 제 마음대로 객체 번호를 다시 매깁니다. 어떤 생성기는 논리적 페이지 순서보다 콘텐츠 스트리밍에 편한 순서로 페이지를 쓰기도 합니다. PDF 형식은 그중 누구에게도 다르게 할 것을 요구하지 않습니다
올바른 접근: Kids 배열 따르기
간접 객체를 스캔하는 대신 카탈로그 루트에서 /Kids 사슬을 따라가며 페이지 목록을 만드십시오. 이 순회는 재귀여야 합니다. 큰 문서는 보통 페이지를 중간 /Pages 노드에 나눠 담고, 자기 조상 중 하나를 다시 가리키는 잘못된 트리도 막아야 하기 때문입니다. 아래 스케치에서 TPdfDict와 TPdfArray는 여러분의 파서가 쓰는 딕셔너리와 배열 타입을 뜻합니다:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // 순환이거나 병적으로 깊은 트리
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // 간접 참조를 따라간다
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // 중간 노드
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // 리프: 표시 순서의 다음 페이지
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// 사용: 카탈로그의 /Pages 항목에서 시작
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
  LogWarning('Page tree /Count disagrees with the pages actually found');
두 가지 세부는 의도된 것입니다. /Type 항목이 없는 리프도 여전히 페이지로 취급하는데, 일부 작성기는 이를 생략하고 뷰어들은 그런 파일도 열어 주기 때문입니다. 그리고 마지막 /Count 비교는 비용이 들지 않지만, 호출자가 인덱스를 꽂기 전에 잘리거나 손으로 편집된 트리를 잡아 줍니다
HotPDF로 문서를 로드한다면 이 순서는 문서가 로드될 때 이미 해결되어 있습니다: 페이지 인덱스는 중첩된 /Pages 노드를 포함해 페이지 트리의 표시 순서를 따르므로, 인덱스 0은 언제나 뷰어가 보여주는 첫 페이지입니다. 위의 순회가 중요해지는 것은 여러분의 코드가 PDF 구조를 직접 파싱할 때입니다
CopyPageFromDocument로 논리 인덱스로 복사하기
HotPDF는 로드 시점에 페이지 순서를 해석하므로, 논리적 페이지 인덱스는 호출자가 기대하는 의미를 가집니다. 상위 수준의 CopyPageFromDocument는 0 기반 논리 인덱스를 받아 올바른 페이지를 대상 문서로 복사합니다:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { 논리적 페이지 0 (사용자가 보는 첫 페이지) 복사 }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
인덱스가 표시 순서 인덱스이므로, CopyPageFromDocument는 물리적 순서와 논리적 순서가 갈라진 문서 상대로도 올바르게 동작합니다. 배치 작업에는 InsertPagesFromDocument가 논리 인덱스 배열을 받아 한 번에 복사합니다
이 사례가 PDF 파싱에 대해 밝혀주는 사실
PDF 사양은 명시적입니다: 논리적 페이지 순서는 객체 번호나 바이트 오프셋이 아니라 페이지 트리의 /Kids 배열이 정의합니다(ISO 32000-1 §7.7.3.2). 다른 순서를 지름길로 쓰는 파서는 보는 문서 대다수에서 올바른 결과를 냅니다. 대부분의 생성기는 페이지를 자연 순서로 쓰고 연속된 객체 번호를 붙이기 때문입니다. 이 실수는 누군가 증분 편집되었거나 다른 도구로 재편성되었거나 다른 배치를 택한 소프트웨어가 만든 PDF를 로드할 때까지 숨어 있습니다
자기 생성 PDF만 상대로 테스트하면 이 부류의 문제는 아예 놓칩니다. 페이지 순서 처리에는 다양한 출처의 문서 테스트 코퍼스가 필요합니다: 증분 저장, 삽입된 표지 페이지가 있는 스캔 문서, 객체 그래프를 다르게 선형화하거나 최적화하는 도구가 만든 PDF. 물리적 순서와 논리적 순서가 갈라진 문서라면 무엇이든 그 코퍼스에 영구 자리를 얻을 자격이 있습니다
HotPDF Delphi Component 페이지에 CopyPageFromDocument, InsertPagesFromDocument, MovePage를 포함한 페이지 연산의 전체 API가 정리되어 있습니다