Excel에서는 ="a-b">"ab"가 TRUE이고, ="a~b"<"ab"도 TRUE입니다. 같은 쌍을 Delphi의 CompareText에 넘기면 두 답이 모두 뒤집히는데, 코드 포인트 순서에서 하이픈은 글자보다 아래에 있고 물결표는 그 위에 있기 때문입니다. Excel은 Windows 사용자 로캘의 대소문자를 무시하는 "워드 정렬"로 텍스트를 비교하며, 여기서 하이픈과 아포스트로피는 동률만 가르고 나머지 문장 부호는 모두 숫자와 글자보다 앞에 옵니다
증상에는 collation이 거의 언급되지 않습니다. 서버에서 계산한 COUNTIF(A:A,">M")은 같은 수식을 Excel에서 계산한 것보다 두 행을 더 세고, 리포팅 서비스가 정렬한 가격 목록은 X-100을 Excel이 두지 않을 위치에 놓으며, 열에 abc가 분명히 있는데도 VLOOKUP("ABC",...)이 #N/A를 돌려줍니다. 세 사례 모두 하나의 질문으로 환원됩니다. 양쪽 피연산자가 텍스트일 때 어느 쪽이 더 작은가? Excel에는 정확한 답이 있고, 그 답은 Delphi 코드가 기본값으로 내놓는 것과 다른 경우가 대부분입니다
Excel은 두 텍스트 문자열을 어떤 규칙으로 비교할까?
Excel은 현재 Windows 사용자 로캘의 워드 정렬로, 대소문자를 무시하고 두 텍스트 값을 비교합니다. 워드 정렬은 Windows NLS 비교 함수의 기본 collation으로, 글자를 코드 포인트가 아닌 언어학적 순서로 비교하므로 é는 e와 f 사이에 놓이고 대문자와 소문자는 하나로 접힙니다. 두 문자는 특별 취급을 받습니다. 하이픈 -과 아포스트로피 '는 첫 패스에서 건너뛰기 때문에 co-op이 coop 바로 옆에 붙고, 나머지 문자가 동률일 때만 그 문자의 존재와 위치가 순서를 결정합니다. 그 외의 문장 부호는 온전한 무게로 계산되어 숫자보다 앞에 오고, 숫자는 글자보다 앞에 옵니다
표는 IF(A<B,...)에 대한 Excel의 판정을, Delphi 개발자가 가장 먼저 쓰기 쉬운 두 비교와 나란히 놓고 있습니다
| A vs B | Excel / HotXLS | CompareStr (ordinal) | CompareText |
|---|---|---|---|
"a-b" vs "ab" | 크다 | 작다 | 작다 |
"a'b" vs "ab" | 크다 | 작다 | 작다 |
"a~b" vs "ab" | 작다 | 크다 | 크다 |
"a_b" vs "ab" | 작다 | 작다 | 크다 |
"ab" vs "AB" | 같다 | 크다 | 같다 |
"é" vs "f" | 작다 | 크다 | 크다 |
"Z" vs "f" | 크다 | 작다 | 크다 |
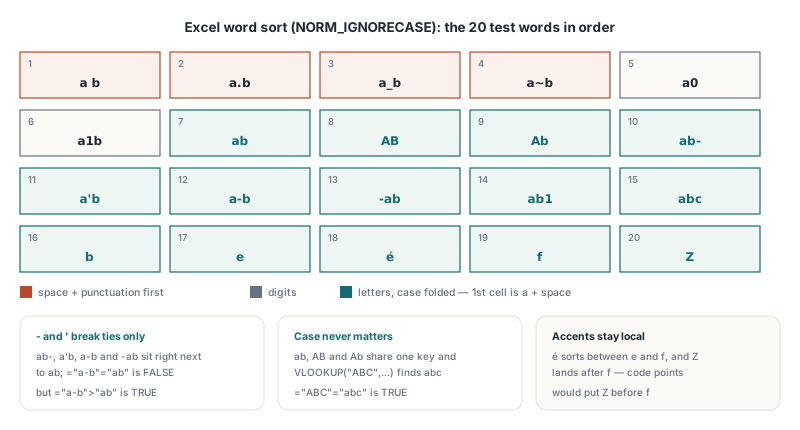
놓치기 쉬운 결과가 둘 있습니다. 하이픈은 동률만 가르기 때문에 ="a-b"="ab"는 FALSE입니다. 두 문자열은 정렬에서 바로 이웃이지만 여전히 같지 않습니다. 그리고 대소문자는 완전히 접히므로 ab, AB, Ab는 모든 비교 연산자에서 하나의 키입니다. 영어 사용자 로캘에서 20개의 까다로운 단어 열은 a b, a.b, a_b, a~b, a0, a1b, ab / AB / Ab, ab-, a'b, a-b, -ab, ab1, abc, b, e, é, f, Z 순으로 정렬됩니다. ab 그룹 안에서는 건너뛴 문자의 위치가 순서를 결정합니다. 뒤에 붙은 하이픈이 먼저, 앞에 붙은 하이픈이 마지막입니다
정렬 규칙을 직접 Excel과 대조해 보기
Excel 문서는 자신이 쓰는 collation 이름을 밝히지 않으므로, 내 장비에서 확실히 확인하는 방법은 문자열 쌍 한 묶음을 Excel에게 판정하게 하고 그 결과를 여러 플래그 조합의 CompareStringW 결과와 비교하는 것입니다. 쌍을 두 열에 넣고 각 행마다 Excel이 =IF(A1<B1,-1,IF(A1=B1,0,1))을 계산하게 한 뒤, 같은 쌍을 API로도 돌려 봅니다. 만들 가치가 있는 쌍은 ASCII 문장 부호, 숫자, 양쪽 대소문자, 공백, é, ß, ä 같은 악센트 문자, CJK 문자, 전각 문자, non-breaking space를 섞고, 한 글자만 다른 근접 사례를 충분히 넣은 것입니다. 사전에서 뽑은 무작위 단어는 좋지 않은 표본입니다. 이 글의 어떤 규칙에서도 평범한 글자는 똑같이 정렬되기 때문입니다
플래그 조합에 따라 결과가 뚜렷이 갈립니다:
NORM_IGNORECASE만 쓰고LOCALE_USER_DEFAULT와 함께 호출하는 것이 순수한 워드 정렬이며, Excel이 따르는 조합입니다SORT_STRINGSORT를 더하면 string sort로 바뀌어, 하이픈과 아포스트로피가 온전한 무게의 보통 기호가 되고a-b/ab식의 쌍은 전부 거꾸로 나옵니다NORM_IGNOREWIDTH를 더하면 전각 글자와 반각 글자가 같아지는데, Excel은 이 둘을 구분해 둡니다
함정 하나는 테스트 하네스 자체에 있습니다. Excel은 셀에 맨 앞에 입력한 아포스트로피를 "텍스트로 저장" 접두사로 취급하므로, 입력 전체가 '인 셀은 비어 버리고, 그런 식으로 만든 쌍은 collation과 아무 상관 없는 불일치를 보고합니다. 이런 쌍은 수식에서 문자열 리터럴로 만들거나(="'") 아예 건너뛰세요
CompareText와 ordinal 비교는 왜 틀릴까?
CompareText와 ordinal 비교는 UTF-16 코드 유닛끼리 비교하고 코드 포인트 순서는 문장 부호를 알파벳 주변에 흩어 놓기 때문에 Excel의 순서를 벗어납니다. 하이픈은 U+002D, 아포스트로피는 U+0027로 둘 다 모든 글자보다 아래이므로, ordinal 비교는 "a-b"를 "ab"보다 작다고 하지만 Excel은 하이픈을 동률 처리로 봅니다. 물결표는 U+007E로 모든 글자 위에 있으므로 "a~b"가 더 크다고 나오는데, 이 역시 Excel과 반대입니다. CompareText는 자체 왜곡도 하나 더합니다. a..z만 대문자로 접은 뒤 코드 유닛을 비교하는데, 밑줄(U+005F)이 대문자 범위와 소문자 범위 사이에 있어서 접기가 "a_b"를 "ab" 아래에서 위로 옮겨 버립니다. 어느 함수도 é가 e와 f 사이에 속한다는 사정은 모릅니다
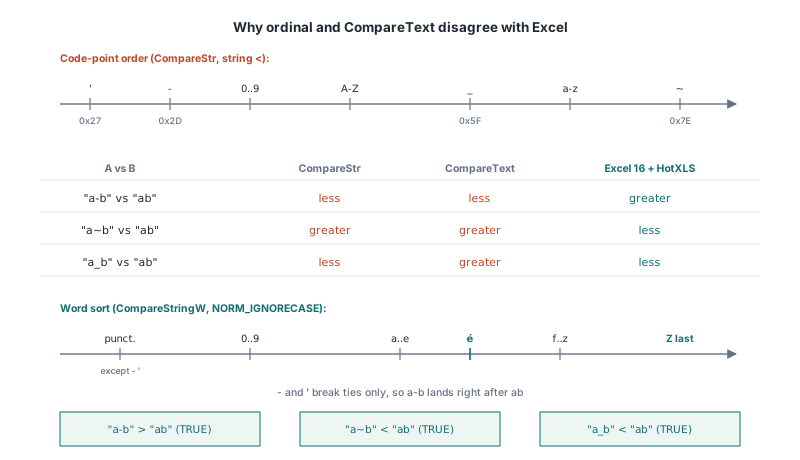
평범한 Delphi 도구들은 기준의 양쪽에 걸쳐 있습니다:
CompareStr, 문자열<연산자,TComparer<string>.Default는 ordinal이면서 대소문자를 구분하므로, comparer 없이 쓴TArray.Sort<string>은Z를f보다 앞에 놓습니다CompareText와SameText는 ASCII 대소문자 접기 후 ordinal 비교입니다- Windows에서 Delphi RTL의
AnsiCompareText와WideCompareText는 Excel과 일치하는 호출인CompareString(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)을 부릅니다. 기본 설정(UseLocaleTrue,CaseSensitiveFalse)의 정렬된TStringList도AnsiCompareText를 거치므로 Excel에 동의합니다 - POSIX 대상에서 Delphi RTL은
AnsiCompareText를 ICU collator로 우회시키는데, 이는 문장 부호 규칙도 다른 별개 알고리즘입니다. Windows에서 Free Pascal의AnsiCompareText는 ANSI 코드 페이지로 변환해CompareStringA를 부르므로 그 코드 페이지가 표현하지 못하는 문자는 모두 잃습니다
그러니까 로캘 인식 RTL 함수가 Windows에서 우연히 맞는 것은 지금의 구현 방식 때문입니다. Excel과 반드시 일치해야 하는 코드는 API 호출을 명시적으로 하고 그 사실을 코드에 드러내야 합니다. 더 어려운 문제는 수식 엔진이라면 어디든 나타납니다. 코드 경로마다 가장 가까운 비교를 집어 드리기 때문입니다. =와 < 연산자에서는 대문자로 바꾼 뒤 코드 포인트를 비교하고, COUNTIF 기준의 > / < 분기에서는 대소문자를 구분하는 Variant 비교를, VLOOKUP 안에서는 또 다른 비교를 씁니다(바로 이 때문에 VLOOKUP("ABC",A1:A20,1,FALSE)이 abc를 찾지 못합니다). 범위 정렬에서는 로캘 호출을 씁니다. 경로 하나하나는 나름의 정당성이 있지만, 함께 놓으면 같은 열 위에 세 가지 다른 순서가 생깁니다
HotXLS에서 수식과 조회, 정렬 뒤에 있는 하나의 비교
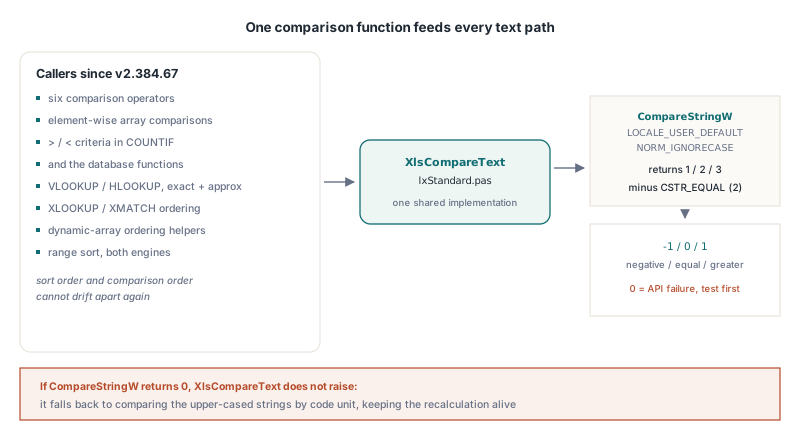
HotXLS는 계산과 정렬 코드에서 일어나는 모든 텍스트 대 텍스트 비교를 lxStandard.pas의 단일 함수 XlsCompareText로 보냅니다. 이 함수는 CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE, ...)를 호출해 CSTR_EQUAL을 뺍니다. 여섯 비교 연산자가 이 함수를 쓰고, 배열 수식의 요소별 비교, COUNTIF 스타일 기준과 데이터베이스 함수의 >, <, >=, <= 분기, 정확히 일치와 근사 모드의 VLOOKUP과 HLOOKUP, 동적 배열 함수와 XLOOKUP / XMATCH 뒤의 순서 판정, TXLSWorksheet와 TXLSXWorksheet 양쪽의 SortRange도 그렇습니다. 범위 정렬을 같은 함수에 얹은 것이 설계의 결정 포인트였습니다. 텍스트 대상 근사 VLOOKUP은 열이 조회가 비교하는 순서로 정렬돼 있을 때만 제대로 된 답을 주는데, 함수를 하나만 쓰면 두 순서가 어긋날 수 없습니다
Delphi에서 이 규칙을 가장 빨리 확인하는 방법은 TXLSXWorkbook.Calculate입니다. 활성 시트를 기준으로 수식 문자열을 평가해 Variant로 돌려줍니다
uses
  System.Variants, lxHandleX;

var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.Sheets.Add('Data');  // Calculate는 활성 시트에 대해 평가함
    Writeln(VarToStr(Book.Calculate('="a-b">"ab"')));   // True: 하이픈은 동률만 가름
    Writeln(VarToStr(Book.Calculate('="a-b"="ab"')));   // False: 동률이 깨진 것이지 같지 않음
    Writeln(VarToStr(Book.Calculate('="a~b"<"ab"')));   // True: 문장 부호가 먼저
    Writeln(VarToStr(Book.Calculate('="ABC"="abc"')));  // True: 대소문자 무시
  finally
    Book.Free;
  end;
end;
워드 정렬은 양쪽 피연산자가 모두 텍스트일 때만 적용됩니다. 혼합 타입은 모든 숫자가 모든 텍스트보다 아래이고 모든 텍스트가 모든 boolean보다 아래인 고정 순위를 따르는데, 이는 비교 체인, 빈 피연산자와 SUMIF를 다룬 글에 정리돼 있습니다. "a*"나 "=ab" 같은 와일드카드 기준은 자기 규칙이 있는 패턴·동등성 검사로, COUNTIF, MATCH, DSUM의 Excel 와일드카드 안내에서 다룹니다. 여기서 이야기하는 collation은 순서 비교 연산자를 결정합니다
다음 예제는 20개 단어를 시트의 A열에 넣고 기준 카운트 세 개와 조회 하나를 확인한 뒤 TXLSXWorksheet.SortRange로 그 열을 정렬합니다. 기댓값은 앞에서 본 정렬 순서에서 바로 나옵니다. ab 그룹보다 뒤에 정렬되는 단어가 열하나, a-b보다 앞에 오는 것이 열하나, ab 그룹 셋은 열하나에 합쳐져 >=AB가 됩니다
const
  Words: array [0..19] of string = ('ab', 'a-b', 'a~b', 'a_b', 'AB', 'a b',
    'ab1', 'ab-', '-ab', 'abc', 'a''b', 'Ab', 'b', 'a.b', 'a1b', 'a0',
    #$00E9, 'e', 'f', 'Z');
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  i: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Words');
    for i := 0 to High(Words) do
      Sheet.Cells[i + 1, 1].Value := WideString(Words[i]);

    // 워드 정렬 순서에서 나오는 기댓값: 11, 11, 14
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">ab")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,"<a-b")')));
    Writeln(VarToStr(Book.Calculate('=COUNTIF(A1:A20,">=AB")')));

    // abc를 찾음: 조회는 Excel처럼 대소문자를 구분하지 않고 비교
    Sheet.Cells[1, 3].Formula := '=VLOOKUP("ABC",A1:A20,1,FALSE)';
    Book.Recalculate;
    Writeln(VarToStr(Sheet.Cells[1, 3].Value));                // abc

    // 키 열 하나, 오름차순: a b, a.b, a_b, a~b, a0, a1b, ab, AB, Ab, ...
    Sheet.SortRange(1, 1, 20, 1, [1], [False]);
    for i := 1 to 20 do
      Writeln(VarToStr(Sheet.Cells[i, 1].Value));
  finally
    Book.Free;
  end;
end;SortRange는 안정 병합 정렬을 돌리므로, 서로 같다고 비교되는 ab, AB, Ab는 정렬 전의 상대 순서를 유지합니다. 빈 셀은 키가 오름차순이든 내림차순이든 맨 아래로 가는데, Excel도 그렇게 놓습니다
내 Delphi 코드에서 Excel의 정렬 순서를 어떻게 맞추지?
워크북 밖에서 Excel의 텍스트 순서를 재현하려면 LOCALE_USER_DEFAULT와 NORM_IGNORECASE로 CompareStringW를 호출하고 SORT_STRINGSORT와 NORM_IGNOREWIDTH는 빼야 합니다. 반환값을 잘 봐야 합니다. 이 API는 부호 있는 결과를 돌려주지 않고 CSTR_LESS_THAN(1), CSTR_EQUAL(2), CSTR_GREATER_THAN(3)을 돌려주며, 호출이 실패하면 0을 줍니다. 2를 빼면 익숙한 음수 / 0 / 양수 규약이 되지만, 0인 경우를 먼저 걸러낸 다음에야 성립합니다. 그렇지 않으면 실패한 호출이 -2가 되어 "작다"로 읽힙니다
uses
  Winapi.Windows, System.SysUtils, System.Generics.Defaults,
  System.Generics.Collections;

// Excel의 텍스트 순서: 사용자 로캘 워드 정렬, 대소문자 무시
function ExcelCompareText(const A, B: string): Integer;
var
  R: Integer;
begin
  R := CompareStringW(LOCALE_USER_DEFAULT, NORM_IGNORECASE,
    PWideChar(A), Length(A), PWideChar(B), Length(B));
  if R = 0 then
    RaiseLastOSError;          // 0은 실패지 비교 결과가 아님
  Result := R - CSTR_EQUAL;    // 1/2/3이 -1/0/1로 됨
end;

var
  Keys: TArray<string>;
begin
  Keys := ['abc', 'a-b', 'AB', 'a~b', '-ab', 'ab'];
  TArray.Sort<string>(Keys, TComparer<string>.Construct(
    function(const L, R: string): Integer
    begin
      Result := ExcelCompareText(L, R);
    end));
  // a~b, ab / AB (같음, 어느 순서든), a-b, -ab, abc
end;
uses 절에 HotXLS가 이미 들어 있다면 lxStandard.XlsCompareText가 public이고 같은 순서를 돌려줍니다. 둘은 실패한 API 호출에서만 갈립니다. 위 함수는 예외를 던지지만 XlsCompareText는 대문자로 바꾼 문자열을 코드 유닛으로 비교하는 것으로 대체해 재계산이 도중에 끊기지 않게 합니다. 독립된 정렬이라면 예외를 던지는 쪽이 낫습니다. 조용히 틀린 순서는 예외보다 추적이 어렵습니다
TArray.Sort는 안정 정렬이 아니므로 ab와 AB 같은 같은 키가 어느 순서로든 나올 수 있습니다. 같은 키의 원래 순서가 중요하다면 인덱스 배열을 정렬하고 원래 위치를 보조 키로 쓰세요
때로는 열이 의도적으로 Excel의 순서를 무시해야 합니다. 부품 번호가 전형적입니다. X-100과 X100은 서로 다른 코드이고 코드 포인트 순서로 정렬되어야 합니다. SortRange에는 TXLSSortCompareEvent(function(const Left, Right: Variant): Integer of object로 선언)를 받는 오버로드가 있어 내장 비교 대신 이를 사용합니다
uses
  System.SysUtils, System.Variants, lxStandard, lxHandleX;

type
  TPartNumberOrder = class
    function Compare(const Left, Right: Variant): Integer;
  end;

function TPartNumberOrder.Compare(const Left, Right: Variant): Integer;
begin
  // 커스텀 비교자는 빈 셀도(Null로) 받습니다: 직접 배치하세요
  if VarIsNull(Left) or VarIsNull(Right) then
    Exit(Ord(VarIsNull(Left)) - Ord(VarIsNull(Right)));
  Result := CompareStr(VarToStr(Left), VarToStr(Right));   // ordinal, 대소문자 구분
end;

var
  Sheet: TXLSXWorksheet;   // 채워진 시트, 2..501행, A..D열
  Order: TPartNumberOrder;
begin
  // ...
  Order := TPartNumberOrder.Create;
  try
    // A열 기준 키, 오름차순
    Sheet.SortRange(2, 1, 501, 4, [1], [False], xlsSortByRows,
      xlsSortExcelLike, Order.Compare);
  finally
    Order.Free;
  end;
end;
커스텀 comparer를 쓰면 SortRange는 원시 키 값을 그대로 넘기고 빈 셀 배치를 호출자에게 맡기므로, 위 comparer가 먼저 Null을 처리하는 것입니다. 내림차순 키에서는 정렬이 comparer의 반환값을 뒤집으므로, comparer가 신경 쓰지 않으면 그 방향에서는 빈 셀이 맨 위로 갑니다. 이렇게 정렬한 열은 더 이상 근사 VLOOKUP이나 이진 탐색 XLOOKUP이 기대하는 순서가 아닙니다. 다르게 정렬된 데이터에서 이 모드들이 어떻게 잘못되는지는 XLOOKUP과 XMATCH 이진 탐색 모드 안내에서 다룹니다
같은 워크북이 다른 장비에서 다르게 정렬될 수 있는 이유
Excel의 텍스트 순서가 Windows 사용자 로캘에 의존하고 HotXLS가 그 의존성을 의도적으로 따르기 때문에, 같은 워크북이 다른 장비에서 다르게 정렬될 수 있습니다. 워드 정렬은 언어별 규칙입니다. 예컨대 스웨덴어 collation은 ä를 z 뒤에 두지만 영어와 독일어는 a 옆에 둡니다. 그래서 스톡홀름의 동료가 재계산한 파일은 시카고의 데스크톱에서 같은 파일이 돌려주는 COUNTIF(...,">y")와 다른 값을 낼 수 있습니다. HotXLS가 LOCALE_USER_DEFAULT를 넘기는 것은 같은 장비에서 Excel과 같은 답을 내기 위해서입니다. 임의의 고정 로캘을 박아 넣으면 더 깔끔해 보이겠지만, 설정이 다른 모든 장비에서 HotXLS가 Excel과 어긋나게 됩니다
서버 측 생성에는 세 가지 실무적 귀결이 있습니다:
- 중요한 로캘은 프로세스가 실행되는 계정의 것입니다. Windows 서비스나 IIS 애플리케이션 풀은 개발자 데스크톱과 지역 설정이 다를 수 있으므로, IDE에서 본 결과가 곧 프로덕션이 계산하는 것이라고 단정할 수 없습니다
- 파일에 기록된 캐시된 수식 결과는 생성 장비의 로캘을 반영합니다. Excel은 자기 로캘로 재계산하므로, 다른 곳에서 파일을 열어 재계산하면 값이 바뀔 수 있고, Excel 자신의 파일도 똑같이 동작합니다
- 로캘은 주로 악센트 문자, 어떤 언어에서는 한 글자로 묶이는 글자 쌍, 라틴 문자가 아닌 문자 체계에서 어긋납니다. 평범한 영어 단어로만 만든 테스트 데이터는 그 차이를 절대 드러내지 않으므로, 샘플에
Ångström,Öberg같은 이름을 몇 개 넣으세요
Excel에 맞는 경로는 Windows 쪽입니다. Delphi, C++Builder, Lazarus와 Free Pascal 어느 것으로 빌드했든 모든 Win32·Win64 빌드는 같은 CompareStringW를 호출합니다. 빌드 대상이 Windows가 아닌 플랫폼이면 XlsCompareText는 RTL의 WideCompareText를 쓰고, 그 순서는 해당 플랫폼 자체의 collation 라이브러리에서 옵니다
평범한 단어는 어떤 규칙에서도 똑같이 정렬됩니다. 그래서 잘못된 collation은 하이픈이 든 부품 코드, 문장 부호, 악센트가 붙은 고객 이름이 들어올 때까지 테스트를 통과한 채 살아남곤 합니다. HotXLS는 XLS와 XLSX 양쪽 엔진에서, 비교 연산자부터 SortRange까지, 이런 입력에 Excel의 답을 줍니다. 지원되는 Delphi·C++Builder 버전과 라이선스, 평가판 다운로드는 HotXLS Delphi Excel 컴포넌트 페이지에 정리돼 있습니다