HotXLS Delphi Component는 =1<2<3을 FALSE로 평가합니다. Excel 16이 주는 것과 같은 답입니다. v2.384.3부터 수식 파서가 비교 연산자를 왼쪽에서 오른쪽으로 접기 때문입니다. 1<2가 TRUE가 되고, TRUE<3은 boolean이 모든 숫자보다 위에 서므로 FALSE입니다. 같은 릴리스에서 빈 피연산자를 0과 "" 양쪽과 같게 취급하고, SUMIF가 한 셀 합계 범위를 조건 범위의 모양으로 늘리도록 했습니다. Delphi에서 계산한 워크북이 Excel에서 연 같은 워크북과 어긋나기 전까지는 전부 사소한 이야기로 보입니다
어긋남은 보통 직관으로 쓴 수식에서 시작합니다. 누군가 수량이 범위 안에 있는지 검사하려고 =0<B2<100을 입력하고, Excel은 모든 행에 조용히 FALSE라고 답하며, 그 버그가 구워진 채로 시트가 출하됩니다. 계산 엔진은 사용자 의도를 고칠 자격이 없습니다. 할 일은 Excel이 내놓을 값을 그대로 내놓아서, HotXLS가 파일에 기록하는 캐시 결과가 재계산 후 Excel이 보여 주는 것과 일치하게 만드는 것입니다. v2.384.3 이전 HotXLS는 그 범위 검사에 모든 행에서 TRUE라고 답했으니 반대 방향으로 틀렸고, 서버에서 생성한 리포트가 데스크톱에서 연 같은 리포트와 모순됐습니다
Excel에서 =1<2<3이 FALSE를 반환하는 이유는?
Excel이 FALSE를 돌려주는 이유는 비교 연쇄를 (1<2)<3으로 읽고, 내부의 TRUE가 숫자 3과의 타입 순위 경쟁에서 지기 때문입니다. 옛 HotXLS 파서는 같은 텍스트를 1<(2<3)으로 읽었습니다. lxFormula.pas의 TXLSSyntax.Parse_expr은 피연산자 하나를 파싱하고 비교 토큰을 보면 우변을 위해 Parse_expr로 재귀했으니, 연산자가 우결합이었던 것입니다. 그러면 1<TRUE가 되고 숫자는 boolean 아래이므로 결과는 TRUE였습니다. 실수는 대칭적이었습니다. =3>2>1은 Excel에서 TRUE이고 HotXLS에서는 FALSE였으며, =1=1=TRUE는 Excel에서 TRUE이고 수정 전에는 FALSE였습니다. 회귀 테스트 CalculateFormula_ComparisonChainsFoldLeftToRight는 그런 수식 일곱 개를 Excel 16이 반환하는 값에 고정하고, HotXLS 수식 엔진 개요에서 설명한 Calculate 메서드로 클래식 TXLSWorkbook과 XLSX 네이티브 TXLSXWorkbook 양쪽 엔진 아키텍처를 모두 거쳐 실행합니다
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Excel 16이 반환하는 값: FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate는 활성 시트를 대상으로 평가하고
    // 워크북에 시트가 전혀 없으면 Null을 반환합니다
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;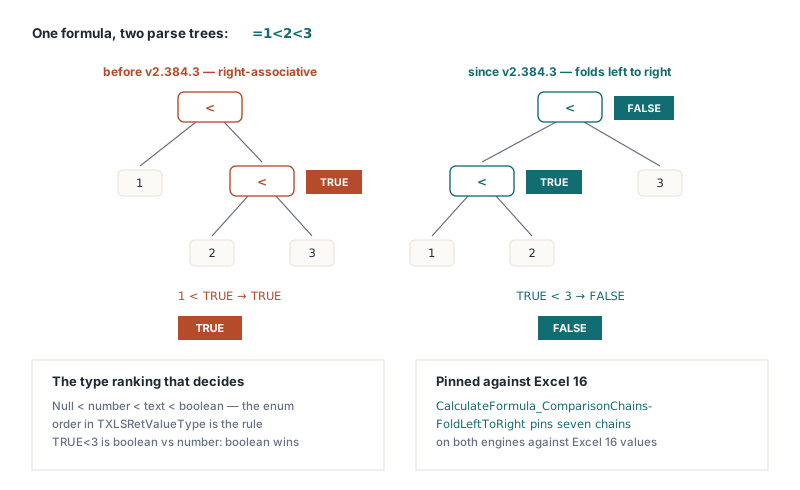
수정은 Parse_expr을 Parse_expr1이 이미 +, -, &에 쓰고 있는 것과 같은 모양의 루프로 바꿉니다. 첫 피연산자를 Parse_expr1로 파싱한 다음, 다음 토큰이 =, <>, <, >, <=, >= 중 하나인 동안 비교 노드를 만들고, 누적된 왼쪽 결과를 첫 자식으로 붙이고, Parse_expr 대신 Parse_expr1으로 다음 피연산자를 파싱한 뒤, 새 노드를 다음 라운드의 왼쪽 결과로 삼습니다. 재귀를 반복문으로 바꿀 때 틀리기 쉬운 디테일이 둘 있고, 둘 다 유지보수자 노트에 있습니다. 누적 노드는 그 순서 그대로 넘겨야 하고(lChild := Item; Item := nil), 오류 경로는 반쯤 만든 노드를 해제한 뒤 Exit해야지 루프를 빠져나가 매달린 트리를 돌려주면 안 됩니다
HotXLS는 비교에서 숫자, 텍스트, boolean을 어떻게 순위 매길까요?
HotXLS는 혼합 타입을 Excel과 같은 방식으로 순위 매깁니다. 모든 숫자는 모든 텍스트 값보다 작고, 모든 텍스트 값은 모든 boolean보다 작습니다. lxCalc.pas의 TXLSCalculator.CompareVariants는 GetRetValueType으로 양쪽 피연산자를 TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue) 열거형으로 분류하고, 두 클래스가 다르면 서수만 비교합니다. 그 열거형의 선언 순서가 곧 타입 간 규칙입니다. 같은 클래스 안에서의 비교는 자연스러운 비교이되 텍스트에 한해 Excel 특유의 비틀기가 하나 있습니다. 두 문자열이 먼저 lxUpperCase를 통과하므로 ="abc"="ABC"는 TRUE입니다. 이 순위가 있어야 연쇄 결과를 이해할 수 있습니다. TRUE<3은 TRUE를 1로 강제하는 게 아니라 boolean과 숫자의 비교이고, boolean이 이깁니다. 날짜는 엔진에게 serial number입니다(varDate는 xlNumberValue로 분류). 따라서 날짜는 우연히 날짜처럼 보이는 텍스트를 포함해 어떤 텍스트보다도 항상 아래입니다
비교에서 빈 셀은 무엇과 같을까요?
비교 피연산자로 쓰인 빈 셀은 상대가 숫자면 0과, 텍스트면 ""와, v2.384.53부터는 논리 값이면 FALSE와 같습니다. A1이 비어 있으면 =A1=0, =A1="", =A1=FALSE가 모두 TRUE입니다. 여섯 비교 연산자 모두를 서빙하는 TXLSCalculator.CompareVarValues는 CompareVariants를 호출하기 전에 빈 값을 치환합니다. 정확히 한쪽 피연산자가 Null이면, 짝이 문자열일 때는 WideString('')으로, 짝이 boolean일 때는 False로, 그 외에는 0으로 바뀝니다. 빈 셀 둘이 서로 비교할 때는 치환 없이 여전히 서로 같습니다. 산술 경로는 예전부터 빈 셀을 0으로 바꿨으니 =A1+1이 1을 준 이유이지만, CompareVariants는 Null을 모든 숫자 아래의 독자적인 최하위 순위로 유지했고 비교 연산자들은 그 순위를 직접 썼습니다
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // A1은 일부러 비워 둡니다

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: 빈 셀이 0으로 비교됩니다
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False. v2.384.3 전에는 True
end;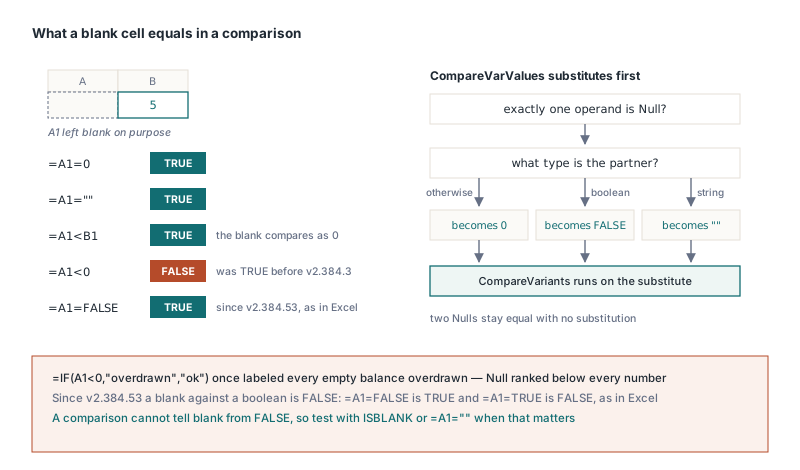
마지막 줄이 실전에서 아팠던 지점입니다. 옛 순위에서는 빈 셀이 음수를 포함한 모든 숫자보다 작았으므로, =IF(A1<0,"overdrawn","ok")는 비어 있는 잔액 셀을 모두 초액으로 표시했고, 사용자라면 모두 0이라고 부를 셀에서 =A1=0은 FALSE였습니다. v2.384.3 이후에도 한 경계는 남았습니다. 치환은 0과 빈 문자열 사이에서만 골랐으므로 boolean과 비교된 빈 값은 0이 되었고, 0은 TRUE와 FALSE 모두 아래 순위라서 빈 A1의 =A1=FALSE는 FALSE로 평가됐습니다. HotXLS 2.384.53부터는 논리 값과 비교되는 빈 값이 XLS와 XLSX 엔진 모두에서 Excel과 마찬가지로 FALSE로 취급됩니다. A1이 비어 있으면 =A1=FALSE와 =A1<TRUE는 TRUE를, =A1=TRUE는 FALSE를 반환합니다. 이는 비교가 빈 셀과 FALSE를 구별하지 못한다는 뜻이기도 합니다. Excel에서도 HotXLS에서도 마찬가지입니다. 시트가 그 구별을 필요로 한다면 ISBLANK나 =A1=""로 검사하세요
한 셀 합계 범위를 받은 SUMIF가 0을 반환한 이유는?
SUMIF가 0을 돌려준 이유는 HotXLS가 순회를 두 범위 중 작은 쪽에 맞춰 잘라 놓은 반면, Excel은 조건 범위의 모양을 유지하고 합계 범위는 좌상단 셀만 빌려 쓰기 때문입니다. 따라서 =SUMIF(A1:A10,">5",B1)은 Excel에서 B1:B10을 뜻하고, 손으로 만든 수많은 템플릿이 이 편의에 기대고 있습니다. 공용 워커 TXLSCalculator.GetValueItemRange2는 행과 열 개수를 값 범위에 맞춰 줄였으므로 예시가 A1 대 B1 한 번의 검사로 축소됐습니다. v2.384.3은 이 클램프를 제거합니다. 루프는 이제 조건 범위를 걸어 가며 합계 범위의 좌상단 모서리에서 같은 오프셋의 값을 읽습니다. CalcSumIF와 CalcAverageIF가 둘 다 그 워커를 부르므로 AVERAGEIF도 같은 리사이즈를 받고, 조건 범위보다 큰 합계 범위는 같은 이유로 조건 모양에 맞게 잘립니다. 가운데 조건 인수는 value 클래스, 바깥 둘은 reference 클래스입니다. 이 구별은 암시적 교차와 인수 클래스에 관한 글에서 다룹니다
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // 조건 열: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // 금액: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // 한 셀 합계 범위
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // 명시적 합계 범위
    if Book.Recalculate = lxOk then
      // D1과 D2 모두 4000 (600+700+800+900+1000). D1은 v2.384.3 전에는 0이었습니다
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;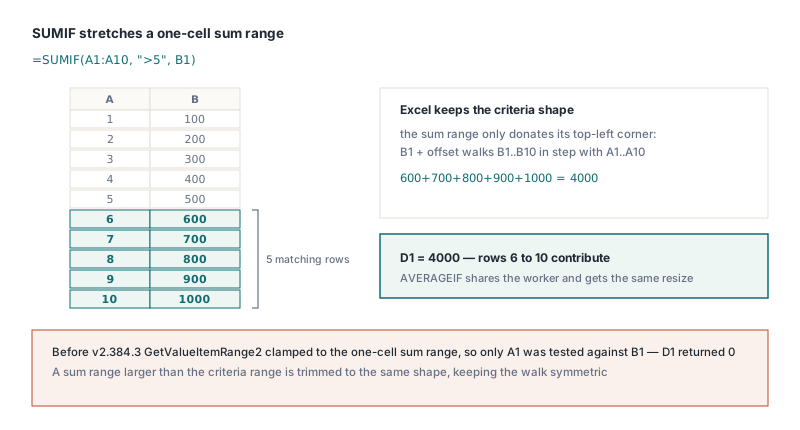
INDIRECT와 YEARFRAC: 더 조용한 두 가지 수정
INDIRECT는 이제 두 번째 인수를 존중하고, 유효한 참조 뒤에 텍스트가 남으면 무시되는 대신 오류입니다. a1이 FALSE이면 텍스트는 절대 R1C1로 파싱되므로 =INDIRECT("R2C3",FALSE)는 C2를 읽습니다. 옛 코드는 이 플래그를 무시하고 "R2"를 열 R, 행 2로 읽어 잘못된 셀을 조용히 돌려줬습니다. 플래그는 variant 타입(boolean, 숫자 또는 텍스트)으로 디스패치하는데, 문자열 variant를 Double로 곧바로 변환하면 예외가 뜨기 때문입니다. R[1]C[1] 같은 상대 R1C1 텍스트는 #REF!를 반환합니다. INDIRECT에는 이를 해석할 수식 셀 원점이 없고, 뒤에 문자가 붙은 A1 텍스트인 "B2 junk"도 #REF!를 반환합니다. basis 0의 YEARFRAC은 이제 DAYS360이 이미 구현해 둔 NASD 2월 말 규칙을 적용합니다. 두 날짜가 모두 2월 마지막 날이면 끝 날짜가 30이 되고, 이어서 시작이 2월 마지막 날이면 30이 됩니다. 2024-02-29부터 2025-02-28까지의 카운트는 이제 정확히 360일, 즉 1인 비율이고, 이전 Days360US는 359를 세었습니다
이 수정들이 보장하는 것과 교훈은 무엇일까요?
비교 연쇄 동작은 두 엔진을 Excel 16에서 측정한 값과 비교하는 테스트가 보장하고, 그 테스트가 존재하는 이유는 수정에 대한 첫 설명이 틀렸기 때문입니다. v2.384.3 릴리스 노트는 원래 왼쪽부터 접기가 =1<2<3을 TRUE로 만든다고 썼는데, 이는 옛 우결합 파서가 내놓던 정확히 그 답이자 Excel과 새 코드가 모두 반환하는 것의 반대입니다. 아무도 예시를 직접 평가하지 않았습니다. "1은 2보다 작고 2는 3보다 작다"는 직관에서 적어 낸 것이었습니다. 노트는 고쳐졌고 일곱 수식 테스트가 후속 커밋으로 추가됐습니다. 여기서 나온 규칙은 스프레드시트 의미론을 문서화하는 모든 사람에게 적용됩니다. 기대값을 적기 전에 Excel에서 예시를 돌려 보세요. 빈 피연산자 치환과 SUMIF 리사이즈도 같은 Excel 동작을 따릅니다(v2.384.53부터는 빈 값 대 boolean 케이스 포함). 필터된 행이나 숨겨진 행까지 건너뛰어야 하는 조건부 집계는 SUBTOTAL과 AGGREGATE 숨겨진 행 글의 별도 규칙을 따릅니다
HotXLS는 Excel 설치 없이 XLS, XLSX, ODS, CSV를 읽고 재계산하고 쓰는 네이티브 Delphi, C++Builder 스프레드시트 컴포넌트이며, 여기 설명한 비교·빈 셀·SUMIF 규칙은 두 워크북 아키텍처가 공유하는 계산 엔진에 삽니다. 전체 함수 목록과 라이선스 옵션은 HotXLS Delphi 스프레드시트 컴포넌트 제품 페이지에 있습니다