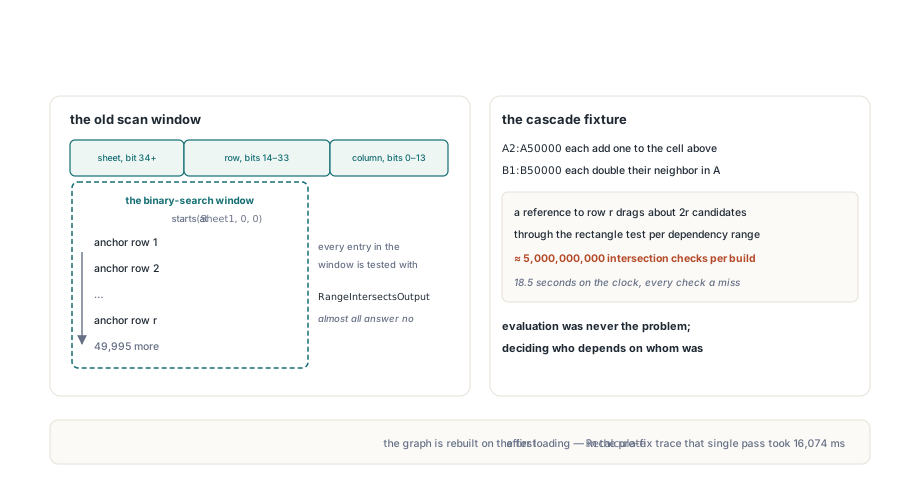
A열에 50,000개 수식이 각각 바로 위 셀에 1을 더하고, B열에 50,000개 수식이 각각 이웃을 두 배로 만드는 시트는 스프레드시트 모델로서 더할 나위 없이 평범합니다. 평가에는 덧셈과 곱셈 100,000번이 듭니다. 그런데 엣지 빌더가 흔히 짜는 방식대로라면 평가 순서를 계산하는 일이 훨씬 더 듭니다. 참조된 시트 맨 위에서 참조된 행까지 모든 수식을 훑고, 하나하나 겹침을 검사하고, 걸린 것만 남기는 방식입니다. 이 한 시트에서만 대략 50억 번의 사각형 검사가 나오고, 그중 거의 전부가 "아니오"로 답합니다
50억은 산술이지 스톱워치 수치가 아닙니다. 행 r에 대한 참조는 약 2r개의 후보를 검색 창으로 끌어들입니다. 위쪽 모든 행의 열마다 하나씩이고, 이를 참조 100,000개에 걸쳐 더하면 수십억이 됩니다. 흥미로운 점은 이 창이 정말로 시트 맨 위에서 시작해야 한다는 것인데, 게으름과는 아무 상관이 없는 이유에서입니다
의존성 리빌드는 시간을 어디에 쓰나
HotXLS 재계산 엔진은 수식 토폴로지가 바뀔 때마다 수식 의존성 그래프를 다시 만듭니다. 통합 문서를 로드하거나 생성한 뒤 첫 Recalculate, 수식을 다시 쓰거나 시트를 추가/삭제하거나 셀 블록을 복제한 뒤의 첫 번째가 그렇습니다. 두 워크북 클래스 TXLSWorkbook와 TXLSXWorkbook 모두 이를 위해 유닛 lxDepGraph의 TXLSDepGraph를 만듭니다. 수식 셀마다 앵커(Row, Col)와 (OutRow2, OutCol2)까지 이어지는 출력 사각형을 가진 노드 하나가 됩니다. 평범한 수식이라면 사각형은 앵커 셀 자신입니다
노드는 XLSDepMakeKey가 만드는 패킹된 64비트 키로 정렬됩니다. 열은 비트 0–13, 행은 비트 14–33, 시트 인덱스는 비트 34 이상입니다. 이 키로 정렬하면 시트 우선, 행 우선 순서가 되므로, 참조에 관련될 수 있는 마지막 수식은 (Sheet2, Row2, 16383)에 대한 이진 탐색 한 번으로 찾습니다. 문제는 첫 번째입니다. 하한은 (Sheet1, 0, 0), 즉 참조된 시트의 맨 꼭대기여야 하고, 두 경계 사이의 모든 것이 후보가 됩니다
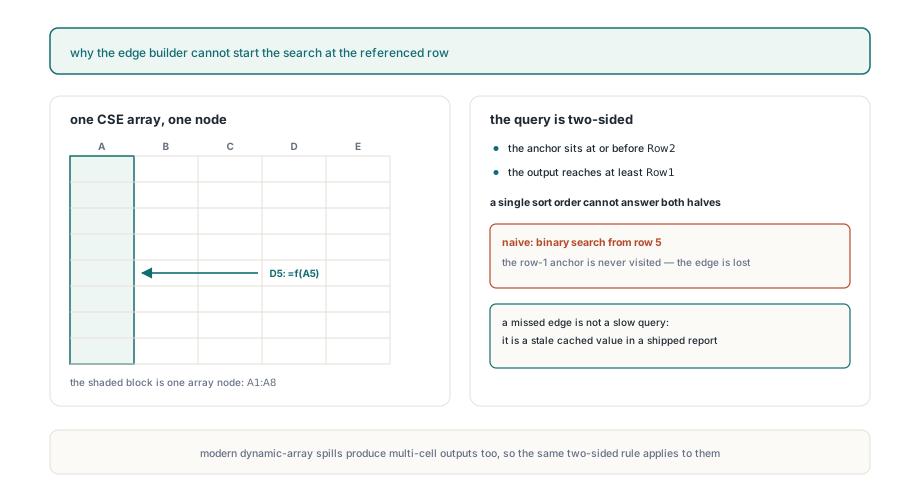
왜 검색은 참조된 행에서 시작하지 못할까요?
범위보다 위에 앵커된 배열 수식이 그 안의 셀을 소유할 수 있습니다. TXLSXWorkbook에서 A1:A8에 입력한 CSE 배열은 앵커가 A1이고 출력이 8행까지 내려가는 노드 하나인데, 증분 재계산과 의존성 그래프 글이 설명합니다. A5만 읽는 D5의 수식도 그 노드에서 엣지를 받아야 합니다. 이진 탐색을 5행에서 시작하면 1행의 앵커는 영영 방문되지 않고 엣지도 기록되지 않으며, D5가 자기가 의존하는 배열보다 먼저 평가될 수 있습니다. 증상은 저장된 워크북에 남는 낡은 캐시 값으로, 느린 재계산보다 알아차리기 훨씬 어렵습니다
그래서 실제 질의는 양면입니다. 앵커가 Row2 이전이고 출력이 적어도 Row1에 닿는 노드, 참조된 시트 안에 있고 열이 겹치는 노드가 후보입니다. 앵커 정렬은 전반부에 답합니다. 후반부에 대해서는 앵커 순서가 아무 말도 하지 않습니다. 3행의 수식이 셀 하나를 출력할 수도 만 행을 출력할 수도 있기 때문입니다. What-if 데이터 테이블도 같은 모양입니다. TXLSXWorkbook은 각 데이터 테이블을 결과 영역 전체를 커버하는 노드 하나로 등록합니다. 동적 배열 수식은 다른 길을 가서 휘발성(volatile)으로 표시되며 매 패스마다 다시 계산됩니다. 동적 배열 spill 수식 글이 spill 범위의 동작을 다룹니다
TXLSDepGraph는 공개 클래스이므로 워크북 없이도 이 사례를 쉽게 재현할 수 있습니다. 시트 인덱스는 1 기반이고 행과 열은 0 기반이며, 계산기 좌표와 일치합니다. 아래 프로브는 배열 루트와 리더를 등록하고 엣지를 만든 다음, 같은 그래프 타입으로 역순 점 참조 체인도 돌려 다음 절들이 의존하는 카운터를 보여줍니다
uses
  System.SysUtils, lxDepGraph;

function PointRef(ASheet, ARow, ACol: Integer): TXLSDepRange;
begin
  Result.Sheet1 := ASheet;
  Result.Sheet2 := ASheet;
  Result.Row1 := ARow;
  Result.Row2 := ARow;
  Result.Col1 := ACol;
  Result.Col2 := ACol;
  Result.LookupScan := False;
end;

procedure ProbeOutputIndex;
const
  N = 100000;
var
  G: TXLSDepGraph;
  Deps: TXLSDepRangeList;
  Reader, Row: Integer;
begin
  Deps := TXLSDepRangeList.Create;
  G := TXLSDepGraph.Create;
  try
    // CSE 배열: 앵커 A1 (행 0, 열 0), 출력은 A8(행 7)까지
    G.AddNode(1, 0, 0, 7, 0, False, nil);
    // D5(행 4, 열 3)는 A5만 읽음
    Deps.Add(PointRef(1, 4, 0));
    Reader := G.AddNode(1, 4, 3, 4, 3, False, Deps);
    G.BuildEdges;
    Writeln('D5 precedents: ', G.Nodes[Reader].PrecedentCount);  // 1, A1 루트
    Writeln('rectangles tested: ', G.EdgeCandidateChecks);       // 2: A1 루트와 D5 자신
  finally
    G.Free;
  end;

  // A1..A100000 체인, 각 셀이 위 셀을 읽고, 아래에서 위로 추가
  G := TXLSDepGraph.Create;
  try
    for Row := N - 1 downto 0 do
    begin
      Deps.Clear;
      if Row > 0 then
        Deps.Add(PointRef(1, Row - 1, 0));
      G.AddNode(1, Row, 0, Row, 0, False, Deps);
    end;
    G.BuildEdges;
    Writeln('chain checks: ', G.EdgeCandidateChecks);  // N - 1 = 99999
  finally
    G.Free;
    Deps.Free;
  end;
end;
최대 출력 행으로 서브트리 가지치기
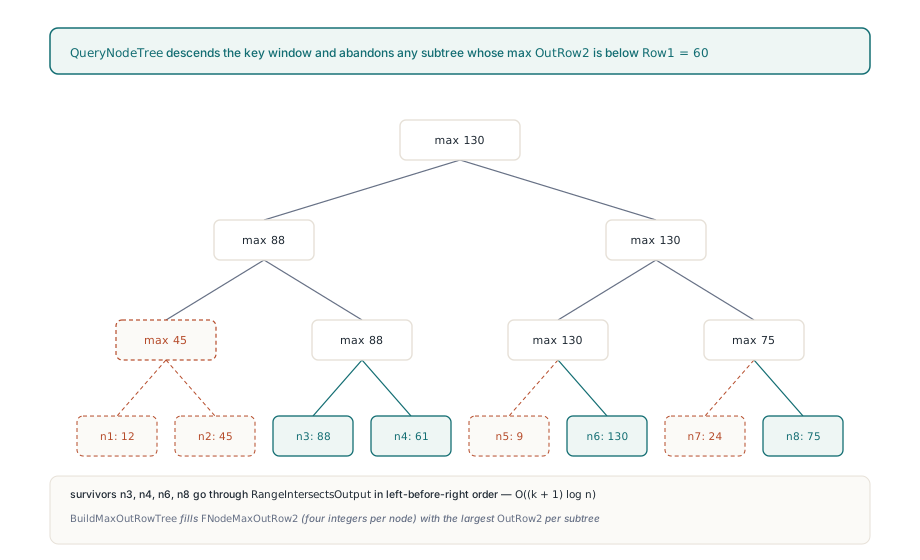
TXLSDepGraph.BuildEdges는 상한을 위해 앵커 정렬을 유지하고, 하한은 정렬 순서 위에 놓인 max 증강 세그먼트 트리로 답합니다. 각 트리 항목은 자기 아래 노드들의 최대 OutRow2를 저장합니다. 질의는 키 창 안에서만 내려가고, 저장된 최댓값이 Row1에 닿지 못하는 서브트리는 버립니다. 그 서브트리의 어떤 수식도 참조된 행에 도달할 수 없기 때문입니다. 살아남은 노드는 여전히 전체 사각형 검사를 거치므로, 시트 범위와 열은 예전과 똑같이 확인됩니다
기법 자체는 통째로 보여줄 수 있을 만큼 작습니다. 아래 스케치는 이 글을 위해 쓴 최소 버전으로 이름은 제 것입니다. HotXLS API가 아니며, 배열은 앵커 키로 이미 정렬된 출력 행 목록에서 읽는 사람이 채웁니다
uses
  System.Math, System.Generics.Collections;

// 스케치일 뿐: 앵커 키로 정렬된 노드 위의 max 증강 세그먼트 트리.
// OutRow2[i]는 정렬 순서에서 i번째 노드의 마지막 출력 행.
type
  TOutputIndex = record
    OutRow2: TArray<Integer>;
    MaxRow: TArray<Integer>;   // SetLength(MaxRow, 4 * Length(OutRow2))
  end;

procedure BuildMax(var Ix: TOutputIndex; Node, L, R: Integer);
var
  M: Integer;
begin
  if L = R then
  begin
    Ix.MaxRow[Node] := Ix.OutRow2[L];
    Exit;
  end;
  M := (L + R) shr 1;
  BuildMax(Ix, Node * 2, L, M);
  BuildMax(Ix, Node * 2 + 1, M + 1, R);
  Ix.MaxRow[Node] := Max(Ix.MaxRow[Node * 2], Ix.MaxRow[Node * 2 + 1]);
end;

// [Lo, Hi) 안에서 출력이 Row1에 닿는 모든 노드를 왼쪽부터 오른쪽으로 수집
procedure Query(const Ix: TOutputIndex; Node, L, R, Lo, Hi, Row1: Integer;
  Hits: TList<Integer>);
var
  M: Integer;
begin
  if (R < Lo) or (L >= Hi) or (Ix.MaxRow[Node] < Row1) then
    Exit;                        // 창 밖이거나 Row1에 닿는 것이 없음
  if L = R then
  begin
    Hits.Add(L);                 // 호출자가 여전히 전체 사각형 검사를 돌림
    Exit;
  end;
  M := (L + R) shr 1;
  Query(Ix, Node * 2, L, M, Lo, Hi, Row1, Hits);           // 왼쪽 먼저
  Query(Ix, Node * 2 + 1, M + 1, R, Lo, Hi, Row1, Hits);   // 스캔 순서를 유지
end;

// BuildMax(Ix, 1, 0, Count - 1)로 한 번 빌드하고,
// 참조마다 Query(Ix, 1, 0, Count - 1, Lo, Hi, Row1, Hits)를 호출
참조당 작업량이 창 크기에서 O((k + 1) log n)으로 떨어집니다. k는 출력이 실제로 참조된 행에 닿는 노드 수입니다. 도입부 모델로 돌아가면, Br에서 Ar로 가는 참조는 이제 사각형 두 개, 즉 Ar와 Br 자신만 검사하고, Ar에서 위 셀로 가는 참조는 그 행의 두 노드를 검사합니다. 손 계산으로도 전체 빌드는 약 200,000회로 끝나고, 50억은 나오지 않습니다
같은 엣지, 같은 순서
왼쪽 먼저 재귀는 겉보기보다 중요합니다. 살아남은 노드는 창 위의 평범한 루프가 방문하는 순서와 정확히 같은 순서로 방문되므로, 각 노드의 Dependents와 Precedents 배열이 같은 순서로 채워지고 그로부터 만드는 위상 정렬 순서도 매번 같게 나옵니다. 그 순서는 내부 장부 이상의 의미가 있습니다. 그래프가 최신일 때 XLSX 라이터는 xl/calcChain.xml을 FullTopoOrder가 돌려주는 순서로 기록하므로, 비결정적 방문 순서는 변하지 않은 워크북의 두 저장 사이에 시끄러운 diff로 드러납니다
엣지 종류의 규칙도 유지됩니다. VLOOKUP, MATCH, XLOOKUP 등의 lookup-array 인자에 놓인 참조는 lookup-scan 엣지를 만드는데, dirty는 전파하되 순환 검출에는 들어가지 않습니다. 한 노드가 같은 precedent에 hard 참조와 lookup 참조를 모두 가지면, 먼저 기록된 hard 엣지가 나중 scan 엣지를 누르고, scan 엣지가 먼저 기록됐다면 제 자리를 지키면서 hard 엣지는 그래도 추가됩니다. lookup 범위가 가짜 순환 참조를 만들지 못하게 하는 것이 바로 이 순서 규칙이고, 가지치기된 순회가 후보를 스캔 순서로 방문할 때만 성립합니다
EdgeCandidateChecks 속성이 가지치기를 관측 가능하게 만듭니다. 최근 BuildEdges 호출이 실제로 검사한 출력 사각형 수를 세며 빌드가 시작될 때마다 리셋합니다. 위 프로브에서 역순 체인은 노드를 아래에서 위로 추가했고 정렬이 전부 재배치해야 했는데도 참조당 검사 한 번, 99,999를 보고합니다. AddNode는 정렬과 엣지를 모두 stale로 표시하므로, 다음 BuildEdges나 NodeIndexOf는 인덱스를 덧대지 않고 다시 만듭니다
남은 비용이 있는 곳
트리는 행으로만 가지치기를 하며, 그 선택이 큰 모델이 여전히 지불할 비용의 모양을 정합니다
- 열 미스는 여전히 잎에서 지불됩니다.
A100:Z200을 채우는 2,626개 수식은 전부 100행에 닿으므로,AA100:AA200참조는 각각을 거부하기 전에 검사합니다 - 열 전체 범위 같은 넓은 참조는 실제로 precedent가 많습니다. 인덱스는 낭비되는 검사를 없애는 것이지 진짜 엣지를 없애는 게 아니고, 그 엣지를 만드는 비용은 여전히 개수에 비례합니다
- 여러 시트에 걸친 참조는 첫 시트 전체를 커버하는 창을 열므로, 그 시트의 출력이 깊은 수식들은 잎 검사까지 도달합니다. 엣지 결과는 같고 가지치기만 약해집니다
- 트리는 노드당 정수 네 개, 수식 100,000개에 약 1.6MB이며, 토폴로지가 바뀌면 다음 엣지 빌드에서 완전한 O(n log n) 재정렬과 O(n) 트리 빌드를 치릅니다
행이야말로 인덱싱할 단일 차원으로 맞습니다. 생성되는 보고서, 원장, 재무 모델은 아래로 자라므로 낭비되는 후보의 거의 전부가 행 거리에서 나오고, 열 미스는 몇 번의 정수 비교로 사각형 검사가 거부합니다. 트리에 차원을 하나 더하면 이미 싼 검사를 아끼려고 모든 질의를 복잡하게 만듭니다
호출하는 쪽에서 비싼 단계는 리빌드이고, 값 편집은 그것을 유발하지 않습니다. Recalculate는 첫 호출에서 그래프를 만들고, 이후 호출은 바뀐 값의 하류 수식과 휘발성 수식만 다시 평가합니다. 수식을 전부 쓰고 재계산은 한 번만 도는 패턴이 목표입니다. 아래 하니스는 클래식 엔진에서 두 종류의 패스를 측정합니다. 클래식 엔진의 Recalculate는 평가하지 못한 수식 셀 수를 돌려주며, 절대 시간은 기계에 크게 좌우되므로 배치 잡을 올릴 하드웨어에서 돌리세요
uses
  System.SysUtils, System.Diagnostics, lxHandle;

procedure TimeCascadeRecalc;
var
  Wb: TXLSWorkbook;
  Sh: TXLSWorksheet;
  I, Failed: Integer;
  Watch: TStopwatch;
begin
  Wb := TXLSWorkbook.Create;
  try
    Sh := Wb.Sheets.Add;
    Sh.Cells[1, 1].Value := 1;
    for I := 2 to 50000 do                     // A열의 49,999 링크 체인
      Sh.Cells[I, 1].Formula := '=A' + IntToStr(I - 1) + '+1';
    for I := 1 to 50000 do                     // B열의 50,000개 dependent
      Sh.Cells[I, 2].Formula := '=A' + IntToStr(I) + '*2';

    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // 그래프를 만들고 전부 평가
    Writeln(Format('first pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));

    Sh.Cells[1, 1].Value := 10;                // 값 편집: 그래프 재사용
    Watch := TStopwatch.StartNew;
    Failed := Wb.Recalculate;                  // dirty 서브그래프만
    Writeln(Format('value pass: %d not evaluated, %.1f ms',
      [Failed, Watch.Elapsed.TotalMilliseconds]));
  finally
    Wb.Free;
  end;
end;
이 모델에서 값 패스도 여전히 99,999개 수식을 모두 다시 평가합니다. A열 전체가 A1에 매달려 있기 때문이고, 생략되는 것은 그래프 빌드입니다. 수식 셀을 평범한 값으로 덮어쓰는 것은 다른 문제입니다. 토폴로지가 바뀌므로 다음 Recalculate는 그래프를 처음부터 다시 만듭니다
복제된 정의 이름에서도 같은 2차 형태
보고서 밴드는 같은 패턴을 다른 장소에 숨겨 둡니다. TXLSXWorksheet.CloneRangeTo는 복제 블록 안의 범위를 곧장 가리키는 정의 이름을 복사하는데, 사본마다 자기 스코프에서 유일한 이름이 필요합니다. Total_2, Total_3 식으로요. 사본마다 _2부터 검색을 다시 시작하면 그때마다 후보 하나씩 더 probe하므로, 수백 개의 복제 밴드로 이루어진 시트는 이름 짓기만으로 2차 횟수의 이름 조회를 지불합니다
TXLSXDefinedNames는 이름 인덱스에 접미사 힌트를 keep해서 이것을 피합니다. base 이름과 스코프당 하나씩입니다. 다음 검색은 마지막에 반환된 접미사부터 시작해 그것을 먼저 다시 검사합니다. 호출자가 그 이름을 실제로 추가하지 않을 수도 있기 때문입니다. 이름을 삭제하거나 Name으로 이름을 바꾸거나 SheetIndex로 옮기거나 컬렉션을 비우면 인덱스가 모든 힌트와 함께 버려지므로, 다음 복제는 첫 번째 자유 접미사로 돌아가 변경이 열어 둔 구멍을 채웁니다
Delphi나 C++Builder 애플리케이션이 큰 Excel 통합 문서를 생성하거나 재계산한다면, Delphi 및 C++Builder용 HotXLS Excel 컴포넌트의 재계산 엔진이 이 인덱싱된 의존성 그래프를 클래식과 XLSX 통합 문서 클래스 양쪽에 실어 제공합니다