크롭된 PDF 페이지에서 비트맵 픽셀을 렌더러가 실제로 래스터화한 박스, 즉 MediaBox로 잘린 CropBox(ISO 32000-1 §14.11.2)가 아니라 MediaBox로 되사상하면, OCR 텍스트 레이어와 바코드 경계, 얼굴 가림 처리 박스가 어긋납니다. HotPDF는 ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes, DetectLoadedRedactionFindings의 결과를 그 보이는 박스로 사상하며, 여러분이 작성하는 커스텀 엔진이나 탐지기도 같은 일을 해야 합니다
한 번 보면 증상은 알아보기 쉽습니다. 스캔된 계약서 아카이브가 OCR 파이프라인을 통과하고, 출력은 검색 가능한데, 조항 번호의 검색 히트가 인쇄된 번호에서 반 인치 아래 왼쪽에 하이라이트됩니다. 배치 안의 대부분 파일은 멀쩡합니다. 어긋난 것들은 전부 플랜 여백을 잘라 내려고 /CropBox를 쓰는 한 스캔 스테이션에서 왔습니다. 그 한 가지 세부가 OCR 엔진이 본 그림과 텍스트 레이어가 놓인 프레임을 갈라놓고, 같은 불일치가 바코드 경계를, 더 심각하게는 얼굴 가림 박스를 움직입니다
OCR 텍스트 레이어는 왜 스캔된 단어에서 흘러갈까?
텍스트 레이어는 파이프라인의 두 절반이 비트맵이 어느 사각형을 덮는지에 대해 엇갈릴 때 흘러갑니다. HotPDF의 렌더링, SVG 익스포트, 뷰어, 인쇄는 모두 CropBox를 따릅니다. 페이지는 MediaBox로 잘린 자기 CropBox를 통해 표시되는데, 이것이 ISO 32000-1 §14.11.2가 명세하는 것이고, GetLoadedPageVisibleBox는 그 보이는 박스를 반환합니다. 반면 GetLoadedPageBox(PageIndex, pbMediaBox, ...)에서 만든 디바이스-페이지 변환은 래스터가 MediaBox를 덮는다고 가정하므로, 래스터와 변환이 서로 다른 사각형을 기술하고 인식된 모든 위치는 둘 사이의 간격만큼 밀려 돌아옵니다
이것을 올바르게 하려면 인식 기능마다 세 가지를 일치시켜 유지해야 합니다. 변환, 픽셀 예산 추정, 그리고 요청 레코드가 커스텀 엔진에 넘기는 페이지 박스입니다. HotPDF는 세 가지 모두를 보이는 박스에서 유도하는데, 덕분에 인식은 뷰어가 실제로 보여 주는 콘텐츠만 봅니다
몇 가지 케이스는 이 불일치에 면역입니다:
/CropBox가 없는 페이지나 CropBox가 MediaBox와 같은 페이지는 어느 쪽 박스로도 똑같이 사상됩니다HasRegion이 설정된DecodeLoadedPageBarcodes는 넘긴 region을 정확히 렌더링하고 그 같은 region으로 사상합니다. region이 페이지 안에 있는지 검사는 MediaBox를 씁니다- 패턴 기반 가림 처리 발견(이메일, 카드 번호 등)은 래스터가 아니라 사용자 공간의 텍스트 추출에서 나오므로, 래스터 사상에 의존하는 것은 얼굴 탐지 발견뿐입니다
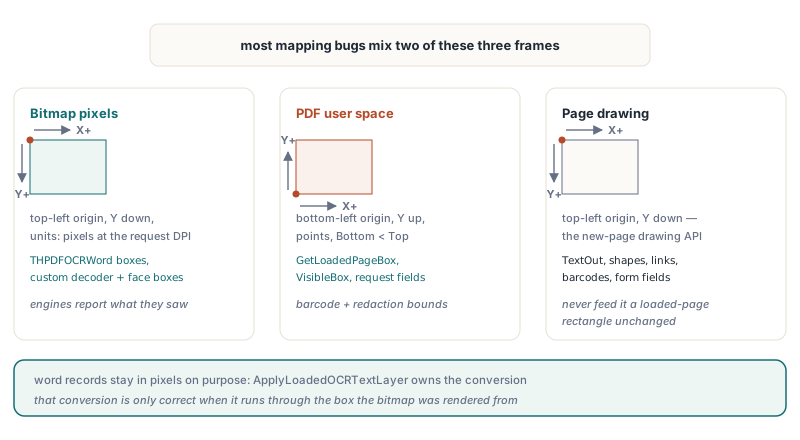
세 좌표 프레임, 그리고 어떤 HotPDF API가 각각을 쓰나
HotPDF 인식을 건드리는 코드는 세 프레임을 다루고, 대부분의 사상 오류는 그중 둘을 섞는 데서 옵니다
- 비트맵 픽셀: 왼쪽 위 원점, Y는 아래로 증가, 단위는 요청 DPI의 픽셀입니다.
THPDFOCRWord.Left,Top,Right,Bottom이 이 프레임에 있고, 선택적 baseline 점들과 커스텀IHPDFBarcodeDecoder가 반환하는 결과, 커스텀IHPDFFaceDetector의 박스도 그렇습니다 - 불러온 페이지의 PDF 사용자 공간: 왼쪽 아래 원점, Y는 위로 증가, 단위는 포인트이며
Bottom < Top입니다.GetLoadedPageBox와GetLoadedPageVisibleBox는 이 프레임의 Left, Bottom, Right, Top을 반환하고,THPDFOCRRequest의PageLeft,PageBottom,PageRight,PageTop필드와THPDFDecodedBarcode의 경계,THPDFRedactionFinding의 사각형도 그렇습니다 - HotPDF 페이지 그리기 좌표: 새 페이지를 만드는 API(텍스트 출력, 도형, 바코드, 링크, 폼 필드)는 왼쪽 위 원점과 아래로 증가하는 Y로 동작합니다. 그 프레임은 문서 생성의 것이고 위의 불러온 문서 API들과는 아무 상관이 없으므로, 불러온 페이지의 사용자 공간 사각형을 그대로 넣지 마세요
OCR 워드 레코드는 일부러 픽셀 기반입니다. 엔진은 이미지에서 본 것을 보고하고, 변환은 ApplyLoadedOCRTextLayer가 소관합니다. 그 나눔은 변환이 올바른 박스를 쓸 때만 성립하는데, 그래서 HotPDF는 그 박스를 보이는 박스에서 만듭니다
OCR, 바코드, 얼굴 뒤의 디바이스-페이지 변환
HotPDF는 다섯 입력, 즉 회전, 스케일 DPI / 72, 비트맵 높이, 그리고 렌더링된 박스의 Left, Bottom, Right, Top으로 만든 하나의 어파인 행렬로 비트맵 픽셀을 페이지에 사상합니다. OCR, 바코드 디코딩, 얼굴 탐지가 모두 한 루틴을 공유하므로, 박스 입력 하나가 셋의 정확도를 한꺼번에 결정합니다. 회전하지 않은 페이지의 페이지-디바이스 행렬 [A B C D E F]는 다음과 같습니다:
A = Scale이고D = -Scale이며,Scale = DPI / 72입니다. 음수D가 사용자 공간(Y 위)을 비트맵 공간(Y 아래)으로 뒤집습니다B = C = 0입니다. 회전하지 않은 페이지에는 축 사이의 전단이나 교환이 없으니까요E = -Left * Scale은 박스의 왼쪽 모서리를 픽셀 열 0으로 옮깁니다F = BitmapHeight + Bottom * Scale은 박스의 아래 모서리를 비트맵의 아래 모서리인 y = BitmapHeight로 사상해 위쪽 모서리가 행 0에 착지하게 합니다
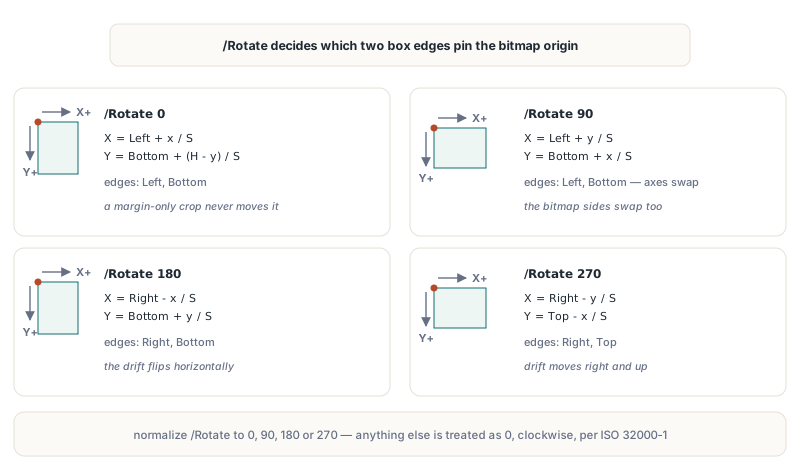
픽셀은 그 행렬의 역행렬을 통해 페이지로 돌아갑니다. Request.PageRotation은 페이지의 /Rotate를 0, 90, 180, 270으로 정규화해 실어 나르고(90의 배수가 아닌 값은 0으로 취급), 렌더러는 ISO 32000-1 §7.7.3.3이 요구하는 대로 페이지를 시계 방향으로 돌립니다. 회전 아래에서는 축이 교환되고 다른 모서리 쌍이 비트맵 원점에 고정됩니다. 역공식으로 쓰면, S = DPI / 72, x와 y는 픽셀, H는 비트맵 높이입니다:
| /Rotate | 페이지 X | 페이지 Y | 사상이 의지하는 박스 모서리 |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
마지막 열이 MediaBox 기반 사상이 프로덕션에서 무작위로 보이는 이유를 설명합니다. 페이지의 위만 자르는 CropBox는 Left와 Bottom을 그대로 두므로 바른 페이지는 완벽하게 나오고 /Rotate 270을 단 페이지만 흘러갑니다. 회전은 비트맵 치수도 교환합니다. 90과 270에서 비트맵은 폭 (Top - Bottom) * S 픽셀, 높이 (Right - Left) * S 픽셀입니다
MediaBox [0 0 612 792], CropBox [36 36 576 756]에서 무엇이 잘못될까?
모든 변에서 반 인치씩 잘렸을 때 MediaBox를 쓰면 회전하지 않은 페이지의 텍스트 레이어는 스캔된 단어에서 정확히 36포인트 왼쪽 아래에 착지합니다. 각 모서리에서 36포인트(0.5인치)를 자르는 CropBox를 가진 US Letter 페이지를 봅시다. 보이는 박스는 540 x 720 포인트이므로, 기본 OCR 해상도 300 DPI에서 스케일은 300 / 72 ≈ 4.1667이고 비트맵은 2250 x 3000 픽셀입니다
엔진이 픽셀 박스 Left 450, Top 600, Right 900, Bottom 660이고 baseline 없는 워드를 보고했다고 합시다. HotPDF는 이어서 baseline을 워드 높이의 20퍼센트만큼 아래 모서리 위, 픽셀 행 648에 놓고 시작점 (450, 648)을 사상합니다:
- 보이는 박스로: x = 36 + 450 / 4.1667 = 144.0, y = 36 + (3000 - 648) / 4.1667 = 600.48, 워드가 인쇄된 곳입니다
- MediaBox로: x = 0 + 108.0 = 108.0, y = 0 + 564.48 = 564.48, (-36, -36) 포인트의 균일한 이동입니다
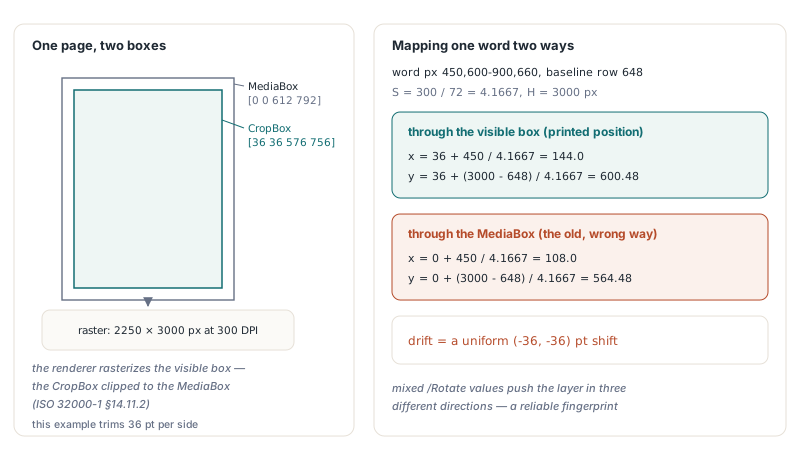
같은 페이지를 회전하면 오류의 방향이 바뀝니다. 다른 모서리가 개입하기 때문입니다. /Rotate 180에서는 X 항이 Right를 쓰고, 576 대신 612가 레이어를 36포인트 오른쪽으로 밀면서 Bottom은 여전히 36포인트 아래로 당깁니다. /Rotate 270에서는 Right와 Top이 모두 너무 커서 레이어가 36포인트 오른쪽, 36포인트 위로 움직입니다. 방향이 섞인 문서는 드리프트를 세 방향으로 보여 줄 수 있는데, 이 실수의 믿을 만한 지문입니다. Bitmap.Width / (Right - Left)처럼 박스에서 스케일을 유도하는 손작성 코드는 오프셋 위에 모든 좌표를 612 / 540, 대략 13퍼센트씩 늘리기도 합니다
여러분의 어떤 PDF 페이지가 CropBox 인식 사상이 필요할까?
적어도 한 페이지가 MediaBox와 다른 보이는 박스를 가지면 PDF 문서는 주의가 필요하고, HotPDF는 그것을 몇 줄로 알려 줄 수 있습니다. 모든 페이지에 대해 pbMediaBox를 단 GetLoadedPageBox를 GetLoadedPageVisibleBox와 비교하고, 위 표에서 드리프트 방향을 예측할 수 있게 GetLoadedPageRotation을 곁들여 찍으세요. THPDFPageBoundary는 pbCropBox, pbBleedBox, pbTrimBox, pbArtBox도 제공하지만, GetLoadedPageBox(pbCropBox)는 crop box가 없으면 MediaBox로 폴백하고 잘라 내지 않으므로, 비교 대상으로 옳은 것은 보이는 박스입니다
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // 저장된 배열은 모서리를 어떤 순서로든 나열할 수 있음
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // 이미 정규화되고 MediaBox로 잘림
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
이런 스크립트에서 GetLoadedPageVisibleBox의 세부 두 가지가 중요합니다. 이 함수는 실패할 때 out 파라미터를 그대로 두므로, 호출 전에 기본 페이지 크기를 미리 정해 두는 것이 안전한 패턴입니다. 그리고 malformed CropBox가 MediaBox와 전혀 교차하지 않을 때 함수는 빈 사각형 대신 MediaBox를 반환합니다. 리포트가 MediaBox 기반 사상으로 OCR을 거친 페이지들을 나열한다면, 커밋된 텍스트 레이어는 저장된 파일에 남는다는 점을 기억하세요. 기본 SkipPagesWithText 옵션은 끄거나 오래된 레이어를 먼저 제거하지 않는 한 두 번째 패스에서 그 페이지들을 건너뜁니다
커스텀 IHPDFOCREngine은 픽셀을 PDF 공간으로 어떻게 되사상해야 할까?
커스텀 IHPDFOCREngine은 워드 박스를 비트맵 픽셀로 반환하고 HotPDF에게 사상을 맡겨야 합니다. 사용자 공간으로의 변환은 자기 판단을 위해서만 하고, 그때도 요청의 박스를 쓰지 MediaBox를 쓰지 마세요. 요청의 PageLeft, PageBottom, PageRight, PageTop은 렌더링된 보이는 박스를 기술하므로 Request.Bitmap과 정확히 일치합니다. 아래 헬퍼는 라이브러리 변환의 역입니다. 바른 페이지에 실제 비트맵 높이를 쓰는 것까지 포함해서, HotPDF와 픽셀 단위까지 일치합니다
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// 비트맵 픽셀(왼쪽 위 원점, Y 아래)에서 PDF 사용자 공간으로,
// (왼쪽 아래 원점, Y 위), 비트맵이 렌더링된 박스를 통과해
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
엔진 안에서 사용자 공간이 필요한 현실적인 이유는 존 규칙입니다. 검색 가능해지길 결코 원치 않는 견지(레터헤드)가 있는 인보이스, 인식기를 헷갈리게 하는 도장 영역 같은 것들이죠. 참조 카운팅이 수명을 관리하도록 TInterfacedObject로 쓴 아래 엔진은 워드의 중심이 페이지의 어디에 떨어지는지로 걸러낸 뒤 살아남은 것들을 픽셀 좌표 그대로 반환합니다. RunRecognizer는 여러분의 인식기 호출을 대신 서는 것입니다
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // 사용자 공간
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // 여러분의 인식기, 픽셀 박스
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // 여전히 픽셀: HotPDF가 스스로 사상함
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
엔진은 다른 엔진처럼 ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info)에 넘기면 됩니다. 라이브러리는 돌아온 것을 신뢰하기 전에 검증합니다. 박스가 비트맵을 벗어나거나, Right <= Left이거나 Bottom <= Top이거나, Confidence가 0..1 밖이거나 MinimumConfidence 미만이면 워드는 버려지고 Info.DroppedWordCount에 셉니다. MaxWordsPerPage보다 많은 워드를 반환하거나 누계를 MaxTotalWords 너머로 밀면 예산 오류로 호출 전체가 실패하니, 엔진에서 Request.MaxWords를 지키세요. 반환 전에 워드 박스를 사용자 공간으로 바꾸지 마세요. HotPDF는 포인트 값을 픽셀로 취급해 레이어가 비트맵 원점 쪽으로 무너집니다
직접 만든 탐지기 출력 사상하기
같은 헬퍼는 RenderLoadedPageToBitmap 위에 세운 자체 파이프라인에도 쓰입니다. 이것은 인식 기능들처럼 보이는 박스를 렌더링하고 /Rotate를 적용합니다. GetLoadedPageVisibleBox로 박스를 읽고, 회전을 HotPDF와 같은 식으로 정규화하고, 각 픽셀 박스의 서로 다른 두 모서리를 사상하세요. Y축이 뒤집히고 90과 270도에서는 축이 교환되므로, 사상된 모서리는 정해진 순서 없이 나옵니다. 사상된 점들의 최소와 최대를 취하세요. HotPDF가 바코드 경계를 만드는 방식이기도 합니다
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // 여러분의 코드, 픽셀 박스
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
회전 동작은 페이지 박스를 깨지 않고 페이지 회전 평면화하기에서, 같은 변환을 소비하는 바코드 디코딩 파이프라인은 PDF 페이지에서 회전된 QR 코드 디코딩하기에서 더 깊이 다뤄집니다. 엔진이 외부 인식기를 감싼다면 검색 가능한 PDF용 Tesseract OCR 어댑터가 같은 인터페이스의 프로세스 격리와 취소 쪽을 보여 줍니다
빠른 참조: CropBox 안전 좌표 사상
- 렌더러는 보이는 박스, 즉 MediaBox로 잘린 CropBox(ISO 32000-1 §14.11.2)를 래스터화합니다. 모든 픽셀-페이지 사상은 그 박스를 써야 하며
GetLoadedPageVisibleBox로 읽음 ApplyLoadedOCRTextLayer, 전체 페이지DecodeLoadedPageBarcodes,DetectLoadedRedactionFindings의 얼굴 발견은 모두 보이는 박스로 사상하며, 커스텀 엔진이나 탐지기도 그래야 함THPDFOCRWord박스는 왼쪽 위 원점의 비트맵 픽셀입니다.GetLoadedPageBox와GetLoadedPageVisibleBox는 왼쪽 아래 원점,Bottom < Top인 PDF 사용자 공간을 반환- 스케일은
DPI / 72입니다. DPI에서 유도할 것, 비트맵 폭을 페이지 박스로 나눈 값에서는 결코 - /Rotate가 어떤 모서리가 중요한지 정합니다. 0과 90에서 Left와 Bottom, 180에서 Right와 Bottom, 270에서 Right와 Top
- OCR 워드는 픽셀로 반환하고 HotPDF에게 사상을 맡길 것. 변환은 자기 필터링 로직을 위해서만
- 이미 텍스트 레이어를 단 페이지에서 OCR을 다시 실행할 때는,
SkipPagesWithText가 끄거나 오래된 레이어를 먼저 제거하지 않는 한 그 페이지들을 건너뜀을 기억
여기서 쓴 인식 기능들, 페이지 박스 조회, 불러온 문서 렌더링은 모두 Delphi와 C++Builder용 HotPDF 컴포넌트에 실려 나갑니다. 라이선싱, 평가판 다운로드, 전체 기능 목록은 HotPDF Delphi PDF 컴포넌트 페이지에 있습니다