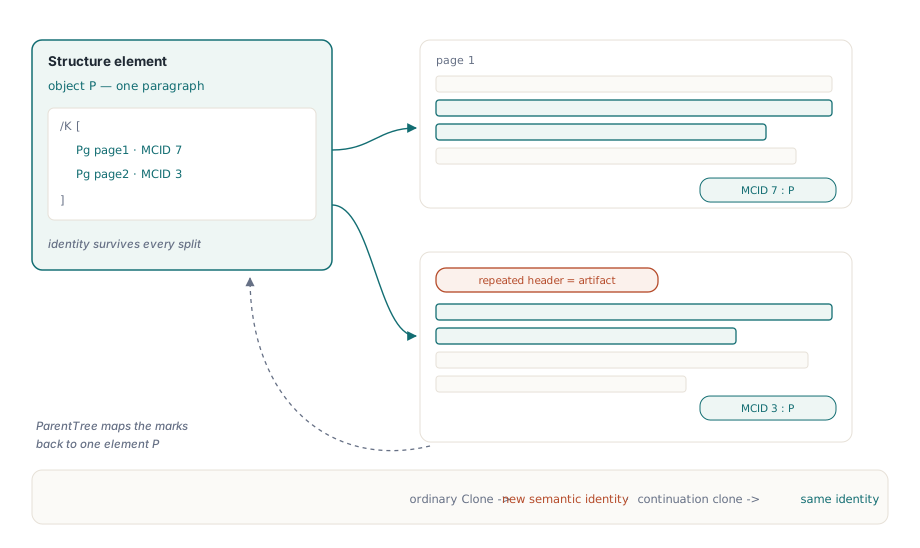
4페이지 아래에서 시작해 5페이지 위에서 끝나는 단락은 읽는 사람에게 하나의 단락입니다. 태그 PDF에서 이 단락은 두 콘텐츠 스트림에 걸쳐 있고, 각 페이지는 자기 마킹된 콘텐츠 시퀀스 번호를 따로 매기므로, 구조 트리에는 P 요소 하나가 필요하며 그 /K 배열은 4페이지의 MCID 7, 5페이지의 MCID 3처럼 조각들을 가리킵니다. 좌표 코드로 페이지를 그린 뒤 태깅을 뒤늦게 붙이면, 접근성 검사기의 태그 트리는 원래 하나였던 단락을 두 개로 보여주고 이어지는 표마다 데이터 안에 열 제목 세트가 반복되는 모양이 됩니다
좌표 기반 접근 방식에는 더 일찍 찾아오는 비용도 있습니다. 리포트 첫 버전은 잘 돕니다. 그러다 고객 주소가 세 줄로 늘고, 지역화된 제목이 줄바꿈되고, 표에 행이 마흔 개 늘면서, 그 지점 아래의 y 좌표는 전부 틀어집니다. 페이지 나눔 검사는 비즈니스 로직 곳곳에 흩어지고, x와 y만 알던 코드는 2년 뒤에 접근성 요구사항이 등장해도 단락이 어디서 시작되는지 모릅니다
Delphi에서 HotPDF 레이아웃 트리 만들기
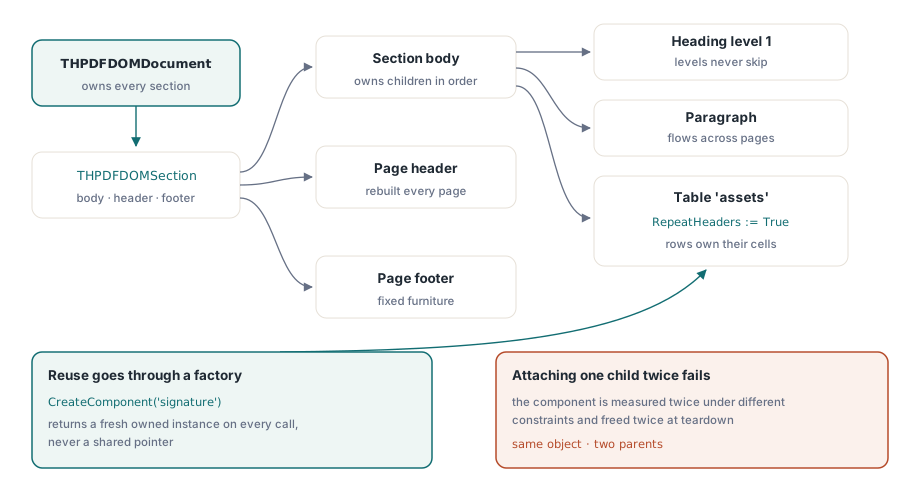
HotPDF는 HPDFLayoutDOM 유닛의 선언적 레이아웃 트리로 두 문제를 모두 해결합니다. THPDFDOMDocument가 섹션을 담고, 각 THPDFDOMSection은 페이지 크기, 여백, 선택적인 헤더와 푸터, 그리고 텍스트·제목·스페이서·목록·이미지·컨테이너·표를 추가하는 Body 스택을 가집니다. 트리의 어떤 것도 y 좌표를 갖지 않습니다. THPDFDOMRenderer가 트리를 측정하고 페이지 나눔을 결정하며 매 페이지의 헤더와 푸터를 그리고, GenerateStructure가 기본값 True이므로 그리는 동안 구조 트리까지 작성해 나갑니다
트리 안의 소유권은 엄격합니다. 문서는 자신의 섹션을, 섹션은 자신의 본문·헤더·푸터를, 스택·컨테이너·표는 자신의 자식을 소유하므로 Section.Body.Add(Table)는 표를 그 시점부터 완전히 넘겨받습니다. 두 부모에 붙은 컴포넌트는 서로 다른 제약 조건으로 두 번 측정되고, 정리 시점에는 두 번 해제됩니다. 서명 블록처럼 반복되는 조각은 Clone, SetHeaderClone / SetFooterClone, 또는 RegisterComponent에 등록한 팩토리에서 가져오면 CreateComponent('signature') 호출마다 새 인스턴스를 돌려줍니다
uses
  SysUtils, HPDFDoc, HPDFLayoutDOM;

type
  TAssetRow = record                    // 직접 정의한 데이터 타입
    Name, ServiceDate, Status: WideString;
  end;

function BuildMaintenanceReport(const Assets: array of TAssetRow): THPDFDOMDocument;
var
  Doc: THPDFDOMDocument;
  Section: THPDFDOMSection;
  Heading: THPDFDOMText;
  Table: THPDFDOMTable;
  Row: THPDFDOMTableRow;
  I: Integer;
begin
  Doc := THPDFDOMDocument.Create;       // GenerateStructure = True, Language = 'en-US'
  try
    Section := Doc.AddSection;          // 기본값은 A4 세로, 36 pt 여백
    Section.MarginLeft := 56;
    Section.MarginRight := 56;
    Section.Style.FontName := 'Helvetica';
    Section.Style.FontSize := 10;
    Section.Style.LineHeight := 13;
    Section.Body.Style.Spacing := 6;    // 본문 자식 사이 간격
    Section.Footer := THPDFDOMText.Create('Plant maintenance - internal');

    Heading := Section.Body.AddHeading('Annual maintenance report', 1);
    Heading.Style.FontSize := 18;
    Heading.Style.LineHeight := 22;     // LineHeight는 FontSize를 따르지 않음
    Section.Body.AddText('Every asset inspected during the reporting ' +
      'period is listed below, grouped by site.');

    Table := THPDFDOMTable.Create('assets');  // RepeatHeaders 기본값은 True
    Table.AddColumn(3);                 // 가중치이지 pt 폭이 아님
    Table.AddColumn(1);
    Table.AddColumn(1);
    Row := Table.AddRow(18, True);      // 헤더 행은 맨 앞에 와야 함
    Row[0].Text := 'Asset';
    Row[1].Text := 'Last service';
    Row[2].Text := 'Status';
    for I := 0 to High(Assets) do
    begin
      Row := Table.AddRow(16);
      Row[0].Text := Assets[I].Name;
      Row[1].Text := Assets[I].ServiceDate;
      Row[2].Text := Assets[I].Status;
    end;
    Section.Body.Add(Table);            // 이 시점부터 본문이 표를 소유
    Result := Doc;
  except
    Doc.Free;
    raise;
  end;
end;
이 코드에는 사람을 곤란하게 만드는 기본값이 둘 있습니다. LineHeight는 체인 어디에서도 스타일로 정해주지 않으면 FontSize와 무관하게 12포인트로 결정되므로, 자체 LineHeight가 없는 18pt 제목은 12pt 줄로 그려져 다음 줄과 겹칩니다. 그리고 표 행의 높이는 정확히 AddRow에 넘긴 높이 그대로이고, 셀 텍스트는 한 줄로 나가므로 행 크기는 쓰려는 폰트에 맞춰 잡아야 합니다
Render가 문서를 알아서 열고 닫는다
THPDFDOMRenderer.Render(Doc, Pdf)는 대상에서 BeginDoc를 호출하고 모든 섹션을 렌더링한 뒤 반환하기 전에 EndDoc를 호출합니다. 자체 BeginDoc / EndDoc 쌍으로 감싸면 안 됩니다. 문서가 시작되기 전에 정해야 하는 것은 먼저 THotPDF 인스턴스에 설정하는 값들, 즉 출력이 PDF/UA를 채택해야 한다면 FileName, Title, PDFUACompliance입니다. 구조 생성이 켜져 있으면 Render는 EnableTaggedPDF도 켜고, 비워 두었다면 Doc.Language를 Pdf.Lang에 복사합니다
var
  Doc: THPDFDOMDocument;
  Pdf: THotPDF;
  Renderer: THPDFDOMRenderer;
  Stats: THPDFDOMRenderStatistics;
begin
  Doc := BuildMaintenanceReport(Assets);
  Pdf := THotPDF.Create(nil);
  Renderer := THPDFDOMRenderer.Create;
  try
    Pdf.FileName := 'maintenance-report.pdf';
    Pdf.Title := 'Annual maintenance report';
    Pdf.PDFUACompliance := True;        // 그림 대체 텍스트 검사도 함께 켜짐
    // BeginDoc / EndDoc는 없음: 문서 열고 닫기는 Render의 몫
    Stats := Renderer.Render(Doc, Pdf);

    Writeln(Format('%d page(s), %d placement(s), %d split(s)',
      [Stats.PageCount, Stats.PlacementCount, Stats.SplitCount]));
    Writeln(Format('structure elements=%d marked content=%d artifacts=%d',
      [Stats.StructureElementCount, Stats.MarkedContentCount,
       Stats.ArtifactCount]));
    Writeln(Format('header draws=%d footer draws=%d deepest chain=%d',
      [Stats.HeaderDrawCount, Stats.FooterDrawCount,
       Stats.MaximumContinuationDepth]));
  finally
    Renderer.Free;
    Doc.Free;
    Pdf.Free;
  end;
end;
실행할 때마다 통계 레코드를 로그로 남기십시오. 예외 없이 지나간 템플릿 회귀를 잡아주는 유일한 단서인 경우가 많습니다. 템플릿 변경 뒤 SplitCount가 뛰면 어떤 컴포넌트가 전보다 크게 측정된다는 뜻이고, MaximumContinuationDepth가 조금씩 올라가면 어떤 컴포넌트의 Split이 페이지당 너무 적은 콘텐츠를 옮긴다는 신호입니다. ArtifactCount에는 페이지 헤더와 푸터, 표 기본 0.5 pt 테두리 같은 장식, 반복 헤더 행이 모두 포함되므로 손으로 계산한 목표값이 아니라 같은 템플릿의 실행 간 비교로 판단해야 합니다
긴 표는 매 페이지 자기 자신을 복제하지 않고 어떻게 나뉠까?
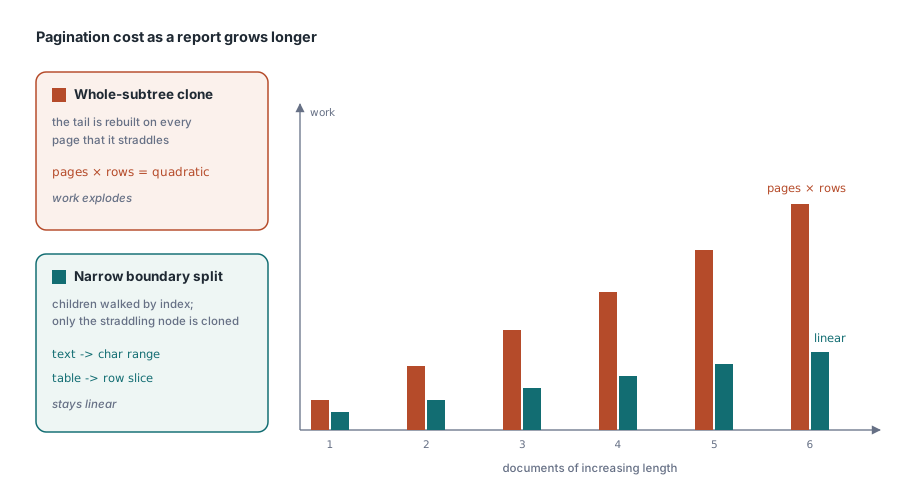
렌더러는 페이지 경계에 걸린 것만 나눕니다. 트리를 페이지로 나누는 순진한 방법은 들어가지 못한 것을 통째로 클론해 다음 페이지로 옮기는 것인데, 행이 만 개인 표에서는 남은 행을 페이지마다 한 번씩 복제해 선형 작업이 제곱 작업으로 변합니다. HotPDF는 본문 자식을 인덱스로 순회하며 섹션이나 본문 전체를 복제하지 않습니다. 페이지 경계를 넘는 중첩 스택이나 컨테이너는 영향받은 서브트리만 복제하고, 무거운 리프 타입 둘은 복사본 대신 커서를 갑니다
이어지는 단락은 원본 텍스트에 아직 내놓지 않은 문자 범위를 얹은 참조이며, 그 폭에 대해 이미 계산해 둔 줄바꿈을 재사용합니다. 이어지는 표는 원본 표에 아직 배치할 행 구간을 얹은 참조입니다. 300줄짜리 단락은 한 번 나뉘든 다섯 번 나뉘든 비용이 같습니다
배치 자체는 공개 THotPDF.PlaceLayoutElement를 통해 이루어집니다. 남은 본문 높이에 맞춰 요소를 측정하고, 들어가면 통째로 그리고, 안 들어가면 Split을 요청해 놓인 절반을 다시 측정해 그린 뒤, 나머지를 오버플로우 객체로 돌려주어 렌더러가 새 페이지로 옮겨 갑니다. Measure는 절대 그려서는 안 되며 한 배치에 여러 번 돌 수 있습니다. DOM 렌더러는 이 루틴 위에 페이지 장치, 자식 간 간격, 새 페이지 판단을 얹습니다
헤더 행 하나가 왜 렌더 전체를 멈출까?
반복 표 헤더에는 규칙이 둘 있고, 둘 다 리포트가 데이터 없는 페이지를 만들지 못하게 하려는 것입니다. 헤더 행은 반드시 첫 행 묶음이어야 합니다. 본문 행 뒤에 AddRow(Height, True)를 부르면 "Table header rows must precede body rows" 메시지와 함께 EInvalidOpException이 뜹니다. 그리고 표의 첫 분할에는 모든 헤더 행에 본문 행 최소 하나가 더해져야 들어갑니다. 헤더가 페이지 꼬리에 홀로 남을 표는 대신 다음 페이지로 밀려납니다
두 번째 규칙에는 딱딱한 경계가 있습니다. 헤더 행에 본문 행 하나를 더한 것조차 빈 페이지에 들어가지 않는다면 표가 시작할 페이지가 없는 것이고, Render는 컴포넌트 경로와 함께 "Layout component ... cannot fit an empty body page" 예외를 던집니다. 경로는 Sections[0]/Body/Items[2]/assets 식입니다. 이 동작이 바로 원하는 동작입니다. 다음 페이지가 더 넓으리라 바라며 페이지를 계속 추가하는 레이아웃 엔진은 과대한 헤더 하나를 디스크를 채우는 루프로 바꿔버립니다
커스텀 컴포넌트도 같은 보호를 받습니다. THPDFDOMComponent를 상속해 Clone, Measure, Draw, Split을 구현하면 렌더러가 본문 자식마다 몇 개의 이어짐을 만드는지 셉니다. 기본값 100,000인 THPDFDOMRenderer.MaximumContinuationDepth를 넘으면 "exceeded the continuation depth limit"으로 렌더가 멈춥니다. 동등한 꼬리만 돌려주어 진행이 없는 Split은 디스크가 찰 때까지 도는 대신 컴포넌트 경로와 함께 실패합니다
이어지는 페이지에서는 헤더 행이 /Artifact 마킹된 콘텐츠 시퀀스 안에서 다시 그려지고, 구조 트리는 원래 TR을 한 번만 유지합니다. 덕분에 텍스트 추출은 데이터 행 사이에 헤더 행을 중복 삽입하지 않고, 보조 기술도 표 한가운데에서 열 제목을 다시 읽지 않습니다. 각 헤더 셀은 /Scope /Column 속성과 함께 TH로 태그됩니다
하나의 논리 단락, 여러 페이지 조각
나뉜 단락은 P 구조 요소 하나로 남습니다. 보이는 조각마다 자기 페이지에서 새 마킹된 콘텐츠 시퀀스를 열고, HotPDF는 그 요소의 /K 배열에 마킹된 콘텐츠 참조 사전인 << /Type /MCR /Pg page /MCID n >>을 덧붙이며, 같은 요소를 가리키는 페이지의 ParentTree 항목에 MCID를 등록합니다. 이것이 ISO 32000-1 §14.7.4가 여러 페이지에 흩어진 콘텐츠 항목을 위해 기술한 배치이고, 태그 트리 보기에서는 한 단락으로, 페이지에서는 두 조각으로 보이게 만드는 장치입니다
이어짐 복사본이 직접 만든 클론과 다르게 동작하는 이유가 바로 의미론적 정체성입니다. Clone 호출은 "새 논리 콘텐츠"를 뜻하며 그 결과는 그려질 때 새 구조 요소를 받습니다. 페이지 나눔 중에 만들어지는 복사본은 이어지는 대상의 정체성을 물려받아, 세 페이지에 걸친 스택도 Div 하나로, 두 페이지에 걸친 목록도 L 하나로 나옵니다. 페이지 헤더와 푸터는 다른 길을 갑니다. 매 페이지에서 /Artifact << /Type /Pagination /Subtype /Header >>(또는 /Footer)로 감싸지며 구조 트리에는 들어가지 않습니다
트리가 렌더링되는 동안 검사하는 구조 규칙
GenerateStructure가 켜져 있으면 렌더러는 PDF/UA 검증이 나중에 거부할 구조를 애초에 받아들이지 않습니다. 첫 제목은 H1이어야 하고 이후 제목은 단계를 뛰어넘을 수 없으므로, H1 바로 다음의 H3은 "Semantic heading levels cannot skip an intermediate level" 예외를 냅니다. LI는 L 부모가 필요하고, Lbl과 LBody는 LI가, TR은 표나 행 그룹이, TH / TD는 TR이 필요합니다. 대상에 PDFUACompliance가 설정되어 있으면 대체 텍스트 없는 Figure도 거부됩니다. 위반 하나하나가 Render를 예외로 멈춥니다
var
  List: THPDFDOMList;
  Bmp: TBitmap;                         // Vcl.Graphics
begin
  Section.Body.AddHeading('Findings', 2);     // H1이 먼저 왔으므로 H2는 적법

  List := THPDFDOMList.Create('Decimal');     // L로 태그, ListNumbering /Decimal
  List.AddItem('1.', 'Replace the intake filter on pump P-14');
  List.AddItem('2.', 'Re-torque the flange bolts on line 3');
  Section.Body.Add(List);                     // AddItem이 LI, Lbl, LBody를 생성

  Bmp := TBitmap.Create;
  try
    Bmp.LoadFromFile('site-plan.bmp');
    // 이미지는 그래픽을 복사한다. 빈 대체 텍스트는 PDFUACompliance에서 실패
    Section.Body.Add(THPDFDOMImage.Create(Bmp, 240, 160,
      'Site plan of plant 3 with the inspected pumps circled'));
  finally
    Bmp.Free;
  end;
end;
이 규칙들이 렌더 도중 검사에 들어 있는 데에는 타이밍 이유가 있습니다. 파일이 쓰인 뒤에야 빠진 대체 텍스트를 알려주는 검증기라면 만 건짜리 명세서 배치를 통째로 다시 만들어야 하는데, Render 도중의 예외는 문제를 낸 레코드가 아직 스코프에 있는 상태에서 실패한 규칙 이름을 알려줍니다. 형식 적합성 검사 자체는 여전히 파이프라인의 몫이고, Render가 돌아온 뒤에도 문서 객체를 읽을 수 있으므로 그 자리에서 바로 돌릴 수 있습니다. PDF/A, PDF/X, PDF/UA 검증 문서가 그 단계를 다루고, 구조 순서와 텍스트 추출 문서는 태그 트리가 추출 도구가 읽어 돌려주는 순서를 어떻게 결정하는지 보여줍니다
직접 그리기를 유지할 때
트리는 직접 API와 같은 THPDFPage 객체 위에 그립니다. Render가 BeginDoc부터 EndDoc까지 문서를 소유하므로, 서명 이미지 같은 수동 배치 아트워크는 트리 안에 넣는 것이 맞습니다. 커스텀 컴포넌트의 Draw는 페이지와 바운드를 받아 그 안에서 평범한 페이지 메서드를 부를 수 있습니다. 페이지 닫기는 AddPage와 EndDoc의 몫으로 남으므로, THotPDF 인스턴스에 ImmediateFlushLayout을 설정하면 완성된 페이지가 렌더 도중 기록되고 렌더러는 완료된 페이지를 쥐고 있지 않습니다. 메모리 사용량은 열려 있는 이어짐, 폰트 리소스, 문서 객체 그래프에 좌우됩니다
DOM 텍스트 컴포넌트는 글자당 평균 진폭을 폰트 크기의 0.55배로 잡아 줄을 나누고 모든 줄에 확정된 LineHeight를 부여합니다. 덕분에 측정이 값싸고 모든 기계에서 같게 유지되며, 데이터 주도 리포트에는 충분한 근사입니다. 전부 대문자, 굵은 구간, CJK처럼 넓은 글리프를 가진 텍스트는 추정보다 넓게 나오므로 그런 열 폭에는 여유를 두고 가장 긴 실제 문자열로 레이아웃을 한 번 검증하십시오. 정확한 글리프 메트릭스, 한 줄에 섞인 여러 폰트, 양쪽 정렬 단락으로 조판하는 페이지에는 직접 텍스트 API가 더 맞습니다. 텍스트 양쪽 정렬 문서가 그 길을 안내하고, 표 페이지 나눔만이 문제라면 PDF 표 생성이 더 작은 변경으로 해결해 줍니다
레이아웃 트리와 그 렌더러, 여기서 설명한 태깅, 직접 그리기 API는 Delphi와 C++Builder용 컴포넌트 하나에 함께 들어 있습니다. 에디션과 전체 기능 목록은 HotPDF Delphi PDF 컴포넌트 페이지에 정리되어 있습니다