HotPDF는 THPDFHTMLImporter.RenderHTML5를 통해 HTML을 PDF 페이지로 변환하며, 이는 실제 DOM, 실제 CSS 캐스케이드, 테이블, 페이지 나누기, 그리고 HTML 폼 컨트롤로부터 선택적으로 AcroForm을 생성하는 버전 관리된 페이지드 미디어 프로필입니다. 이 과정은 전적으로 프로세스 내부에서 실행되며, 브라우저 엔진도, Chromium도, 외부 변환기도 없고, 기본적으로 파일이나 네트워크 접근이 전혀 없습니다
개선된 RenderHTML이 아니라 별도의 진입점이 존재하는 이유는 호환성 때문입니다. 기존 메서드는 수년간 프로덕션 애플리케이션에서 청구서와 서신을 렌더링해 왔으며, 관대한 DOM과 완전한 캐스케이드를 도입하면 기존 동작에 맞춰 조정된 문서의 출력이 바뀌게 됩니다. 그래서 기존 메서드는 정확한 의미를 그대로 유지하고, 새로운 모든 것은 RenderHTML5 뒤에 자리하며, 그 프로필 버전은 HTML5ProfileVersion이 알려주고 지원되는 마일스톤은 HTML5ProfileMilestones가 나열합니다
HTML5 프로필이 실제로 추가하는 것은 무엇인가?
실제로 중요한 기능은 네 가지입니다. html과 body가 텍스트 노드가 아니라 컨테이너인 구조적 DOM. 우선순위가 올바른 CSS 캐스케이드. 테이블 레이아웃. 그리고 명시적인 페이지 나누기 제어인데, 이것이 바로 "페이지드 미디어"의 의미입니다. HTML은 스크롤 뷰포트를 위해 설계되었으므로, 이를 페이지로 바꾸려면 콘텐츠가 어디에서 끊길 수 있는지 결정해야 합니다
컨테이너에 관한 이 지적은 구현 세부사항처럼 들리지만 실제로는 작동과 미작동을 가르는 차이입니다. 루트 요소가 텍스트 컨테이너로 취급되면 전체 DOM은 파싱 시점에 하나의 텍스트 블록으로 무너지고, 이후의 모든 스타일시트 규칙, 페이지 나누기, 테이블, 폼 서브트리는 아무것도 없는 대상에 적용됩니다. 구조화된 문서로부터 구분되지 않는 텍스트 벽 하나만 만들어내는 HTML 렌더러는 바로 이 실수를 저지른 것입니다
캐스케이드 순서를 풀어 보면
CSS 우선순위는 단일 정렬이 아닙니다. HotPDF는 일치하는 규칙의 일반 선언을 명시도 순서, 다음으로 소스 순서에 따라 적용하고, 그 위에 인라인 일반 선언을 적용한 다음, 일치하는 규칙의 !important 선언을 적용하고, 마지막으로 인라인 !important를 적용합니다. 이 순서대로 네 단계입니다
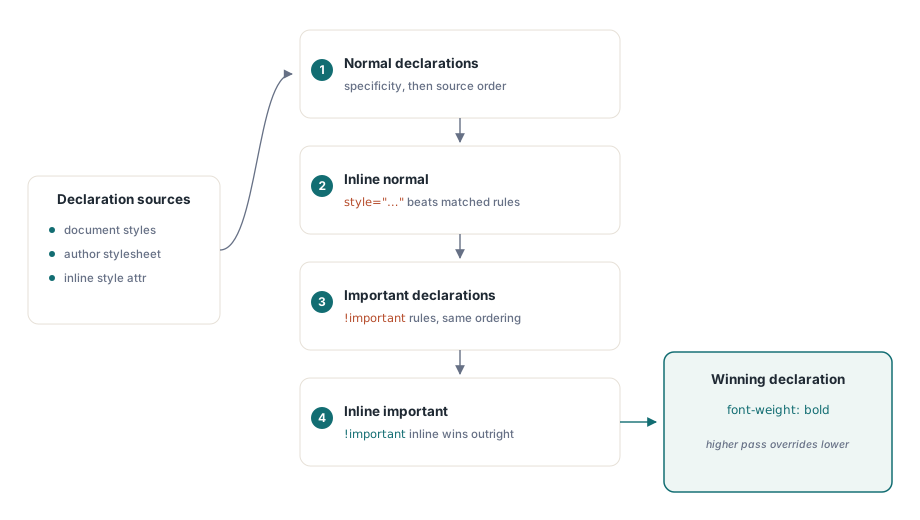
이를 "나중이 이긴다"로 뭉뚱그리는 구현은 흔한 경우는 맞히고 흥미로운 경우는 틀리는데, 이는 균일하게 틀리는 것보다 더 나쁩니다. 그 실패는 기본 스타일시트를 재정의하기 위해 !important를 사용하는 템플릿, 즉 캐스케이드가 제대로 작동하리라 기대하는 사람들이 작성한 바로 그 템플릿에서만 나타나기 때문입니다:
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // points
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // 컨트롤을 렌더링만 하고 필드는 작성하지 않음

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
두 번째 인자는 문서가 담고 있는 스타일과 나란히 적용되는 작성자 스타일시트로, 모든 템플릿을 편집하지 않고도 페이지 여백이나 위도우 제어 같은 하우스 룰을 강제하는 깔끔한 방법입니다
임포터가 아무것도 가져오지 않는 이유는?
외부 참조를 해석하는 HTML-to-PDF 변환기는 문서 생성 도구의 탈을 쓴 서버 사이드 요청 위조 엔진입니다. 사용자가 제공한 마크업을 넣으면 http://169.254.169.254/나 애플리케이션 서버의 파일 URL을 기꺼이 가져와서 누군가 다운로드하는 PDF에 그 결과를 임베드해 버립니다
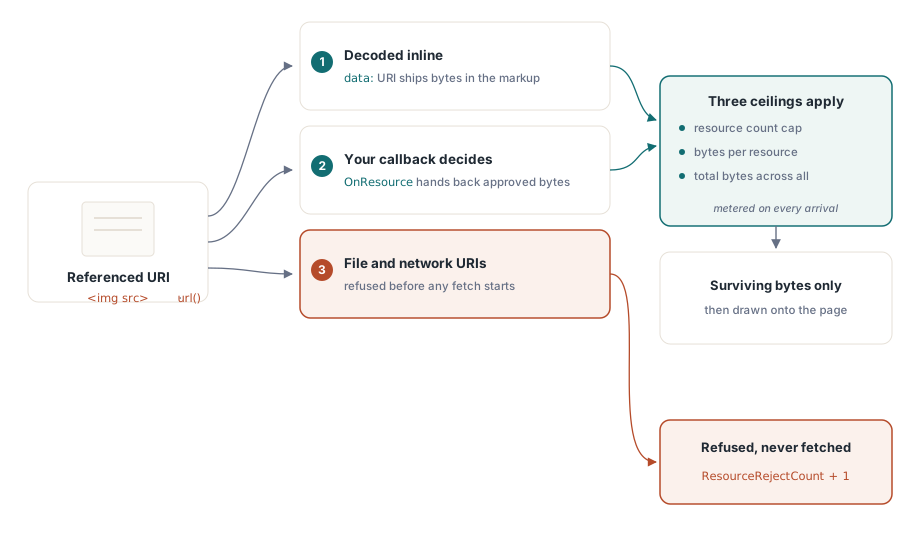
따라서 HotPDF는 기본적으로 파일도 네트워크도 읽지 않습니다. 이미지 및 기타 리소스는 정확히 두 가지 방법으로만 도착합니다: 마크업 내부의 data: URI로, 또는 OnResource 콜백을 통해서인데, 이 경우 URI가 무엇을 의미하는지와 바이트를 제공하는 것은 사용자 코드가 결정합니다:
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // 허용 목록에 등록된 로컬 애셋 디렉터리에서만 제공함
  // URI를 절대 HTTP 클라이언트에 넘기지 말고, 먼저 검증하지
  // 않은 채 경로에 결합하지도 말 것
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
실제로 도착하는 리소스도 여전히 세 가지 별도의 상한선, 즉 리소스 개수, 각 리소스의 바이트 수, 전체 바이트 수에 대해 계산됩니다. 요청받은 것을 충실히 반환하기만 하는 콜백은 동일한 50MB 이미지를 200번 참조하는 문서에 의해 메모리를 고갈시키도록 유도될 수 없습니다
네 가지 예산, 하나의 실패 모드
파서 노드, CSS 규칙, 레이아웃 연산, 리소스는 각각 독립적으로 계측되는데, 이는 이들이 독립적으로 실패하기 때문입니다. 어떤 문서는 작으면서도 레이아웃 비용이 병적으로 클 수 있고, 다른 문서는 얕은 구조이면서 셀렉터 매칭을 폭증시키도록 설계된 스타일시트를 가질 수 있습니다. 이 중 하나라도 소진되면 EHPDFHTMLImportBudget이 발생하는데, 이는 예산 소진을 잘못된 입력과 별도로 포착할 수 있도록 하는 전용 예외 클래스입니다
통계는 각 RenderHTML5 호출 시작 시 초기화되므로, 이 수치는 임포터 객체의 전체 수명이 아니라 한 번의 가져오기를 나타냅니다. 신뢰할 수 없는 템플릿을 렌더링하는 서비스에서는 문서별로 ParsedNodeCount, LayoutOperationCount, ResourceRejectCount를 기록하세요. 거부 횟수가 증가한다는 것은 대개 템플릿 작성자가 콜백이 인식하지 못하는 애셋을 참조하고 있다는 뜻이고, 레이아웃 연산 수가 상한선에 가깝다는 것은 다음번의 조금 더 큰 문서가 실패하리라는 뜻입니다
HTML 가져오기와 레이아웃 API 중 선택하기
Delphi 개발자가 아닌 사람들이 HTML로 콘텐츠를 작성하는 경우, 템플릿이 코드보다 더 자주 바뀌는 경우, 또는 같은 콘텐츠를 이메일로도 보내야 하는 경우에는 HTML 가져오기가 유리합니다. 태그 지정 출력을 포함한 선언적 PDF 레이아웃에서 설명하는 선언적 레이아웃 트리는 문서가 사용자 코드에 의해 데이터로부터 생성되는 경우, PDF/UA 구조를 자동으로 출력해야 하는 경우, 또는 작성 편의성보다 페이지 매김에 대한 정밀한 제어가 더 중요한 경우에 유리합니다
둘은 배타적이지 않습니다. 흔한 구성은 보고서 본문에는 HTML 가져오기를 쓰고, 머리글·바닥글·서명란은 직접 그리는 것인데, 이들은 어떤 템플릿도 소유해서는 안 되는 고정된 지오메트리이기 때문입니다. 테이블은 두 방식을 모두 측정해 볼 가치가 있는 유일한 영역입니다: 복잡한 재무 테이블은 PDF에서 테이블 생성하기에서 설명하는 전용 테이블 경로를 통할 때 더 잘 페이지 매김되는 경우가 있습니다
CreateAcroForms는 의도적으로 설정하세요. 끄면 HTML 폼 컨트롤은 인쇄된 명세서가 원하는 대로 정적인 그림으로 렌더링됩니다. 켜면 그것들은 채울 수 있는 폼이 원하는 대로 실제 상호작용 가능한 AcroForm 필드가 되며, 그 뒤에 이어지는 필드 동작은 로드된 PDF에 폼 필드 추가하기에서 다룹니다
HTML 가져오기, 선언적 레이아웃, 직접 그리기 API는 모두 Delphi와 C++Builder에서 동일한 문서 객체를 대상으로 합니다. 전체 기능 목록은 HotPDF Delphi PDF 컴포넌트 페이지에서 확인할 수 있습니다