손으로 작성한 JBIG2 리더가 처음 만난 특이한 파일에서 저지르는 실수가 있습니다. 파일 헤더를 파싱하고, 첫 세그먼트 헤더를 파싱하고, 4바이트 데이터 길이를 읽어 그만큼을 세그먼트 본문으로 취하는 것입니다. 대부분의 .jb2 파일에서는 정확히 맞습니다. 그런데 플래그 바이트의 비트 0이 0인 파일에서는 그 "본문" 바이트들이 사실 두 번째, 세 번째, 네 번째 세그먼트 헤더이고, 산술 디코더는 그것들을 노이즈 비트맵으로 바꾸거나 버퍼 끝을 넘어 달려 나갑니다. 파일은 깨지지 않았습니다. ITU-T T.88 부속서 D.2의 random-access 조직을 쓰는 것뿐입니다. 모든 세그먼트 헤더가 먼저 오고 모든 세그먼트 데이터가 같은 순서로 뒤따르는 조직이죠
random-access 파일은 드뭅니다. 리더가 압축 바이트를 만지기 전에 모든 페이지와 딕셔너리 의존 관계를 보길 원하는 아카이브 및 문서 이미징 시스템에서 나옵니다. 변환 작업이 그런 소스의 파일과 평범한 스캔을 섞는다면, 순차형뿐인 배치 한가운데에 random-access 파일 하나가 앉을 수 있습니다. 이 파일들을 읽는 디코더는 JBIG2 커스텀 Huffman 테이블과 canonical prefix 코드를 처리하는 그 네이티브 Pascal 디코더이므로 코딩 쪽은 그대로이고, 세그먼트를 찾는 순서만 다릅니다
하나의 플래그 바이트 뒤에 있는 세 가지 파일 레이아웃
Delphi용 PDF Library는 PDFlibJBIG2 유닛의 TPLJBIG2Decoder로 독립형 JBIG2 파일을 읽고, 디코더는 파일 헤더에서 레이아웃을 스스로 판단합니다. T.88 부속서 D는 같은 세그먼트들을 세 가지로 배열하게 합니다. sequential(D.1)은 각 헤더를 그 데이터 바로 앞에 두고, random-access(D.2)는 모든 헤더를 먼저 두고 데이터를 나중에 두며, embedded(D.3)는 다른 컨테이너 안에서 쓰는 헤더 없는 형태입니다. 독립형 파일은 8바이트 식별자 97 4A 42 32 0D 0A 1A 0A로 시작하고, 플래그 바이트 한 개, 그리고 플래그가 개수 미지수라고 말하지 않는 한 4바이트 페이지 수가 뒤따릅니다
그 플래그 바이트의 비트 0이 조직을 고릅니다. 1은 sequential, 0은 random-access입니다. 비트 1이 켜져 있으면 페이지 수를 모른다는 뜻이고 4바이트 카운트는 없으므로, 첫 세그먼트 헤더는 13바이트가 아니라 9바이트에서 시작합니다. 비트 2~7은 예약되어 있는데, 디코더는 이 비트들이 켜진 파일을 거부하지 않고 받아들입니다. 길 잃은 예약 비트는 세그먼트 자체의 가독성에 대해 아무것도 말하지 않기 때문입니다
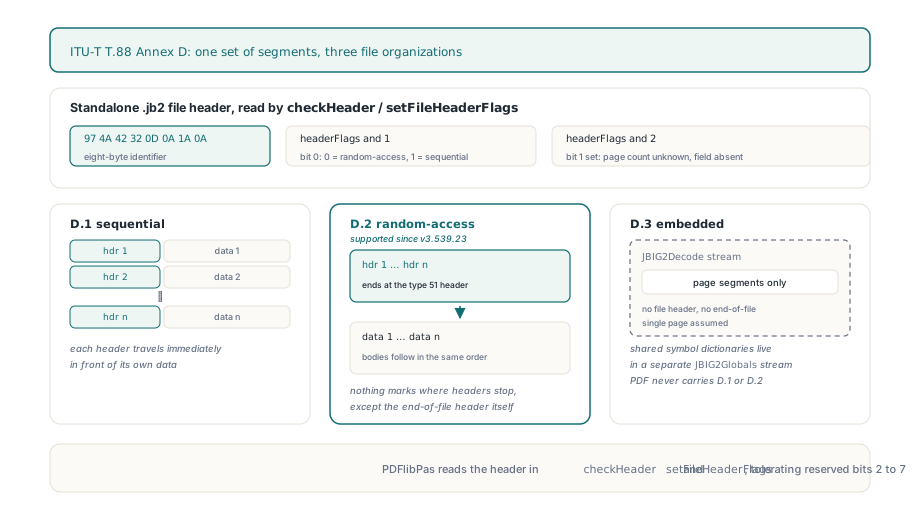
PDF 자체는 random-access 레이아웃을 담지 않습니다. ISO 32000-1 §7.4.7이 설명하는 JBIG2Decode 이미지 스트림은 embedded 형태의 페이지 세그먼트만 담고, 공유 심볼 딕셔너리는 별도의 JBIG2Globals 스트림으로 옮겨지며, 파일 헤더와 end-of-page, end-of-file 세그먼트는 없습니다. 디코더가 8바이트 식별자를 찾지 못하면 입력을 정확히 그 부류의 스트림으로 취급합니다. sequential, 한 페이지로요. 반대로 Delphi용 PDF Library가 JBIG2Decode 이미지를 네이티브 .jb2 파일로 내보낼 때는 플래그 바이트 $03(sequential, 페이지 수 미지수)을 쓰고 end-of-file 세그먼트 헤더를 덧붙입니다. 그래서 random access는 언제나 밖에서 옵니다. TPLJBIG2Decoder에 직접 건네지는 독립형 파일로, 보통 PDFlibPas의 JBIG2 인코더 백엔드로 PDF용 변환 또는 재압축을 하러 가는 길목에 있습니다
random-access 파일을 파일 순서대로 읽을 수 없는 이유는?
end-of-file 세그먼트 헤더(타입 51) 자체를 빼면 바이트 스트림 어디에도 헤더 블록이 끝나고 데이터 블록이 시작되는 지점을 표시하는 것이 없기 때문입니다. JBIG2 세그먼트 헤더는 고정 크기가 없습니다. referred-to 세그먼트 카운트는 3비트 단축형이거나 retention 비트맵이 뒤따르는 장형이고, referred-to 세그먼트 번호는 현재 세그먼트 자체 번호의 크기에 따라 1, 2, 4바이트를 차지하며, 페이지 연관 필드는 1바이트 또는 4바이트입니다. 리더는 다음 헤더가 어디서 시작하는지 알아내려고 헤더의 모든 필드를 파싱해야 합니다
파일 순서대로 걷는 sequential 리더는 첫 헤더는 맞고 그 뒤는 전부 틀립니다. 더 나쁜 것은 한동안 모를 수도 있다는 점입니다. 헤더 바이트를 먹인 generic region 디코더는 어떤 길이나 참조 검사가 마침내 걸릴 때까지 오류 대신 픽셀을 만들어 냅니다. 저희 견해는 이렇습니다. 헤더를 먼저 인덱싱하지 않는 디코더는 random-access 파일을 아예 거부해야 합니다. 명확한 거절은 배치에서 파일 하나의 비용이지만, 그럴듯해 보이는 잘못된 비트맵은 아카이브에 들어가 그 자리를 지킵니다
첫 본문 전에 모든 헤더 인덱싱하기
플래그 바이트가 random-access라고 말하면, Delphi용 PDF Library는 무엇을 디코딩하기 전에 헤더 블록 위를 한 번 훑습니다. 각 헤더는 완전히 파싱된 뒤 버려지고, 남는 것은 파일 안에서의 바이트 오프셋뿐입니다. 압축 데이터는 재배열된 두 번째 버퍼로 복사되지 않는데, 데이터 블록이 파일의 대부분일 수 있는 대형 아카이브 스캔에서 이것이 중요합니다. 훑기는 첫 end-of-file 헤더에서 멈추고, 그 시점에 읽기 위치는 첫 세그먼트 데이터의 첫 바이트 위에 놓입니다
random-access 파일은 sequential 파일보다 중복이 적으므로 pre-scan은 엄격합니다. 다음 경우 파일을 거부합니다:
- 헤더가 버퍼 끝에 잘리는 경우, 그 헤더가 시작한 오프셋과 함께
JBIG2 truncated random-access header at byte N으로 보고됩니다 - 세그먼트 번호가 (부호 없는 값으로 비교해) 엄격히 증가하지 않는 경우. 같은 번호를 주장하는 헤더 둘은 나중 region의 referred-to 목록을 모호하게 만듭니다
- 데이터 길이의 최상위 비트가 켜진 경우.
0xFFFFFFFF"unknown length" 마커가 여기에 듭니다. 이 레이아웃에서는 다음 본문이 시작하는 곳을 찾을 다른 방법이 없으므로, 디코더는 end 마커를 찾아 헤매는 대신 즉시 거부합니다 - end-of-file 헤더가 데이터를 선언하거나 아예 나타나지 않는 경우(
JBIG2 random-access file is missing its end-of-file header) - 선언된 길이의 합이 남은 바이트보다 크거나 작은 경우
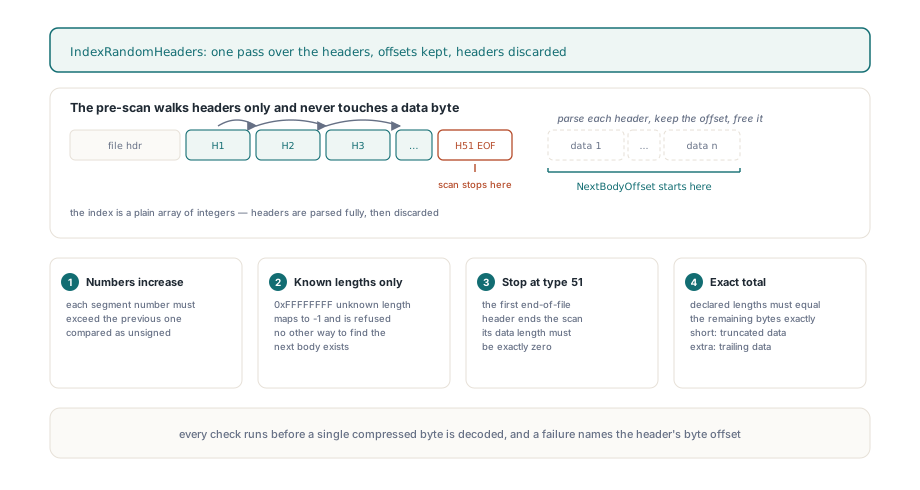
사람들이 걸려 넘어지는 것은 마지막 규칙입니다. 최종 본문 뒤의 바이트 하나가 JBIG2 trailing random-access data로 실패합니다. sequential 경로 옆에서 보면 가혹해 보입니다. 거기서는 디코딩이 end-of-file 세그먼트에서 그저 멈추고 그 뒤는 무시됩니다. 비대칭에는 이유가 있습니다. sequential 레이아웃에서는 각 헤더가 자기 데이터 바로 옆에 앉아 있으므로 끝의 잡동사니가 무언가를 밀 수 없습니다. random-access 레이아웃에서는 헤더들이 데이터 블록의 유일한 지도이고, 길이가 맞아떨어지지 않으면 디코더는 무해한 패딩과 훨씬 이전에 잃거나 더해져 뒤의 모든 본문을 민 바이트를 구별할 수 없습니다
바이트 카운트 루프는 마지막 end-of-page 세그먼트를 왜 놓칠까?
"남은 바이트가 있는 동안" 도는 루프는 random-access 파일에서 너무 일찍 끝납니다. 헤더 인덱스가 끝나기 전에 데이터가 바닥나기 때문입니다. end-of-page(타입 49)와 end-of-file 세그먼트는 데이터를 0바이트 가지며 보통 마지막에 옵니다. 최종 region 본문을 소비하고 나면 읽기 위치가 정확히 버퍼 끝이고, 바이트 카운트 루프는 거기서 빠져나가 길이 0의 end-of-page 세그먼트는 영영 디스패치되지 않은 채 페이지가 미완성으로 남습니다
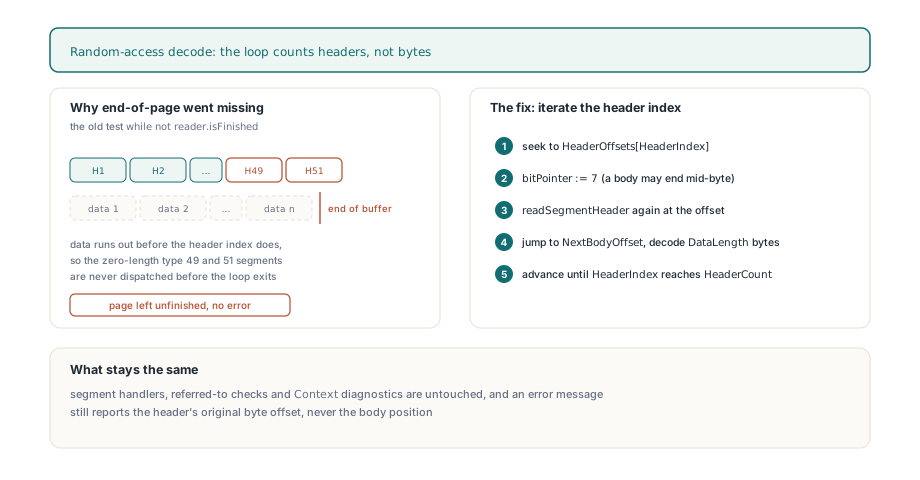
그래서 random-access 파일에서 디코더는 바이트가 아니라 헤더를 셉니다. 각 단계는 다음 인덱스된 헤더로 돌아가 바이트 경계로 재정렬하고(산술 코딩된 본문은 바이트 한가운데서 끝날 수 있습니다), 헤더를 다시 파싱한 뒤, 다음 본문이 시작하는 곳으로 점프해 선언된 길이만큼 지나갑니다. 일찍 끝난 본문 디코더는 선언된 끝으로 건너뛰고, 그것을 넘어 읽은 것은 거부됩니다. 거기서부터 세그먼트는 sequential 파일과 같은 핸들러와 참조 검사를 통과합니다. 본문 디코딩 중에 raise된 오류는 JBIG2 segment N (type T) at byte B: ... 형태로 헤더의 원래 위치를 실으므로, LastError의 오프셋이 헥스 에디터에서 찾을 수 있는 곳을 가리킵니다
Delphi에서 random-access .jb2 파일 로딩하기
애플리케이션 코드는 조직에 따라 바뀌지 않습니다. TPLJBIG2Decoder.LoadFromByteArray가 파일 헤더와 레이아웃을 감지하고, 거부된 입력에는 그 이유를 LastError에 담아 False를 반환하며, 디코딩된 페이지는 픽셀당 1바이트, 검정이 1인 Width, Height, GetScanline으로 노출합니다
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // sequential과 random-access 독립형 파일은 같은 호출로 처리한다
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
로깅이나 변환 실행 전 코퍼스 분류를 위해 파일이 어떤 레이아웃인지 알고 싶다면, 플래그 바이트는 직접 읽으세요. 라이브러리는 감지한 조직을 노출하지 않고, 필요한 것은 9바이트뿐입니다. 아래 헬퍼는 여러분 코드에 추가할 것이고, T.88 헤더 규칙을 그대로 옮긴 것입니다:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// 자작 헬퍼, PDFlibJBIG2 일부 아님: T.88 파일 헤더로 버퍼를 분류한다
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // 예: PDF에서 꺼낸 embedded 스트림
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // 비트 1 세트: 4바이트 페이지 수 없음
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
배치 잡: 패딩된 버퍼와 거부된 파일
배치 코드가 잘못되기 쉬운 곳은 trailing-data 규칙이고, 다른 곳에서 열리던 파일이 이 방식으로 거부되면 파일보다 버퍼를 먼저 보세요. 데이터베이스 BLOB 열, 고정 크기 네트워크 읽기, 정렬 패딩이 있는 컨테이너 형식에서 꺼낸 .jb2는 실제 끝 뒤에 0 바이트 몇 개를 달고 도착할 수 있습니다. sequential 파일은 그 정도는 태연하게 넘깁니다. 같은 패딩을 지닌 random-access 파일은 JBIG2 trailing random-access data로 실패하고, 몇 바이트 짧게 잘린 버퍼도 truncated로 실패합니다. 정확히 파일의 바이트를, 청크 크기나 용량이 아니라 소스의 실제 길이로 크기를 잡아 넘기세요
거부된 파일은 뒤도 깨끗이 남기지 않습니다. LoadFromByteArray는 디코딩을 시작하기 전에 Width, Height, 스캔라인을 리셋하므로, 실패한 호출은 이전 파일의 페이지가 아니라 0 크기를 보고하고, 같은 디코더 인스턴스가 곧장 다음 파일로 갈 수 있습니다:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // 여기서 Width와 Height는 0; 이전 파일의 것은 아무것도 남지 않는다
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // 파일을 탓하기 전에 바이트가 어떻게 저장됐는지 확인
      end;
  finally
    Decoder.Free;
  end;
end;
자기 파이프라인에서 이것을 검사하는 데 희귀 샘플 파일은 필요 없습니다. sequential .jb2를 모든 헤더와 모든 압축 바이트를 지킨 채 random-access 레이아웃으로 재배치하고, end-of-page와 end-of-file 헤더를 헤더 블록 끝으로 옮기세요. 디코딩된 픽셀은 페이지 수 필드가 있든 없든 sequential 원본과 정확히 일치해야 합니다. 그다음 잘린 접두어 전부, 중복 세그먼트 번호, 꼬리 바이트 하나, 0xFFFFFFFF 길이를 먹이세요. 각각은 False를 반환하며 Width와 Height가 0이어야 합니다
디코더가 돌려주는 것과 기대하는 것
여기서 random access는 파일 레이아웃의 속성입니다. TPLJBIG2Decoder는 파일이 어느 조직이든 첫 페이지의 비트맵을 반환하고, Width와 Height는 그 페이지를 묘사합니다. 모든 세그먼트는 자기 데이터 길이를 선언해야 합니다. T.88은 immediate generic region이 0xFFFFFFFF 마커를 쓰게 하지만, 디코더는 어느 레이아웃에서든 그 마커를 unknown or oversized segment length is not supported로 거부합니다. 커스텀 Huffman prefix 길이와 테이블 엔트리 수의 상한도 sequential 파일과 똑같이 적용됩니다
JBIG2 디코딩은 PDF 이미지 추출, 재압축, JBIG2 인코딩까지 아우르는 더 긴 이미지 경로의 한 단계입니다. 그 파이프라인의 나머지와 지원 이미지 형식은 Delphi용 PDF Library 제품 페이지에서 다룹니다