JBIG2 Tables 세그먼트(type 53)를 바이트 하나하나 까 보면 첫 번째 놀라움은 빠져 있는 것입니다. Huffman 코드 자체가 그 대상입니다. flags 바이트 하나와 경계 두 개, 작은 숫자들의 나열을 얻는데, 그 숫자들은 코드 길이입니다. 인코더와 디코더는 모두 ITU-T T.88 Annex B.3의 절차로 그 길이에서 실제 비트 패턴을 다시 만듭니다. 조금 다른 순서로 다시 만들어도 유효한 prefix 코드가 나오고, 모든 패턴이 디코딩되고, 모든 값이 엉뚱한 패턴에 붙어 나옵니다
Huffman 심볼 ID와 인코더 제공 테이블로 코드된 페이지에서 그 어긋남은 나쁜 스캔처럼 보입니다. 글리프가 몇 픽셀 어긋나거나, 글자가 엉뚱한 심볼로 조립되거나, 폭이 몇 세그먼트 뒤에 범위를 벗어날 때까지는 그럴듯한 숫자들이 나옵니다. PDF 파일의 대부분 JBIG2는 arithmetic coding이고, Huffman 코딩 JBIG2 대부분은 표준 테이블 B.1~B.15에 머뭅니다. 자체 테이블을 실은 파일은 드물고, 그런 파일은 테이블 파서와 Huffman refinement, 비압축 collective 비트맵을 한꺼번에 시험하려 듭니다
Tables 세그먼트에 실제로 들어 있는 것
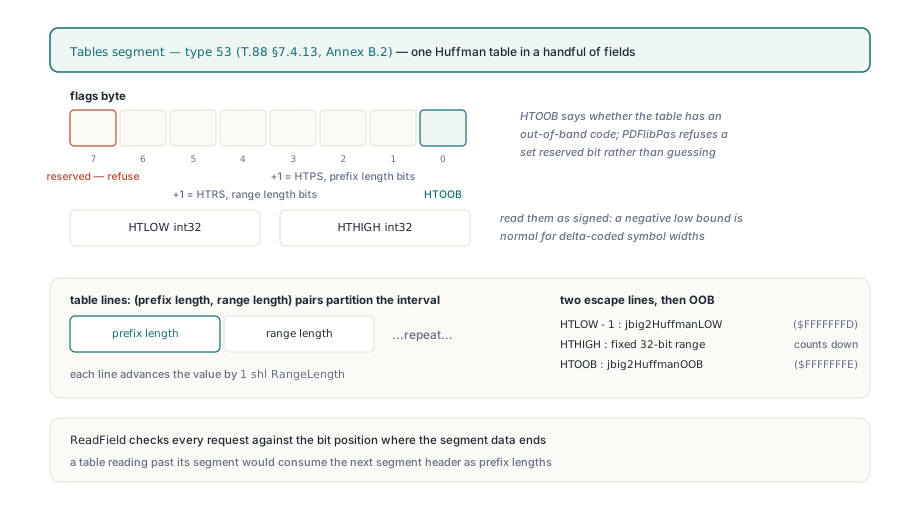
Tables 세그먼트는 Huffman 테이블 정확히 하나를 기술합니다. T.88 §7.4.13과 Annex B.2에 따르면 flags 바이트 하나, 부호 있는 32비트 HTLOW, 부호 있는 32비트 HTHIGH, 그리고 HTLOW부터 HTHIGH까지 구간을 나누는 (prefix 길이, range 길이) 쌍들로 이루어집니다. flags의 비트 0은 HTOOB로, 테이블에 out-of-band 코드가 있는지를 말합니다. 비트 1~3에 1을 더한 값이 모든 prefix 길이 필드의 폭인 HTPS이고, 비트 4~6에 1을 더한 값이 모든 range 길이 필드의 폭인 HTRS입니다. 비트 7은 예약되어 있습니다
경계는 손으로 쓴 파서가 대개 처음 넘어지는 곳입니다. HTLOW를 부호 없는 값으로 읽으면 -2에서 시작하는 테이블, 즉 델타 코딩된 심볼 폭과 높이에서는 지극히 평범한 테이블이 갑자기 43억 조금 아래에서 시작한다고 주장합니다. PDF Library for Delphi는 두 경계를 부호 있는 값으로 읽고, HTLOW가 HTHIGH보다 작지 않거나 range 길이가 32를 넘는 테이블은 거부하며, 모든 필드 읽기를 세그먼트가 선언한 데이터 끝 비트와 대조합니다. 이 마지막 검사가 소리보다 중요합니다. 세그먼트를 넘겨 읽는 테이블은 다음 세그먼트 헤더를 prefix 길이로 삼켜 완전한 엉터리로 파싱됩니다. 비트 7이 서 있으면 reserved custom Huffman table flag으로 실패합니다. 우리는 추측보다 그 거부를 선호합니다. 추측된 테이블은 원인을 역추적할 수 없는 잘못된 픽셀을 만들기 때문입니다
정규 라인 뒤에는 Annex B.2의 escape 라인들이 옵니다. 하위 range 라인은 HTLOW 빼기 1에서 시작해 32비트 오프셋만큼 아래로 내려가고, 상위 range 라인은 HTHIGH에서 32비트 range로 시작하며, out-of-band 라인은 HTOOB가 서 있을 때만 존재합니다. 이 라인들은 내장 표준 테이블이 쓰는 것과 같은 마커를 갖고, 그래서 커스텀 테이블과 Table B.6은 하나의 디코딩 루프를 같이 지나갑니다. 커스텀 테이블은 최대 65,536개의 라인을 담을 수 있습니다
prefix 코드는 왜 테이블 라인 순서로 부여해야 할까요?
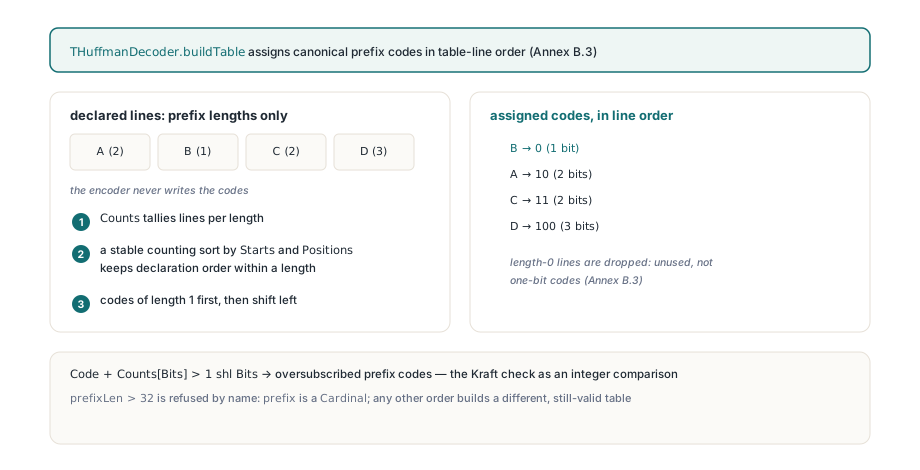
선언 순서만이 비트 패턴을 값 범위와 묶는 유일한 끈이기 때문입니다. Annex B.3는 각 prefix 길이를 쓰는 라인 수를 세고, 길이 1인 코드부터 나눠주고, 왼쪽으로 시프트해 길이 2로 이동하는 식으로 진행합니다. 같은 길이 안에서는 코드가 세그먼트에 나타난 순서대로 라인에 돌아갑니다. 작은 테이블 하나면 구체화됩니다. 파일 순서로 A부터 F까지 여섯 라인, 다음 prefix 길이를 갖습니다
| 라인 | prefix 길이 | 코드(파일 순서 유지) | B와 D가 뒤바뀌면 |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | 미사용 | 미사용 |
두 열 모두 유효한 prefix 코드입니다. 왼쪽만 인코더가 의도한 것입니다. B와 D가 뒤바뀌면 패턴 100은 D의 값 범위를 내놓고 디코더는 엉뚱한 구간의 숫자를 갖고 계속 갑니다. 라인 F는 길이 0인데, B.3은 이를 미사용으로 정의합니다. 여기에 1비트 코드를 주면 이후 배정 전체가 밀립니다
오른쪽 열을 얻는 쉬운 길은 prefix 길이로 정렬하는 범용 방법입니다. Delphi의 TArray.Sort와 TList<T>.Sort는 안정적이지 않아 같은 길이끼리는 어떤 순서로든 돌아올 수 있습니다. 여러분 도구에서 정규 코드를 만들려면 정렬 대신 길이별로 파일 순서를 한 번씩 훑으세요
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // Tables 세그먼트에서 읽은 그대로
    Code: Cardinal;       // 아래에서 배정
  end;

// 여러분 도구를 위해 쓴 Annex B.3 정규 배정.
// 같은 길이는 파일 순서를 유지하고, 길이 0은 코드를 받지 않습니다.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft 검사: 이 길이가 담을 수 있는 것보다 많은 코드
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // 파일 순서가 동점 결정
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
위의 여섯 라인을 넣으면 A는 00, C는 01, B는 100, D는 101, E는 110을 받고 F는 코드가 없습니다. PDF Library for Delphi는 같은 일을 counting 패스로 하는데, 구조적으로 안정적이고 테이블을 32번 재훑는 일도 피하며, 같은 두 가드를 적용합니다. 초과 구독된 길이는 oversubscribed Huffman prefix codes로 실패합니다. 통과시키면 하나의 패턴이 두 라인에 맞을 수 있습니다. 32비트보다 긴 prefix도 이름을 적어 거부하는데, T.88은 서류상으로는 허용합니다. 그 천장이 맞는 거래라고 생각합니다. 코드마다 기계 워드 하나에 들어가고, 더 많은 것을 필요로 하는 파일은 영리하기보다 손상됐을 가능성이 훨씬 큽니다
값에도 같은 주의가 필요합니다. 하위 range 라인은 HTLOW 빼기 1 빼기 32비트 부호 없는 오프셋으로 디코딩되는데, 중간을 32비트 Integer로 두면 그 뺄셈이 평범해 보이는 양의 폭으로 랩해버릴 수 있습니다. 디코더는 64비트로 계산하고 진짜 결과가 들어가지 않으면 Huffman value exceeds signed integer range를 raise합니다
셀렉터 순서, 그리고 서로를 가려 주는 두 함정
텍스트 영역이나 심볼 딕셔너리는 테이블 이름을 대지 않습니다. 2비트 셀렉터를 달고 있고, 커스텀으로 설정된 셀렉터 하나하나가 참조 목록에서 다음 Tables 세그먼트를 참조 순서대로 가져갑니다. T.88 §7.4.3.1.2는 텍스트 영역 셀렉터를 FS, DS, DT, RDW, RDH, RDX, RDY, RSIZE 순으로, §7.4.2.1.1은 심볼 딕셔너리 셀렉터를 DH, DW, BMSIZE, AGGINST 순으로 정합니다. 값 0과 1은 표준 테이블을, 3은 커스텀을 고르고, 2는 표준 테이블이 둘뿐인 필드에서 예약입니다. PDF Library for Delphi는 예약된 셀렉터 값을 거부하고, 셀렉터들이 영역이 참조하는 것보다 많은 커스텀 테이블을 원하면 missing custom Huffman table reference로 실패합니다
직접 디코더를 쓴다면 여기서 두 가지 실수가 쉽고, 하나하나가 다른 하나를 가려 줍니다. 첫 번째는 Delphi나 Delphi 모드 FPC에서 물립니다(objfpc 모드는 이 코드를 중복 식별자로 거부합니다). 필드와 같은 이름의 파라미터를 가진 flags 세터입니다. 파라미터가 필드를 가려 Flags := Flags가 자기 자신에 대입되고 필드는 0으로 남습니다. 그러면 모든 셀렉터가 0을 읽어, 텍스트 영역은 파일이 뭘 요구했든 FS, DS, DT에 표준 테이블 B.6, B.8, B.11을 쓰고 커스텀 경로는 영영 돌지 않습니다
두 번째는 심볼 딕셔너리에 있습니다. Huffman 딕셔너리는 심볼을 비압축 collective 비트맵(BMSIZE가 0)으로 저장할 수 있는데, 각 행은 부분 바이트로 끝납니다. 패딩 값은 그 바이트의 유효 비트 수인데, 이를 최하위 유효 비트 위치로 읽고 싶어집니다
// collective 비트맵 한 행의 마지막 바이트, 비트는 MSB부터 읽습니다.
// Padding := TotalWidth mod 8  -> 이 바이트의 유효(VALID) 비트 수

// 틀림: Padding을 복사할 최하위 비트 인덱스로 취급
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// 맞음: 최하위 유효 비트 인덱스는 8 - Padding (Padding = 0이면 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel은 여러분 디코더에서 픽셀을 기록하는 무엇이든 뜻합니다
경계 폭들을 점검해 보세요. 63픽셀 행의 패딩은 7입니다. 틀린 루프는 마지막 바이트의 비트 하나를 복사하고 맞는 루프는 일곱 개를 복사합니다. 9픽셀 행의 패딩은 1입니다. 틀린 루프는 일곱 개를, 맞는 루프는 하나를 복사합니다. 64픽셀에서는 둘 다 여덟 개를 복사하므로 8의 배수는 이 실수를 드러내지 않습니다. 7픽셀과 9픽셀 폭의 합성 collective 비트맵이 바이트 경계 양쪽을 못박아 줍니다. 그리고 피해는 번집니다. refinement가 이 심볼들을 참조로 쓰기 때문입니다
직접 쓴 디코더에 두 함정이 모두 있다면 디버깅은 비참해집니다. 세터만 고치면 커스텀 경로가 드디어 돌다가 망가진 collective 비트맵에 곧장 부딪혀 페이지는 여전히 잘못 보입니다. 패딩만 고치면 커스텀 경로가 여전히 닿지 않아 눈에 보이는 변화가 없습니다. 어느 쪽을 고쳤든 믿기 전에 합성 입력으로 둘 다 시험하세요. 관련 세부 하나: 입력 심볼과 새 심볼의 합이 1인 Huffman 심볼 딕셔너리는 log2 공식에서 심볼 코드 길이 0을 받지만, Huffman 변형은 모든 심볼 ID를 최소 1비트로 기록합니다. PDF Library for Delphi는 Huffman 모드에서 그 길이를 1로 올립니다
Huffman refinement는 비트맵 크기를 어디서 읽을까요?
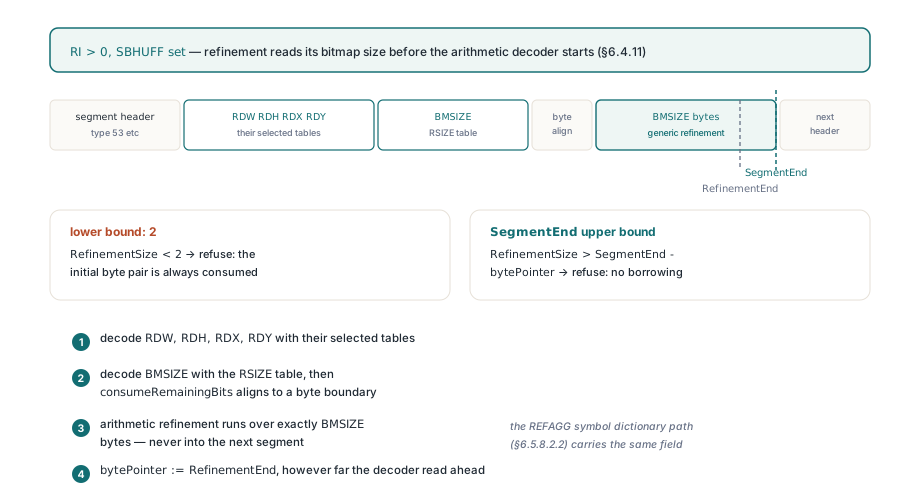
Huffman 모드에만 존재하는 BMSIZE 필드에서, arithmetic refinement 데이터보다 앞서 디코딩됩니다. 텍스트 영역 인스턴스가 refinement(RI가 0이 아님)를 갖고 SBHUFF가 서 있으면, T.88 §6.4.11은 디코더가 RDW, RDH, RDX, RDY를 각자 선택한 테이블로 읽고, 이어서 BMSIZE를 RSIZE 테이블로 읽고, 바이트 경계로 건너뛴 뒤, 그제서야 정확히 BMSIZE 바이트 위에서 generic refinement 디코딩을 돌리게 합니다. arithmetic 모드 텍스트 영역에는 그런 필드가 없으므로, 두 모드 사이에서 하나의 코드 경로를 공유하는 디코더는 그것을 건너뛰고 arithmetic 디코더를 일찍 시작해 모든 심볼을 노이즈에 대해 refinement합니다. REFAGG와 단일 refinement 인스턴스(§6.5.8.2.2)를 갖는 심볼 딕셔너리 경로에도 같은 필드가 있습니다
PDF Library for Delphi는 BMSIZE를 양쪽으로 묶습니다. 하한은 2, 즉 arithmetic 디코더가 항상 소비하는 첫 바이트 쌍입니다. 상한은 현재 세그먼트의 나머지인데, 의도적으로 전체 스트림의 나머지가 아닙니다. 다음 세그먼트에서 바이트를 빌려야 겨우 들어가는 BMSIZE는 malformed이고, 스트림 길이 검사라면 arithmetic 디코더가 뒤따르는 헤더로 읽어 들이는 걸 허용해 버립니다. 범위 밖 크기는 invalid refinement bitmap size로 실패합니다. 그 뒤 Huffman 리더는 arithmetic 디코더가 미리 읽은 것과 무관하게 필드 뒤 정확히 BMSIZE 바이트 지점에서 재개합니다
선언된 세그먼트 길이가 곧 경계
모든 세그먼트 헤더는 뒤따르는 데이터 바이트 수를 밝히고, 디코더는 양방향으로 세그먼트를 그 숫자에 묶어 둡니다. 끝을 넘겨 읽는 것은 오류이고 일찍 끝내는 것은 정상이며, 다음 헤더는 항상 파일이 시작점이라고 말한 곳에서 읽힙니다. 작은 규칙들이 따라옵니다. T.88 §7.2.7의 알 수 없는 데이터 길이는 종단자를 찾아 헤매는 대신 처음부터 거부됩니다. 참조 세그먼트는 현재 세그먼트보다 작은 번호를 달고 이미 존재해야 합니다. END_OF_PAGE와 END_OF_FILE은 데이터 바이트가 0이라고 선언해야 합니다. Profiles 세그먼트(type 52)는 정확히 4 더하기 식별자 수 곱하기 4바이트여야 하고, 이후 세그먼트가 여전히 참조할 수 있도록 건너뛰되 보관하며, 모르는 프로파일 식별자가 디코딩을 멈추지 않습니다
일찍 끝내는 고전적 사례는 MMR입니다. MMR 디코더는 마지막 행의 마지막 픽셀을 내는 순간 끝나는데, 그 시점은 T.88 §6.2.5.7이 데이터 끝에 놓는 EOFB 종단자보다 앞설 수 있습니다. 이제 다음 헤더에 앉아 있다고 가정하는 리더는 남은 EOFB 바이트를 세그먼트 번호로 파싱하고 몇 바이트 뒤, 진짜 원인과는 먼 곳에서 실패합니다. 선언된 끝으로 점프하면 그 질문 자체가 사라집니다. 같은 습관이 PDF Library for Delphi가 신뢰할 수 없는 PDF 구조를 파싱하는 방식 전반에 흐릅니다
Delphi에서 JBIG2 이미지 스트림 디코딩하기
디코더는 PDFlibJBIG2 유닛의 TPLJBIG2Decoder로 살아 있습니다. LoadFromByteArray는 /JBIG2Decode 이미지의 내장 JBIG2 데이터를, 선택적으로 /JBIG2Globals 스트림 데이터를 받는데, 커스텀 테이블과 공유 심볼 딕셔너리는 대개 그곳에 삽니다. 어떤 거부든 False를 반환하고 이유를 LastError에 남깁니다. 이전 호출의 출력은 호출이 시작할 때마다 지워지므로, 실패한 디코딩이 결과로 착각할 옛 픽셀을 남기는 일은 없습니다
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: JBIG2Decode 앞의 필터가 이미 제거된
//   이미지 스트림 데이터
// GlobalBytes: /JBIG2Globals 스트림 데이터, 혹은 빈 배열
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Form: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // 픽셀당 바이트 하나, 0 또는 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = JBIG2에서 검정
    end;
  finally
    Decoder.Free;
  end;
end;
검정 픽셀 세기는 여러분의 점검으로, 두 번째 렌더러와 비교할 싸고 값진 지문입니다. 세그먼트 수준 실패는 세그먼트 번호, 타입, 바이트 오프셋을 접두로 달고 오므로, oversubscribed Huffman prefix codes 앞의 (type 53)이 Tables 세그먼트를 곧장 가리킵니다. 두 오류 채널을 구분해 두세요. TPLJBIG2Decoder.LastError는 이 디코더의 진단 텍스트이고, TPDFlib.LastErrorCode는 라이브러리 수준 API의 숫자 코드입니다. 페이지 선택은 스트림을 따릅니다. 디코더는 처음 만난 page-information 세그먼트의 비트맵을 반환하고 페이지 연결 0을 찾아보지 않습니다. PDF에 내장된 JBIG2는 한 페이지를 실어 나르고 인코더들은 관행상 1로 매기기 때문입니다
이런 파일로 렌더러를 비교하는 일에는 겸손이 필요합니다. 독립적인 JBIG2 디코더들이 커스텀 테이블 파일과 Huffman refinement에서 항상 의견이 일치하지는 않기 때문입니다. 두 디코더가 다르다고 결론은 나지 않습니다. 결정하는 것은 포맷 필드입니다. 셀렉터들이 어떤 테이블을 골랐는지, BMSIZE가 뭐라 선언했는지, 각 세그먼트가 어디서 끝나는지
인코딩은 JBIG2 인코더 백엔드와 링크 방식 글이 다룹니다. 읽기 경로는 남의 인코더가 내놓는 무엇이든 받아야 하고, 내장 TIFF 디코더와 BigTIFF, 타일 레이아웃 검사와 규칙을 공유합니다. 이름을 적어 거부하고, 선언된 경계를 넘어 바이트를 빌리지 않고, 중간 산술은 넉넉히 유지합니다. 스캔 PDF 폴더가 다른 툴킷들을 계속 넘어뜨린다면 이미지가 커스텀 테이블을 갖춘 Huffman 코딩 JBIG2인지 확인하고, PDF Library for Delphi 제품 페이지에 설명된 네이티브 Delphi와 C++Builder 읽기 경로로 시험해 보세요