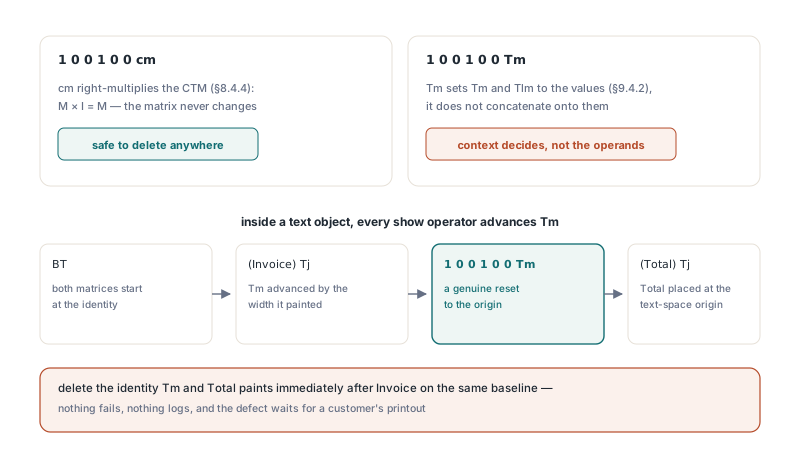
리포트 제너레이터가 쓸 법한 콘텐츠 스트림 BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET에서 여섯 숫자가 identity 행렬을 이룬다는 이유로 1 0 0 1 0 0 Tm을 잘라 버려 봅시다. 결과를 렌더링하면 "Total"은 더 이상 텍스트 공간 원점에서 시작하지 않습니다. "Invoice"가 끝난 자리, 같은 베이스라인 위에서 시작합니다. identity Tm은 텍스트 행렬과 텍스트 라인 행렬이 이미 identity를 담고 있는 동안에만 잉여입니다. BT 바로 뒤, 또는 다른 identity Tm 바로 뒤가 그 경우입니다
삭제가 유혹적인 이유는 그 여섯 숫자가 cm 앞에서는 정말로 죽은 무게이기 때문입니다. 두 연산자를 똑같이 취급하는 콘텐츠 스트림 옵티마이저는 많은 스트림을 올바르게 줄입니다. 그러다 identity Tm을 캐리지 리턴으로 쓰는 제너레이터를 만나면 텍스트가 움직입니다
1 0 0 1 0 0 Tm이 항상 no-op이 아닌 이유는?
두 연산자는 다른 산술을 합니다. ISO 32000-1 §8.4.4는 cm을 피연산자를 현재 변환 행렬에 이어 붙이는 것으로 정의합니다. 어떤 행렬도 identity를 곱하면 자기 자신이 돌아오므로 1 0 0 1 0 0 cm은 어디에서 나타나든 지울 수 있습니다. Tm은 대입입니다. §9.4.2 아래에서 텍스트 행렬과 텍스트 라인 행렬 둘 다를 피연산자로 설정하고 원래 담고 있던 것을 버리므로, 무언가를 바꾸는지는 전적으로 앞선 연산자가 좌우합니다
§9.4.1은 BT가 두 행렬을 identity에서 시작한다고 말합니다. 거기서부터 텍스트 객체 안의 거의 모든 것이 둘 중 하나를 움직입니다. Td, TD, T*, non-identity Tm은 텍스트 라인 행렬을 옮깁니다. 모든 텍스트 표시 연산자(Tj, TJ, ', ")는 방금 그린 글리프 너비만큼 텍스트 행렬을 전진시키고, 마지막 둘은 먼저 새 줄을 엽니다. 그중 하나라도 실행된 뒤의 identity Tm은 원점으로의 진짜 점프입니다. 위의 인보이스 스트림은 그 점프에 의존합니다
스트림을 손으로 추적하면 빨리 정해집니다. 인보이스 예제를 콘텐츠 스트림 CTM과 텍스트 행렬 상태 트래커에 흘려 보내면, 기록은 cm이 CTM에 이어 붙는 동안 Tm이 두 텍스트 행렬을 덮어쓴다고 보여 줍니다. 동일한 피연산자 뒤에 숨은 두 개의 다른 갱신 규칙입니다
PDF Library for Delphi가 어떤 identity Tm을 버릴지 정하는 방식
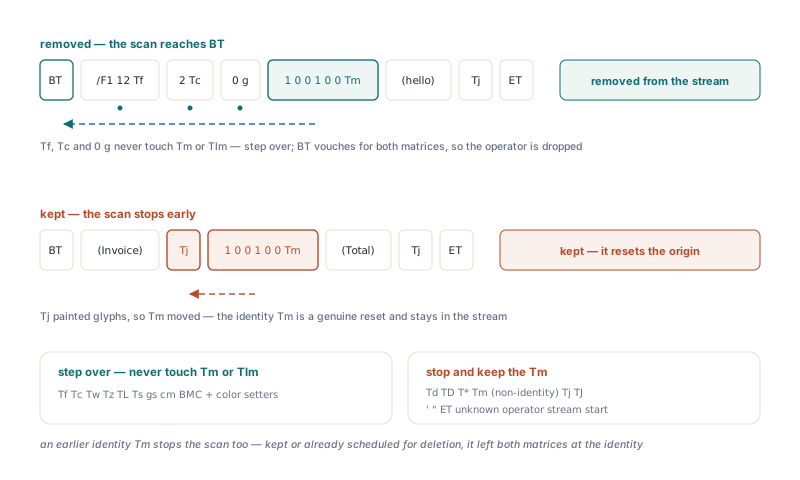
PDF Library for Delphi는 피홀 패스 동안 모든 identity cm을 버리고, identity Tm은 그 연산자에서 뒤로 걷는 스캔이 텍스트 행렬을 움직일 수 있는 무언가를 만나기 전에 BT나 다른 identity Tm에 닿을 때만 버립니다. "identity" 검사는 수치입니다. 연산자는 1, 0, 0, 1, 0, 0과 같은 여섯 숫자 피연산자를 정확히 필요로 하므로 1.0 0 0 1.0 0 0 Tm도 자격이 있습니다. 뒤로 걷는 스캔은 만나는 모든 연산자를 두 그룹 중 하나에 넣습니다:
- 멈추고 Tm을 유지:
Td,TD,T*, non-identityTm,Tj,TJ,',",ET, 파서가 인식하지 못하는 임의의 연산자, 또는 스트림의 시작 - 건너뛰고 계속 스캔:
Tf,Tc, 색 세터,gs, marked-content 연산자,Do와cm처럼 텍스트 행렬이나 텍스트 라인 행렬을 건드리지 않는 연산자들
앞선 identity Tm은 옵티마이저가 그것을 유지하든 이미 제거 예약을 해 두었든 삭제를 위해 스캔을 끝냅니다. 어느 쪽이든 그것은 두 행렬을 identity에 남겨 두었고, BT가 남겨 두는 것과 같은 상태입니다. 그래서 BT 직후의 세 개 identity Tm run은 아무것도 남기지 않고 무너집니다
보수적인 멈춤은 의도입니다. 모르는 연산자는 무엇이든 하는 벤더 확장일 수 있으므로 스캔은 그 너머를 추론하지 않습니다. ET 뒤에는 열린 텍스트 객체가 없고, 거기 앉은 identity Tm은 행렬 값을 보증해 주는 BT가 없습니다. 스캔은 한 번에 하나의 콘텐츠 스트림만 봅니다. /Contents가 배열인 페이지에서 중요합니다. PDF는 텍스트 객체가 한 스트림에서 시작해 다음 스트림에서 이어질 수 있으므로, 텍스트 객체 한가운데서, 자기 BT 없이 열리는 레이어는 앞 레이어가 잉여로 만들었을 상황에서도 identity Tm을 유지합니다
그쪽으로 실수하는 것이 옳다고 생각합니다. 스트림 경계를 넘어 행렬을 추적하거나 모르는 연산자를 시뮬레이트하는 것은 별난 파일당 압축 안 된 텍스트 열네 바이트를 건질지도 모르는 일입니다. 틀리면 인쇄된 인보이스의 글리프가 움직입니다. 비용과 위험이 같은 급이 아닙니다
출력에서 보이는 것이 달라지는 부수 효과 하나는 알아 둘 가치가 있습니다. 같은 패스가 안에 아무것도 없는 텍스트 객체도 제거하므로 BT 1 0 0 1 0 0 Tm ET는 완전히 사라집니다. identity Tm이 먼저 가고 남겨진 BT/ET 쌍이 비어 있기 때문입니다
콘텐츠 스트림 스니펫에 옵티마이저 돌리기
옵티마이저는 문자-콘텐츠 바이트 매핑 워크스루처럼 인스트럭션 수준에서 페이지 텍스트를 편집할 때 쓰는 것과 같은 파싱된 TPDFContentProgram 모델 위에서 동작합니다. 문서 전체를 믿기 전에 문자열로 규칙을 시험해 보기 쉽습니다. 아래 헬퍼는 디코딩된 스트림을 파싱하고 TPDFContentPeepholeOptimizer를 돌린 다음 결과를 한 줄에 명령 하나로 내놓습니다. Parse 전에 CanonicalNumbers를 설정하면 고정 정밀도로 모든 숫자를 다시 쓰는 세이브 시점 패스와 같아집니다
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // 세이브 패스와 같은 숫자 처리
    if not Prog.Parse(Source) then
      Exit; // 손상된 스트림: 바이트는 그대로 둠
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // 제거된 명령 수를 반환
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // 한 줄에 명령 하나, #10 구분
  finally
    Prog.Free;
  end;
end;

// 제거됨: BT 바로 뒤의 Tm, 연속한 두 identity Tm 중 둘째
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// 유지됨: Td 뒤, Tj 뒤, non-identity Tm 뒤, 또는 BT 밖의 Tm
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
인보이스 스트림을 이것에 통과시키면 identity Tm은 살아남습니다. 역방향 스캔이 BT에 닿기 한참 전에 Tj를 만나기 때문입니다. BT와 identity Tm 사이에 /F1 12 Tf, 2 Tc, 0 g를 놓으면 여전히 사라집니다. 그중 하나도 텍스트 행렬을 건드리지 않기 때문입니다. 흥미로운 사례는 BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm입니다. 정확히 한 연산자를 잃습니다. 첫 identity Tm이 Td가 만든 이동을 되돌리고 잉여인 것은 둘째뿐입니다
Parse는 종료되지 않은 문자열이나 딕셔너리 같은 중상에만 False를 반환합니다. 모르는 연산자는 잘 파싱되어 프로그램에 남고, 그곳에서 스캔의 하드 스톱으로 동작합니다
피홀 옵티마이저는 실제로 언제 도는가?
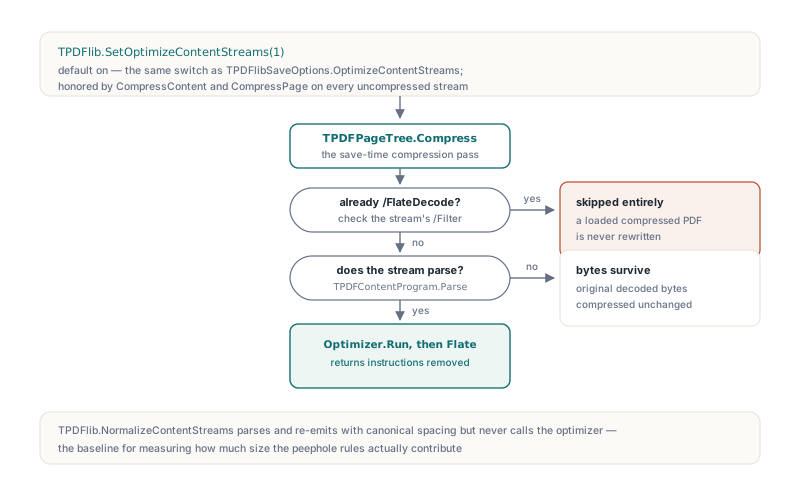
옵티마이저는 압축 패스 안에서, 그것도 이미 Flate 압축되지 않은 페이지 콘텐츠 스트림에서만 돕니다. TPDFlib.SetOptimizeContentStreams(1)이 기본값이고 같은 스위치가 TPDFlibSaveOptions의 OptimizeContentStreams 필드로 나타나며, CompressContent와 CompressPage 모두 이를 존중합니다. /Filter가 이미 /FlateDecode인 스트림은 완전히 건너뛰어지므로, 전형적인 압축 PDF를 로드해 다시 저장하면 연산자는 그대로 나옵니다. 압축 없이 저장된 스트림은 디코딩되고 최적화된 다음 Flate 압축됩니다. 스트림이 파싱에 실패하면 원래 디코딩된 바이트가 그대로 압축됩니다
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // 압축 안 된 스트림은 피홀 규칙을 거친 뒤 Flate로
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // 번들 세이브 옵션으로 같은 선택, False는 옵트아웃
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
기본값은 켜 둔 채로 두세요. 패스의 모든 변환은 출력 등가이고 identity 행렬 규칙은 많은 제너레이터가 내놓는, 모든 텍스트 객체를 BT 1 0 0 1 0 0 Tm으로 여는 패턴을 잡습니다. 끄는 것이 의미를 갖는 경우는 주로 자기가 쓴 압축 안 된 출력과 diff하거나 기준선이 필요할 때입니다. 그 기준선을 위해 TPDFlib.NormalizeContentStreams는 정규 간격과 숫자로 콘텐츠를 파싱해 다시 내놓지만 옵티마이저를 절대 부르지 않으므로, 정규화 저장과 최적화 저장의 크기 격차가 피홀 규칙이 기여한 것입니다. 폰트 서브셋팅으로 PDF 파일 크기 최적화가 다루는 더 큰 절감 옆에서는 소박할 것으로 기대하세요
하나의 모양을 커버하는 테스트는 규칙을 정의하지 않는다
BT 1 0 0 1 0 0 Tm (hello) Tj ET를 옵티마이저에 먹이고 Tm이 남지 않았음을 단언하는 테스트는 하나의 모양, 즉 BT 바로 뒤의 identity Tm이 제거된다는 것만 못 박습니다. Td 뒤나 표시된 텍스트 뒤의 identity Tm에 대해서는 아무것도 말하지 않습니다. 그 단언 하나를 "identity Tm은 항상 제거 가능"으로 읽는 것은 쉬운 실수이고, 표본이 어느 쪽이든 통과하기 때문에 값비싼 실수입니다. 이런 규칙의 테스트에는 제거 가능한 모양 옆에 유지되는 모양을 적어 둘 것이 필요합니다
아래 헬퍼는 살아남는 Tm 연산자를 세고 입력 테이블을 검사합니다. ExpectTm을 자기 테스트 프레임워크의 단언으로 바꾸세요. 라이브러리의 일부가 아닙니다
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1은 파싱 실패를 알림
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// 여기서 제안하는 자기 검사 헬퍼; 실제 단언으로 교체할 것
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // 제거 가능한 모양
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // identity Tm을 유지해야 하는 모양
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // 감싸는 BT가 없음
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // ET 뒤
end;
마지막 두 행은 계층화된 /Contents 배열이 정확히 그 조각들을 만든다는 것을 떠올리기 전까지는 우스꽝스러워 보입니다. 텍스트 객체 한가운데서 시작하는 스트림에는 BT가 없고, ET 뒤의 identity Tm은 어떤 텍스트 객체에도 속하지 않습니다. 둘 다 유지됩니다. 마지막 행의 빈 BT ET 쌍은 빈 텍스트 객체 규칙이 제거하는데, 그래서 개수 검사가 문자열 전체 비교가 아니라 Tm 연산자를 세는 것입니다
규칙이 포기하는 것은 텍스트 객체 한가운데의 이따금 있는 identity Tm, Flate가 보기도 전에 페이지당 몇 바이트입니다. 사는 것은 패스의 설계가 기대는 보장입니다. 패스의 어떤 변환도 보이는 페이지를 바꾸지 않습니다. 텍스트를 움직이는 크기 옵티마이저는 좋은 압축률을 가진 렌더링 버그입니다
Delphi나 C++Builder에서 PDF 콘텐츠를 생성하거나 후처리한다면, PDF Library for Delphi and C++Builder가 위의 저장 옵션과 함께 콘텐츠 스트림 파서와 이 피홀 패스, 그리고 비교할 깨끗하고 최적화되지 않은 기준선을 만드는 NormalizeContentStreams를 함께 실어 나릅니다