고객 코멘트를 제대로 이스케이프해서 <b>urgent</b>가 HTML 템플릿에 <b>urgent</b>로 들어가게 하고, 마크업을 두 번 파싱하는 렌더러에 넘기면 PDF는 urgent라는 단어를 굵게 돌려줄 수 있습니다. 이스케이프는 올바랐습니다. 렌더러가 패스마다 한 번씩 디코딩한 것입니다. 파싱하고, 결과를 HTML로 다시 쓰고, 다시 파싱하는 모든 HTML-to-PDF 경로는 여정 전체에서 entity를 정확히 한 번만 디코딩해야 합니다
이 이야기의 헬프데스크판은 평범합니다. 티켓이 PDF로 익스포트되고 고객 코멘트가 <p> 안에 앉아 있는데 누군가 코멘트 상자에 각괄호를 타이핑합니다. 모르는 태그 이름은 페이지에서 그저 사라집니다. 이스케이프된 앵커는 직원들이 신뢰하는 문서에서 클릭 가능한 링크 주석이 됩니다. 파일은 유효하고 어디서든 열리며, 그저 데이터와 다른 무언가를 말하고 있을 뿐입니다
이스케이프된 텍스트가 다시 마크업으로 돌아가는 곳
이스케이프된 텍스트가 두 패스 렌더러가 이미 디코딩된 텍스트를 다시 이스케이프하지 않은 채 HTML로 써 넣는 지점에서 마크업이 됩니다. 첫 파싱이 디코딩한 것은 그 순간부터 두 번째 파싱의 살아 있는 문법입니다
PDF Library for Delphi(PDFlibPas)의 DrawHTMLText와 DrawHTMLTextBox의 두 패스에는 그럴 만한 이유가 있습니다. 첫 파싱은 입력을 태그와 워드로 쪼갭니다. 그런 다음 렌더러는 스타일시트 cascade를 해석합니다. <style> 블록의 규칙이 태그마다 매치되고 inline style 속성과 병합되어, 최종 스타일을 달고 있는 엘리먼트 목록 전체가 하나의 정규화된 HTML 문자열로 다시 기록됩니다. 조판 패스는 그 문자열을 파싱합니다. PDFlibPas HTML 렌더링의 flexbox, CSS grid, 각주 조판에서 설명한 셀렉터 매칭, flexbox, grid 등 CSS 지원 전부가 그 중간 단계에 의존합니다
위험은 워드가 어떻게 돌아오느냐에 있습니다. 태그는 소스 형태에서 다시 쓸 수 있지만 워드는 디코딩된 텍스트로 쥐고 있고, 행 나누기가 재는 것이 바로 그것입니다. <unsafe>에서 온 워드를 있는 그대로 정규화 문자열에 덧붙이면 <unsafe>가 엘리먼트로 두 번째 파싱에 도착합니다. 한 번 디코딩하는 설계는 더 작은 누수 셋도 막아야 합니다
&가 디코딩 집합에 없으면R&D가 문자 그대로 인쇄되고,<철자를 텍스트로 페이지에 놓을 방법은 아예 없습니다- 파싱이 끝난 뒤 그리기 단계가
를 또 바꾸면, literal entity 철자가 맨 마지막 순간에 사라집니다 - Markdown 변환기나 데이터셋 익스포터 같은 상류 HTML 작성자가 각괄호만 이스케이프하면, 코드 샘플이나 셀 값 안의 entity 철자가 마크업으로 디코딩됩니다
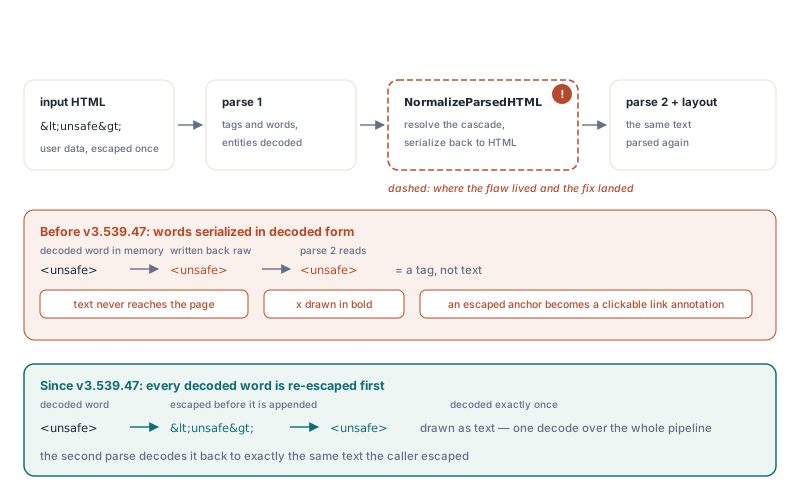
아래 표는 몇몇 입력이 페이지에 무엇으로 도달하는지 나열하며, 순진한 두 패스 렌더러와 PDFlibPas 파이프라인을 비교합니다
| 렌더러에 도달하는 입력 | 순진한 두 패스 렌더러 | PDFlibPas |
|---|---|---|
<unsafe> | 태그로 파싱됨, 텍스트는 페이지에 도달하지 못함 | <unsafe>가 텍스트로 그려짐 |
<b>x</b> | x가 굵게 그려짐 | <b>x</b>가 텍스트로 그려짐 |
R&D | R&D가 문자 그대로 인쇄됨 | R&D |
&lt; | &lt;가 문자 그대로 인쇄됨 | < |
를 담은 Markdown 코드 스팬 | 논브레이킹 스페이스 | 가 텍스트로 그려짐 |
데이터셋 셀 값 < | < | < |
PDF Library for Delphi는 각 entity를 어떻게 정확히 한 번만 디코딩하나?
PDF Library for Delphi는 세 규칙을 함께 따라 각 entity를 정확히 한 번 디코딩합니다. 파서가 &를 마지막에 디코딩하고, 그리기 단계는 아무것도 디코딩하지 않고, 디코딩된 워드를 HTML로 되돌리는 모든 곳이 먼저 이스케이프합니다. 셋 중 하나라도 빠지면 위 표의 한 행이 순진한 열로 넘어갑니다
무엇이 디코딩되는지부터입니다. 텍스트 콘텐츠에서 파서는 <, >, &, 를 인식합니다. A 같은 숫자 참조와 " 같은 이름 entity는 literal 텍스트로 남습니다. 그 짧은 목록이 여러분 입력을 어떻게 이스케이프해야 하는지를 결정하는데, 뒤에서 다시 나옵니다
디코더 안의 순서는 단일 패스 안에서도 중요합니다. &를 먼저 디코딩하면 입력 &lt;가 <가 되고, 바로 다음 치환이 그것을 <로 만듭니다. 두 번째 파싱 없는 이중 디코딩입니다. 그래서 8비트 워드 경로는 <, >, 를 먼저, &를 마지막에 바꿔, 자기가 만들어낸 앰퍼샌드는 다시는 들여다보지 않게 합니다. UTF-16 워드 경로는 다른 길로 같은 결과에 닿습니다. 2바이트 스텝의 한 방향 스캔 하나가 각 매치를 제자리에서 다시 쓰고 그것을 지나쳐 갑니다
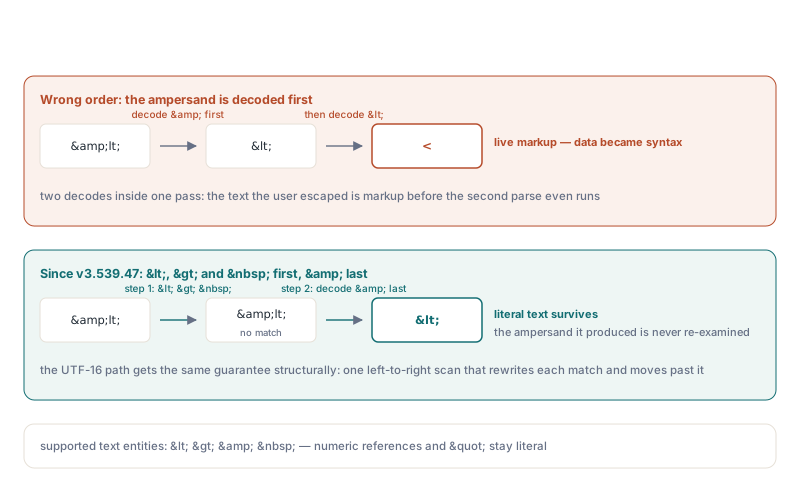
그리기 단계는 늦은 치환을 받지 않습니다. 행 나누기에 도달한 워드는 최종 텍스트이고, 디코딩은 파서에만 삽니다
경계 규칙이 가장 큰 몫을 차지합니다. 렌더러는 정규화된 HTML을 쓸 때 모든 디코딩된 워드의 &, <, >를 덧붙이기 전에 이스케이프하고, 두 번째 파싱이 그것을 같은 문자로 다시 디코딩합니다. 두 패스를 합친 순효과: 디코딩 한 번. DrawHTMLTextBox가 돌려주는 continuation 문자열도 같은 규칙을 따릅니다. 들어가지 못한 워드는 나머지에 들어가기 전에 이스케이프되고, 나머지의 나머지는 이미 이스케이프된 정규화 HTML에서 복사됩니다. 전부 담은 상자는 빈 문자열을 돌려줍니다
UTF-16BE 이스케이프는 바이트 수준 치환을 쓰면 안 되는 이유는?
UTF-16BE 이스케이프는 바이트 수준 치환을 쓸 수 없습니다. 앰퍼샌드의 두 바이트가 서로 무관한 두 문자에 걸칠 수 있기 때문입니다. 안전한 작업 단위는 16비트 코드 유닛 전체입니다
렌더러는 Unicode 워드를 상위 바이트가 먼저인 big-endian UTF-16으로 바이트 문자열에 포장해 두므로, 앰퍼샌드는 00 26입니다. U+0100(마크롱 라틴 대문자 A, 바이트 01 00) 뒤에 U+2603(눈사람, 바이트 26 03)을 놓으면 버퍼는 01 00 26 03을 읽고 두 번째와 세 번째 바이트가 00 26의 철자입니다. #0'&'를 찾는 바이트 검색은 어느 문자도 담지 않은 앰퍼샌드를 찾아 두 code point 한가운데 &를 이어 붙이고 뒤따르는 모든 문자를 한 바이트 밉니다
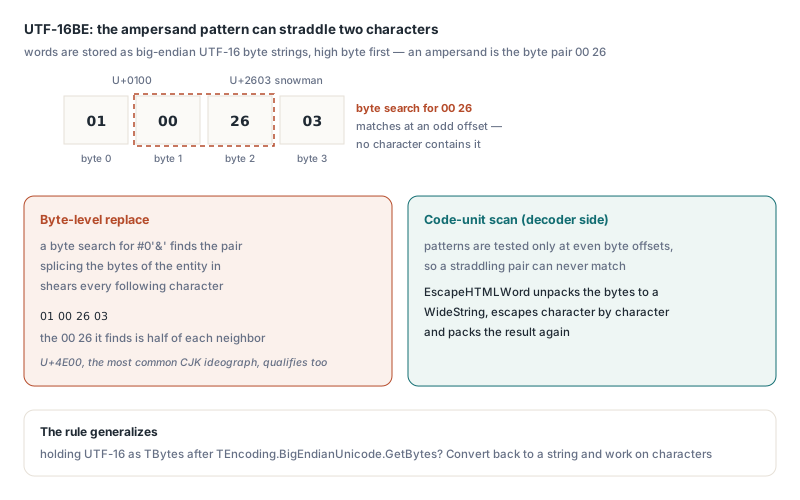
흔치 않은 구석이 아닙니다. 하위 바이트가 0인 문자라면 누구든 앞 절반을 공급할 수 있고, 가장 흔한 CJK 한자 중 하나인 U+4E00이 바로 그런 문자입니다. 각괄호도 같은 방식으로 노출됩니다. 그런 문자 뒤에 CJK Extension A의 U+3C00부터 U+3EFF까지 문자가 오면 00 3C와 00 3E가 나타납니다. 그래서 PDFlibPas는 Unicode 워드를 WideString으로 풀고 문자 단위로 이스케이프한 뒤 다시 포장합니다. 디코더도 맞는 이유로 안전합니다. 짝수 오프셋에서만 패턴을 검사하기 때문입니다
여러분 코드도 같은 벽을 만날 수 있습니다. UTF-16 텍스트가 TBytes에 살기 시작하면, 이를테면 TEncoding.BigEndianUnicode.GetBytes 뒤에, 바이트 패턴 검색은 올바른 문자 쌍을 기다리는 버그입니다. 문자열로 되돌리고 문자 위에서 작업하세요
Markdown code와 데이터셋 셀: 앰퍼샌드가 먼저다
PDFlibPas 안의 두 HTML 작성자, 즉 Markdown 변환기와 데이터셋 익스포터는 각괄호 전에 앰퍼샌드를 이스케이프하므로, 렌더러의 단 한 번 디코딩이 원본 텍스트를 바이트 단위로 복원합니다
MarkdownToHTML에서 inline 코드 스팬과 fenced 혹은 들여쓴 코드 블록은 &를 &로, <를 <로, >를 >로 바꿉니다. 공백은 가 되고 탭은 네 개가 되어 들여쓰기가 지켜집니다. 평범한 산문은 각괄호만 이스케이프합니다. 산문에 타이핑된 raw HTML은 태그를 주입할 수 없고, &를 일부러 쓴 작성자는 여전히 앰퍼샌드를 얻어 Markdown 작성자가 기대하는 대로 됩니다. DrawMarkdownText와 DrawMarkdownTextBox도 같은 변환을 돌리므로 코드 블록은 타이핑된 그대로 나옵니다
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// HTML을 들여다보면: 코드 안에서 '&'는 '&'로, '<'는 '<'로
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // 좌상단 원점, Y는 아래로 자람
Lib.SetMeasurementUnits(0); // 포인트
// 페이지는 타이핑된 그대로, entity 철자까지 코드를 보여 줍니다
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;유혹적인 지름길이 사는 곳이 데이터셋 익스포터입니다. 렌더러가 &를 디코딩하지 않는다면 앰퍼샌드를 이스케이프하는 순간 앰퍼샌드를 담은 모든 셀이 &를 인쇄하므로, 각괄호만 이스케이프하는 편이 더 친절해 보입니다. 값이 우연히 <를 담은 첫 셀에서 무너지고, 그것이 <로 페이지에 도착합니다. 렌더러가 &를 디코딩하므로 PDFlibExportDataSet 뒤의 익스포터는 &를 먼저 이스케이프하고, R&D < & 같은 값이 PDF에 그대로 착지합니다. 그 익스포터의 나머지는 Delphi에서 TDataSet을 PDF 리포트로 익스포트하기가 다룹니다
왜 어딘가가 아니라 첫 번째여야 할까요? <를 먼저 이스케이프하면 <가 나오고, 이어서 &를 이스케이프하면 &lt;가 되는데, 올바른 단일 디코딩은 그것을 <가 아니라 <로 표시합니다. 순차 치환 체인은 이스케이프 문자 자신이 그것을 만들어내는 단계보다 먼저 다뤄질 때만 동작합니다
DrawHTMLTextBox용 신뢰할 수 없는 텍스트는 어떻게 이스케이프해야 할까?
신뢰할 수 없는 텍스트 콘텐츠는 &, 이어서 <, 이어서 > 순서로 정확히 한 번씩 바꿔 PDFlibPas용으로 이스케이프하고, 신뢰할 수 없는 데이터는 속성 값에 아예 넣지 마세요. 아래 헬퍼는 직접 추가하시면 되는 평범한 RTL 코드입니다
uses
System.SysUtils, PDFlibrary;
// 여러분의 헬퍼(라이브러리 일부 아님): 신뢰할 수 없는 텍스트를
// PDFlibPas HTML 텍스트 콘텐츠용으로 이스케이프합니다. '&'는 먼저,
// 교체해야 합니다. 그러지 않으면 새로 만들어진 '<' 안의
// 앰퍼샌드가 두 번 이스케이프됩니다
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;코멘트 Try <a href="https://example.com">this</a> & <b>를 넣으면 페이지는 그 문자들을 하나 대 하나로 보여 줍니다. 두 번 디코딩하는 렌더러 아래에서 같은 이스케이프된 입력은 살아 있는 링크 주석이 됩니다. 광학적 결함에서 보안 문제로 넘어가는 단계입니다. 티켓 코멘트는 우리 직원에게 가는 PDF에 클릭 가능한 URL을 심을 수 있어서는 안 됩니다
헬퍼가 손대지 않는 것도 눈여겨보세요. 범용 이스케이퍼는 또한 "를 "로, '를 '로 바꾸는데, 브라우저엔 맞지만 여기선 틀립니다. PDFlibPas 텍스트 디코딩은 앞서 나열한 네 entity만 알므로 그 둘은 "와 '로 문자 그대로 인쇄됩니다. 브라우저 이스케이퍼를 재사용하지 마세요. 따옴표는 텍스트 콘텐츠에선 무해하고 속성 값 안에서만 문제인데, 렌더러는 속성의 entity를 전혀 디코딩하지 않습니다. 속성에는 영리한 이스케이퍼보다 규칙이 낫습니다. 어차피 거기서는 어떤 이스케이프 방식도 검사되지 않으니, 사용자 값을 href, src, style에서 배제하세요. 링크 대상이 정말 사용자 입력에서 와야 한다면 스킴과 문자 allow-list로 직접 검증하고 따옴표나 각괄호를 담은 것은 거부하세요
두 가지 습관이 단일 패스 디코딩에서 곧장 나옵니다
- 늘
&를 이스케이프하세요. 건너뛰면<를 담은 사용자 텍스트가<로 보입니다. 무해하지만 사용자가 타이핑한 것이 아니죠 - 이스케이프는 한 곳에서만. 두 이스케이퍼를 통과한 텍스트는
<를 보이는 철자<로 렌더링하므로, 데이터가 HTML 문자열에 진입하는 단 하나의 장소를 찾아 거기서 이스케이프하세요
이스케이프를 깨지 않고 LeftOverText로 페이지 나누기
DrawHTMLTextBox는 들어가지 못한 HTML을 돌려주는데, 대개 LeftOverText라 불립니다. 그 나머지는 다음 상자에 들어갈 때 literal entity 철자와 이스케이프된 각괄호를 온전히 지킵니다. 받은 그대로 돌려보내세요
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // 포인트 단위 A4 페이지에 맞춘 크기
  BoxHeight = 740;
  MaxPages = 500;    // 여러분의 안전 상한

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // 나머지는 이미 이스케이프된 HTML입니다. 절대 다시 이스케이프하거나 풀지 마세요
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;
나머지는 불투명하게 다루세요. 스타일이 이미 각 태그에 해석된 정규화 HTML이라, 여러분 이스케이퍼에 통과시키면 모든 <가 &lt;로 변하고, 디코딩하면 다음 상자에 살아 있는 태그를 넘겨 줍니다. 새 사용자 텍스트를 그 안에 이어 붙이는 것도 같은 두 실패 모드를 갖습니다. 페이지 상한은 비교 하나의 비용입니다. 어떤 엘리먼트도 상자에 영영 맞지 않는다면 상한 없는 루프에는 자연스러운 출구가 없습니다
Markdown에는 자체 continuation이 있습니다. DrawMarkdownTextBox는 마커 코멘트로 시작하는 나머지를 돌려주고, 그것은 Markdown 진입점들이 다음 호출에서 변환을 건너뛰게 합니다. LeftOverText를 DrawHTMLTextBox에 돌려보내듯 그것을 DrawMarkdownTextBox나 DrawMarkdownText에 돌려보내세요. Markdown 나머지는 Markdown 진입점의 소유이므로 그쪽에 두고, DrawHTMLTextBox 나머지만 HTML 호출로 보내세요
이 모든 것의 뒤에 있는 모양, 즉 파싱하고 같은 문법으로 다시 쓰고 다시 파싱하는 모양은 템플릿 엔진과 HTML 새니타이저, Markdown-to-HTML-to-PDF 체인에서도 나타나며 실패는 두 방향으로 옵니다. 재인코딩이 너무 적으면 데이터가 문법이 되고, 너무 많거나 디코더가 두 번 돌면 entity 철자가 독자에게 보이거나 삼켜집니다. 한 방향만 고치면 다른 쪽이 깨지기 쉬워, PDFlibPas 렌더러는 & 디코딩과 마지막 디코딩, 늦은 디코딩 부정, 모든 경계에서의 재이스케이프를 하나의 꾸러미로 다룹니다. 내보내는 방향도 Delphi에서 PDF를 Markdown과 DOCX로 의미론적 익스포트에서 같은 규칙을 따르며, 각 literal 문자는 대상 문법에 정확히 한 번 이스케이프됩니다
HTML과 Markdown 그리기, 데이터셋 리포트 익스포터, 조판 엔진의 나머지는 PDF Library for Delphi의 네이티브 Pascal 소스로 온며 Delphi와 Free Pascal 모두를 위한 것입니다. 에디션과 플랫폼 커버리지, 체험판 다운로드는 PDF Library for Delphi 제품 페이지에 나열되어 있습니다