スキャンのバッチは、ページごとに JPEG 1 枚だけ、フォントも注釈もブックマークもないのに、それでも PDF/raster として失敗しえます。ISO 23504-1 は、ラスタのみのページ以上のものをファイルに要求します。トレーラー領域の %PDF-raster-1.0 コメントで自分を識別し、XMP メタデータとトレーラーの /ID を運び、カタログと Info 辞書を短い許可リストに収めること。だからキャプチャバッチの検査には、2 通りの読みが要ります。生バイトへの読みと、各ページが実際に何を描くかへの読みです
同じファイルへの 2 つの読み
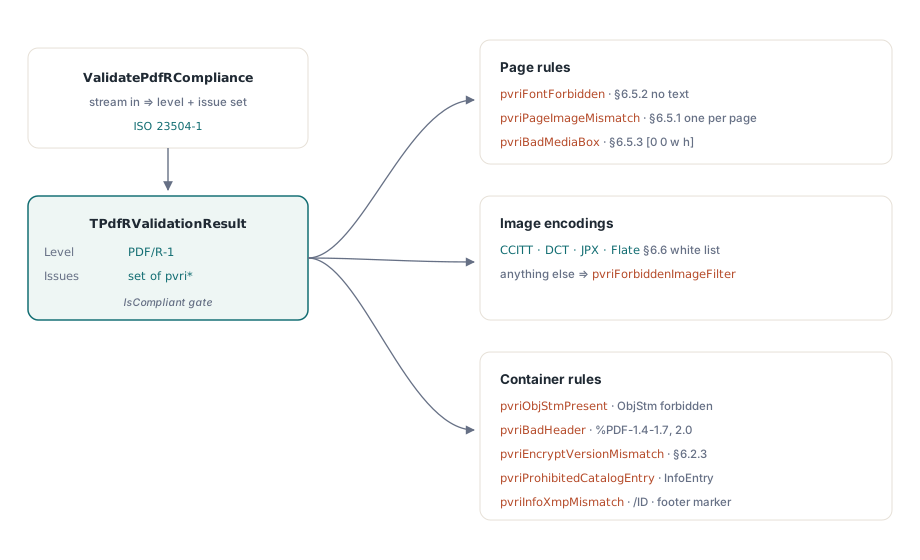
PDF/R 検証と SaveAsPdfR は、PDFium Component の Small Business と Enterprise エディションに同梱され、検証をその線に沿って分割します。FPdfPdfr ユニットの ValidatePdfRCompliance はストリームを読み、バイトレベルの規則を確認します。ヘッダーのバージョン、raster マーカー、オブジェクトストリーム、カタログと Info のエントリ、XMP、トレーラーの /ID、MediaBox の原点、フォントリソース、禁止フィルタ名、そして画像オブジェクトの数がページ数と一致するか。ValidatePdfRPageFacts は、TPdfRPageFacts レコードから 1 ページずつ確認します。ページが描くテキスト、パス、フォーム、シェーディングのオブジェクトの数、単一のストリップ画像がどこに座るか、そのピクセルサイズ、ビット深度、色空間、フィルタチェーンです
両方の読みは 1 つの列挙型 TPdfRValidationIssue で報告し、結合されたエントリポイントはそれらを 1 つの TPdfRValidationResult にまとめます。その Conformance フィールドが prc1 になるのは、raster マーカーが見つかったときだけです。IsCompliant が True を返すのは、レベルが prc1 で問題集合が空のときだけです。他のすべての点で完璧なのにマーカーを欠くファイルは prcNone を報告します。きれいなスキャンを初めて通した人が驚くのはここです
問いは、ページの事実がどこから来るかです。TPdf.ValidatePdfR はロード済み文書から収集しますが、まずその文書を一時ストアへシリアライズし、再保存されたコピーにバイト検査を走らせます。だからマーカーとカタログの判定は、新鮮な保存を述べていて、ディスク上のファイルとは違うことがあります。FPdfBusinessWorkflows の ValidatePdfRasterSource は、入力ストリームのスナップショットを 1 回取り、両方の読みをそれに対して走らせます。アーカイブに入ろうとしているファイルには、こちらの呼び出しを使うべきです。判定が、アーカイブされるバイトを指すことになります
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // 既定の予算は 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // 自分たちのキャプチャ契約
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues はバイトレベルの問題とすべてのページ問題を保持する
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues がどのページを再スキャンすべきか教える
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // 機械可読の判定をアーカイブファイルの隣に残す
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
TPdfRasterSourceValidationOptions の既定値には、スキャンバッチに関わるものが 2 つあります。MaxInputBytes は 64 MiB、MaxPages は 1000 です。カラーの長いバッチはバイト予算を超えられ、そのとき検査は status prssBudgetExceeded で Complete False とともに終わります。MemoryLimitBytes は 8 MiB で、これを超えるとスナップショットは TemporaryDirectory へこぼれ、レポートは SnapshotSpilled を立てます。Report.IsCompliant は Complete も要求するので、途中で止まった検査が合格に読めることはありません
なぜ OCR テキストレイヤーは PDF/R に落ちるのか
ラスタページはスキャン画像を描くだけで、他に何も描かないからです。不可視の OCR レイヤーは PDF/A のワークフローではごく普通の追加で、PDF/R が排除する 2 つのものをファイルに入れます。バイト読みが pvriFontForbidden として報告するフォントリソースと、ページ読みが pvriNonRasterPageContent として報告するページ上のテキストオブジェクトです。同じページ問題はベクターパス、シェーディング、フォーム XObject でも発火します。押印されたページ番号や描画された罫線も、隠しテキストと同じように落ちます
ページと画像の関係も厳格です。各ページは、ストリップ画像をちょうど 1 つ運ばなければなりません。pvriPageImageMismatch は、画像のないページにも、スキャンが 2 つの画像を並べて書かれたページにも発火します。バイト側では、その数は /Subtype が /Image のすべてのオブジェクトの上で数えられるので、余分な画像オブジェクト、たとえばストリップに付けられたソフトマスク 1 個で、合計はページ数を超えます
ジオメトリには 2 つの検査があります。pvriBadMediaBox は [0 0 ...] で始まらない MediaBox を報告し、バイト読みはインラインの数値配列を検査します。ページ読みはさらに、ストリップの描画境界を MediaBox と比較し、どれかの辺が GeometryTolerancePoints(既定 0.5 ポイント)より外れていたら pvriStripGeometryInvalid を報告します。画像をページの 98% に縮めて白マージンを残すスキャナドライバは、画面ではページが問題なく見えても、ここで落ちます。マージンが許される社内ファイルでは、RequireFullPageStrip を False にするとカバレッジテストが切れます
どの画像エンコーディングが通るか
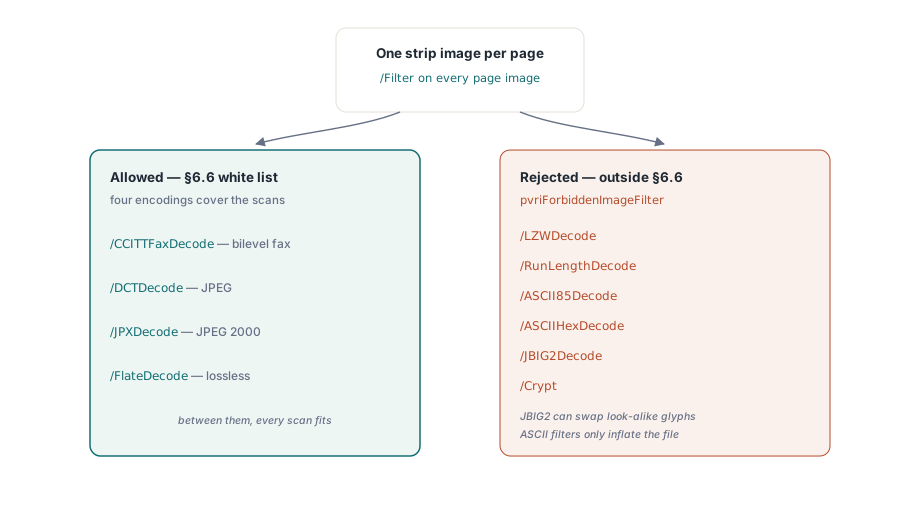
バリデータが受け入れるストリップフィルタは 4 つ、/CCITTFaxDecode、/DCTDecode、/JPXDecode、/FlateDecode です。バイト読みは他の標準フィルタを名指しで pvriForbiddenImageFilter として立てます。/LZWDecode、/RunLengthDecode、/ASCII85Decode、/ASCIIHexDecode、/JBIG2Decode、/Crypt です
JBIG2 は、キャプチャチームが最初に突き当たる拒絶です。PDF/A では許され、2 値ページを非常によく圧縮するので、PDF/A 向けに作られたキャプチャプロファイルはすでにこれを出力しているかもしれません。その非可逆なパターンマッチングモードは、スキャンされたグリフをよく似た別のグリフに置き換えることで知られており、スキャンされた帳票の数字での文書化された問題です。ラスタアーカイブが存在するのはまさに、紙にあったものがファイルの中にあるためにこそです。それらのページを CCITT Group 4 で再エンコードすれば、2 値かつ可逆のまま保てます
ページ読みは 1 歩進んで、フィルタチェーンを画像のビット深度と色空間と一緒に見て、不一致を pvriImageCompressionParametersInvalid として報告します
- フィルタが 2 個以上のチェーンは拒まれます。だから ASCII85 で包まれた Flate 画像は 2 回落ちます。バイト側で 1 回、ここで 1 回です
/CCITTFaxDecodeは 1 ビットの DeviceGray ストリップに座っていなければなりません/DCTDecodeは DeviceGray か DeviceRGB の 8 ビットか 24 ビットのストリップに座っていなければなりません/FlateDecodeは 1 ビットのストリップで受け入れられます。24 ビットの Flate ページはこの検査で落ちます/JPXDecodeは 1、8、24 ビット/ピクセルで受け入れられます
フィルタとは独立に、色空間が DeviceGray でも DeviceRGB でもないストリップは pvriImageColorInvalid を受け取ります。だから ICC ベースや CMYK のスキャンは、包む前に変換が必要です。それをやる最も安い場所はスキャナのプロファイルで、どの PDF も書かれる前にです
ストリップの解像度はどう導出されるか
画像が自分の解像度を持っているとき、ページ読みはそれを使います。持っていないとき、実効解像度はピクセルとページサイズから導かれます。ピクセル幅 × 72 ÷ ポイント単位の MediaBox 幅、高さも同様です。スキャナが 2550 × 3300 ピクセルのストリップを、612 × 792 ポイントの US Letter ページに書いたとしましょう。これは両方向でちょうど 300 dpi になります。同じページが 600 × 776 ピクセルだと、横方向は約 70.6 dpi で、既定の最小値 72 を下回るので、そのページは pvriImageResolutionInvalid を受け取ります
TPdfRValidationOptions の既定範囲は 72 から 2400 dpi です。この境界が捕まえるのは、明らかに壊れたページだけです。キャプチャ契約はたいてい、具体的な最小値、たいてい 200 か 300 dpi を約束します。その値は MinimumResolutionDpi に入れます。150 dpi のページは既定範囲を通り、契約が排除するために書かれたまさにそのページだからです。どちらかの境界を 0 にすると、その側の検査が切れます
ValidatePdfRPageFacts は公開されているので、PDF が 1 つも存在する前に、スキャナが各画像について報告したことから、まっすぐ同じ規則を走らせられます
uses
  FPdfPdfr;

// スキャナ出力からページの事実を組み立てる。このヘルパーはあなたのもの。ライブラリの一部ではない
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // ストリップはページ全体をカバーする
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi は 0 のまま。導出される
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray、2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // Letter での 300 dpi カラー JPEG。空集合
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // 同じページを 24 ビットで Flate 圧縮すると:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
カタログ、Info 辞書、XMP
必須の /Type と /Pages のほか、ISO 23504-1 がカタログに許すのは Version、ViewerPreferences、PageLayout、PageMode、AcroForm、Metadata だけです。バリデータは、その集合の外にある 21 個の標準キーに対してカタログを確認し、どれかが現れたら pvriProhibitedCatalogEntry を立てます。中には Outlines、Names、PageLabels、OpenAction、StructTreeRoot、MarkInfo、Lang、OCProperties、OutputIntents がいます。最後のものは実務上の意味があります。PDF/A のファイルは常に出力インテントを運ぶので、1 つのファイルが両方のプロファイルを満たすことはできません
Info 辞書が持てるのは Creator、Producer、CreationDate、ModDate です。Title、Author、Subject、Keywords、Trapped は pvriProhibitedInfoEntry を立てます。/Metadata ストリームのないカタログは pvriMissingXmpMetadata を受け取ります。ストリームはあるのにその XMP が xmp:CreateDate、xmp:ModifyDate、xmp:MetadataDate のどれかを欠くときは、代わりに pvriMetadataInvalid です。pvriInfoXmpMismatch は Producer を pdf:Producer と、Creator を xmp:CreatorTool と比較します。日付はその比較から外されています。2 つのエンコーディングは正当に違いうるからです。16 進文字列として格納された Info 値はスキップされます。典型的な引き金は、後のツールが XMP に触れずに Info の Producer を書き直すことです
残りのコンテナ規則は短いものです。ヘッダーは %PDF-1.4 から %PDF-1.7 か %PDF-2.0 でなければならず(pvriBadHeader)、/Type /ObjStm のストリームは pvriObjStmPresent を立て、暗号化ファイルは %PDF-2.0 ヘッダーを使わなければなりません(pvriEncryptVersionMismatch)。RequireEncryptedPdf20Profile をオンのままにしていると、暗号化辞書はさらに /V 5 か 6 を /R 5 以上で宣言しなければならず、さもなければファイルは pvriEncryptedPdf20ProfileInvalid を受け取ります
マーカーを書く
TPdfRSaveOptions は Creator、Producer、CreationDate、ModDate、DocumentId、InstanceId を運び、Title、Author、Subject、Keywords のフィールドはありません。プロファイルが禁止しているからです。StripInfoOptionalEntries と StripCatalogOptionalEntries はどちらも既定で True で、除外されたエントリをソースから取り除きます。どちらかを False にすると、エントリは残り、適合を犠牲にします。TPdf.SaveAsPdfR は、空のオプションフィールドをロード済み文書自身のメタデータとファイル識別子から埋め、セキュリティを取り除き、それからマーカー、刈り込まれた辞書、XMP パケット、トレーラーの /ID を書きます
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer、日付、ID はソースから来る
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // 確かめるのは書かれたバイトであって、メモリ上の文書ではない
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;ラップが変えるのはメタデータと識別だけです。ベクターテキストを描くソースページや、ストリップ画像を持たないページは、SaveAsPdfR から、同じページ内容のまま出てきて、同じページ検査で落ちます。ページ内容がそのまま残されるのは意図的です。スキャンを黙って再レンダリングすると、アーカイブが保存しようとしているまさにそのピクセルが変わってしまうからです。最初の一覧の CheckDeliveredScan を OutFile に走らせれば、ページ読み込みの完全な判定が得られます
キャプチャパイプラインでPDF/Rが当てはまる場所
PDF/R が似合うのは、スキャンそのものが記録で、忠実さが契約の全部である納品物です。証拠イメージング、小切手と送金のキャプチャ、大判スキャナからの図面アーカイブ。文書が検索可能なテキスト、タグ付け、添付、ブックマークを必要とした瞬間、それは PDF/A の領分です。それらの機能はすべて、上の排除リストに着地するからです
両方を併用するチームは多いです。PDF/R のオリジナルは 1 回書かれて決して変わらず、OCR レイヤー付きの PDF/A の派生が検索に仕えます。バリデータは互いに独立しているので、1 つのバッチ仕事で、各ファイルをそのファイルが名乗るプロファイルに対して検査できます。アーカイブ側は PDF/A アーカイブ適合と PDF/A プリフライト検証で、印刷出力は 印刷対応 PDF/X 文書の検証で扱います
ここで示した PDF/R の検査は、PDF/A、PDF/X、PDF/E、PDF/UA のバリデータと並んで、Delphi、C++Builder、Lazarus 向け PDFium Component の Small Business と Enterprise エディションの一部です。エディションと対応 IDE のバージョンは PDFium Component 製品ページにあります