アーカイブ取り込みゲートは、机上のどのビューアでも問題なく開く「PDF/A-2b」ファイルの一括投入を拒否した。供給元は準拠していると断言したが、そうではなかった。各ファイルには catalog の奥に埋め込まれた JavaScript action が入り、そうしたものは目視ではまず見つからず、veraPDF のような完全な PDF/A validator だけが一瞬でフラグを立てる。問題は、ファイルごとに yes-or-no を 1 つ返すためだけに Java の toolchain を Delphi の batch service に載せたくなかったことだ。それがValidatePdfACompliance PDFium Component が埋める空白であり、content stream を完全に解析せずに結論へどう至るのかを理解する価値がある
なぜ PDFium 自体ではこれに答えられないのか
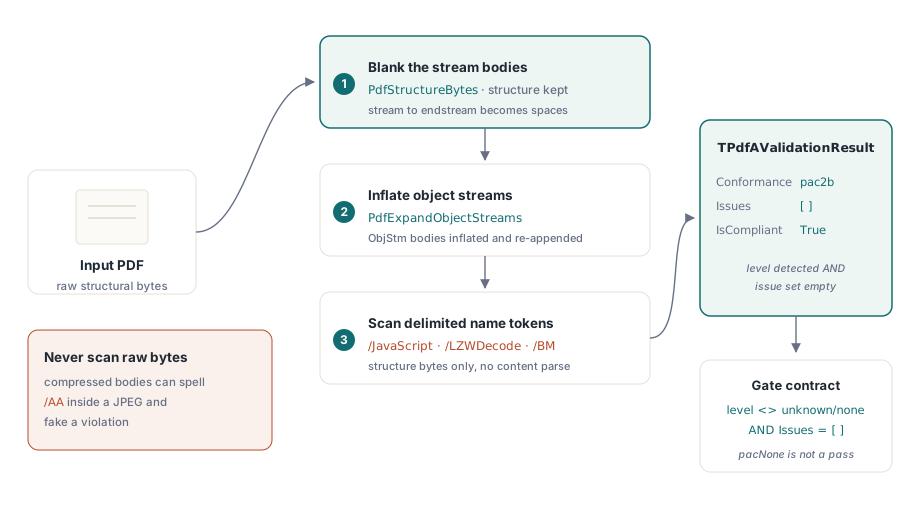
まず正直に言うと、バンドルされている pdfium.dll には PDF/A 機能がまったくありません。ConvertToPDFA も、OutputIntent ライターも、公開 API に XMP API もありません。このライブラリの PDF/A のあらゆる部分は、書き込み側も検査側も、純粋な Pascal の FPdfPdfa.pas にあり、バイトレベルのパースとインクリメンタル更新だけで動きます。だからバリデータを呼んでも、Chromium のレンダラに何かを尋ねているわけではありません。ファイルの構造バイトに対して Pascal のトークンスキャナを走らせているだけです
公開 API は意図的に小さい。1 つの関数が position 0 から stream を読み、record を返す:
function ValidatePdfACompliance(Source: TStream): TPdfAValidationResult;

type
  TPdfAValidationResult = record
    Conformance: TPdfAConformance;        // pacUnknown, pacNone, pac1b, pac2u, ...
    Issues: TPdfAValidationIssues;        // TPdfAValidationIssueのset
    function IsCompliant: Boolean;        // level <> unknown/noneのときだけTrue
  end;                                    // AND Issuesが空
IsCompliant は、ゲートで重要な規則を体現しています。実際の適合レベルが検出され、問題集合が空のときだけ、ファイルは合格になります。pdfaid マーカーが見つからないままパース自体は成功した場合は pacNone に解決され、これは明確に合格ではありません。これは、一括プリフライトレポート CLI が外側から示しているのと同じ点です。認識できないファイルの問題リストが空でも、健全の証明にはなりません
ストリーム本体を取り除いてから、どの token scan も始める
ここが最重要の実装詳細で、自前の scanner を書くと最も間違えやすい点でもある。検出器は、区切られた name token を探して違反を見つける。たとえば「/JavaScript、/LZWDecode、/BM。生の file bytes を scan すると、埋め込まれた binary stream body、compressed images、ICC profiles、font programs が、たまたまそれらの token に見える byte sequence を含んでしまう。あなたは /AA または /3D「found」と報告してしまうだろう。なぜなら JPEG の中の 3 バイトがたまたまそう綴っていたからだ。これは false positive factory だ
修正が PdfStructureBytes です。ファイルをたどり、すべての stream と endstream キーワードの間にあるバイトを空白で塗りつぶし、辞書構造はそのまま残します。その後で初めてスキャンを実行します。バリデータの各 name-token チェックは、この剥ぎ済みコピーを対象に動きます。この記事から 1 つだけ持ち帰るなら、これです。同じ規律は PDF/UA バリデータにもあります。そちらは独自のコピーを持っており、2 つの標準が独立に進化するため、ルーチンを別管理しています
29 個の issue と、それぞれの意味
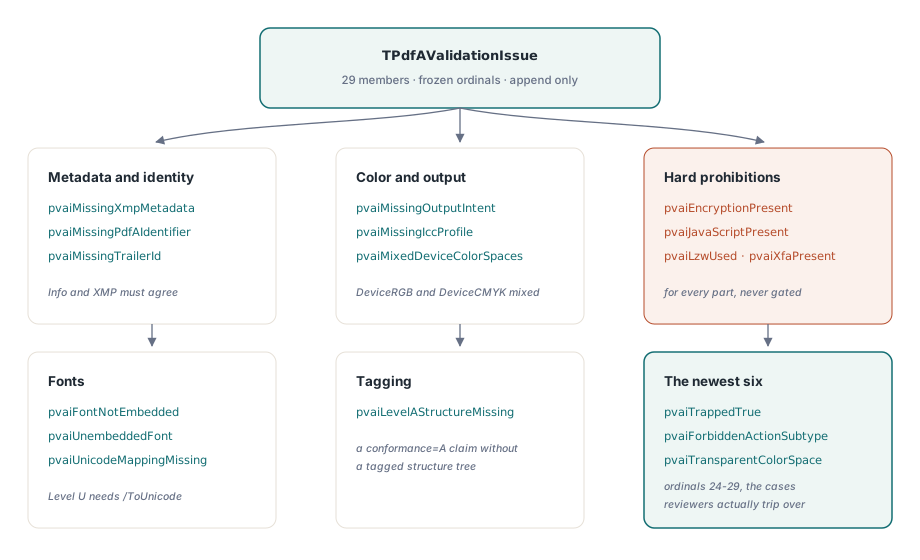
TPdfAValidationIssue は文書化された契約です。序数は固定されています。呼び出し側、デモ、レポート層のすべてがそれに依存しているため、新しい発見は常に末尾に追加されます。v1.63.0 時点でメンバーは 29 個あり、いくつかのファミリーに分かれます:
- メタデータと識別情報:
pvaiMissingXmpMetadata、pvaiMissingPdfAIdentifier、pvaiMissingTrailerId(ISO 19005-1 6.1.3)、pvaiMissingXmpDates - 色と出力:
pvaiMissingOutputIntent、pvaiMissingIccProfile、および DeviceRGB と DeviceCMYK が両方現れるときのpvaiMixedDeviceColorSpaces(6.2.3.3) - すべてのパートに対する厳格な禁止事項:
pvaiEncryptionPresent(/Encrypt辞書は完全に禁止)、pvaiJavaScriptPresent、pvaiForbiddenAction、pvaiAdditionalActions、pvaiLzwUsed、pvaiXfaPresent、pvaiNeedAppearancesTrue、pvaiForbiddenAnnotation - フォント:
pvaiFontNotEmbeddedと、より厳しいpvaiUnembeddedFont。さらに/ToUnicodeのない Level U の主張に対するpvaiUnicodeMappingMissing - タグ付け: conformance=A の主張にタグ付き構造がない場合の
pvaiLevelAStructureMissing
序数 24 から 29 に追加された最新の 6 つのメンバーは、レビュー担当者が実際につまずく微妙なケースをカバーします。pvaiTrappedTrue(Info 辞書の /Trapped /True。値は False か Unknown でなければならない「false friend」です)、pvaiForbiddenActionSubtype(注釈だけでなくアクションとして使われる Sound や Movie)、pvaiTransparentColorSpace(Normal 以外のブレンドモード、または 1.0 でない /CA//ca)、pvaiAnnotationDictViolation、pvaiUnembeddedFont、そして pvaiMixedDeviceColorSpaces です
part を意識した gate: A-1 は厳格、A-2 と A-3 は緩和
PDF/A は 1 冊の規則書ではありません。PDF/A-1 が禁止している 3 つのものは、PDF/A-2 以降では明示的に許可されています。transparency(/Transparency グループかアクティブな /SMask、6.4)、optional content(/OCProperties、6.1.13)、そして埋め込みファイル(/EmbeddedFiles か /EF、6.1.11)です。すべてのファイルにこの 3 つを旗上げする素朴なバリデータは、完全に妥当な PDF/A-2 文書を大量に拒否することになります
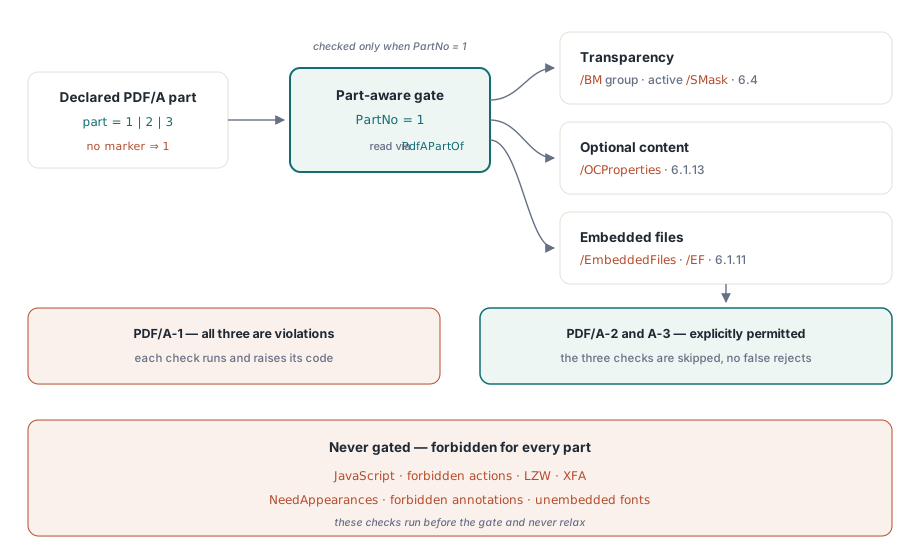
そこでバリデータは、pdfaid マーカーから PdfAPartOf でパート番号を読み取り、これらのチェックを PartNo = 1 の背後に置きます。新しい transparency 問題に対するブレンドモードと注釈アルファのチェックも、同様にパート 1 専用です:
if PartNo = 1 then
begin
  if PdfHasName(Struct, '/BM') then
    if not PdfHasBMNormal(Struct) then          // /Normal か /Compatible だけが許可される
      Include(Result.Issues, pvaiTransparentColorSpace);
  if PdfHasCaNotOne(Struct, '/CA') or PdfHasCaNotOne(Struct, '/ca') then
    Include(Result.Issues, pvaiTransparentColorSpace);
end;
1 つ保守的なデフォルトに触れておきます。pdfaid マーカーがまったくないとき、パートは最も厳格な 1 として扱われます。識別できないファイルを黙って通すのではなく、最も厳しい規則に従わせるべきだからです。JavaScript、禁止アクション、LZW、XFA、NeedAppearances、禁止注釈、埋め込みなしフォントはすべてのパートで禁止されたままなので、これらのチェックがゲートの背後に置かれることはありません
object stream を展開して、何も隠れないようにする
PDF 1.5 はクロスリファレンスストリームとオブジェクトストリーム(/Type /ObjStm)を導入し、素朴なバイトスキャナには盲点を作りました。catalog、OutputIntent、action 辞書など、それ自体はストリームでないものは、ObjStm の中で Flate 圧縮され得ます。生の構造をスキャンしてもそれらは見えず、その結果、まったくきれいではないファイルを「きれい」と報告することになります
PdfExpandObjectStreams がその盲点を塞ぎます。どのチェックを実行するより前に、バリデータは Data := PdfExpandObjectStreams(Data) を行います。このルーチンはすべての ObjStm を見つけ、/N と /First のヘッダを読んで格納オブジェクト番号とオフセットを取得し、本体を PdfInflate(RTL の zlib。Delphi では System.ZLib、FPC では zstream)で展開し、格納されていた各オブジェクトを通常の N 0 obj ... endobj としてバイト列のコピーの末尾へ追記します。既存のトークンチェックは、ロジックを変えずにそのままそれらのオブジェクトを見つけます
この設計がクリーンで脆弱でないのは、2 つの制約のおかげです。ストリームオブジェクト、すなわち Metadata、ICC プロファイル、フォントプログラムはオブジェクトストリームに入れられず、非ストリーム辞書だけが対象なので、展開が扱うのは辞書だけで、追記されるオブジェクトは本体剥ぎのパスを乱す stream キーワードを運びません。さらに追記される内容は %%EOF の後ろに着地するため、startxref からの逆方向検索は依然として元のトレーラーを見つけます。クロスリファレンスストリームのトレーラーは別扱いで、平文の xref ストリーム辞書から Root、Size、ID を直接読みます。この話題はオブジェクトストリームとクロスリファレンスストリームの検証の解説で掘り下げており、オブジェクトストリーム展開はその上に展開ステップを足すだけです
バイトレベルチェッカーの役割
これはプリフライトツールであって、認証済みバリデータではありません。フォント埋め込みはカウントのヒューリスティックであり、素朴な数え方は間違っています。PdfCountName('/FontDescriptor') はフォントごとに 2 つの /FontDescriptor トークンを見ます。フォント辞書からの参照 1 つと、descriptor オブジェクト自身の /Type 1 つです。つまり数は 2N に対して埋め込みプログラムは N 個で、テストは常に true になります。PdfCountDescriptorRefs は /FontDescriptor N G R の参照形式だけを数えます。フォントごとに 1 つで、埋め込みプログラムが本当に少ないときだけ pvaiUnembeddedFont を上げます:
K := PdfCountDescriptorRefs(Struct);                 // フォント辞書ごとに 1 つ
Emb := PdfCountName(Struct, '/FontFile')
     + PdfCountName(Struct, '/FontFile2')
     + PdfCountName(Struct, '/FontFile3');
if (K > 0) and (Emb < K) then
  Include(Result.Issues, pvaiUnembeddedFont);
これはフォントごとの監査ではなく、数に基づくシグナルです。したがってフォントの発見は、完全なバリデータで確認してください。展開された AcroForm /DR が公開し、veraPDF が(描画に使われないことで)受け入れる /Helv のような standard-14 デフォルトリソースも含めてです。コンテンツストリームのオペレータレベル検査(6.2.10)は完全なコンテンツパースを要し、バイトスキャンの外にあります。バリデータは、マーカー注入では直せない違反を捕える高速で依存のない最初のゲートと捉え、最終認証は完全なバリデータに任せてください
これは話の検査側です。対をなす書き込み側、つまり SaveAsPdfA が XMP、OutputIntent、sRGB ICC プロファイルを注入し、タグ付き構造のない Level A 要求を正直にダウングレードする側は、同じバイトレベルの機構の上に立っています。両方ともDelphi 向け PDFium Component に同梱されています。外部ランタイムをインストールする必要のない、純粋な Pascal の PDF/A 実装の上に立つ単一の VCL パッケージです