Word 出力の 3 ページにわたる表は、紙の下端に 72 ポイントより近づくことは決してありません。1 インチの余白は 72 ポイントであり、ワープロは余白のところで行の配置を止めます。断片を、ページ端の 36 ポイント以内に座っているときだけ結合するリンカーは、同一の列を持つ 3 つの無関係なテーブルを見ます。機能する問いは違うものです。実行ヘッダーやフッター以外の何かが、1 つの断片の終わりと次の断片の始まりの間に座っていないか
その問いは、自分自身の 2 つの罠を運んできます。フォームは、1 つのテーブルを 1 ページ目の下端で終え、同じ列幅の別のテーブルを 2 ページ目の上端で開けます。そして罫線グリッドは、1 つの行を改ページの向こうへ押し出せます。何かをテーブルと呼ぶ前に 2 行を求める検出器には短すぎる行です
ExtractDocumentTables の 2 つの端の検査
PDFium Component は TPdf.ExtractDocumentTables の中で継続を印付けます。表検出と抽出の記事で扱ったページごとの ExtractTables の文書レベル対応物です。TPdfTableExtractionOptions.Default ではそうなっている DetectContinuations が設定されると、メソッドはすべてのページを抽出し、テーブルをページ番号順に、さらに各ページの上から下へソートし、そのリストの中の隣接ペアをすべて検査します。比較されるのは隣接だけです。だから継続候補は常に、ページ N の最も低いテーブルとページ N+1 の最も高いテーブルのペアであり、ページ N で長いテーブルの下に置かれた小さなテーブルは、そのペアリングで長いテーブルの席を取ります。短いメモテーブルが長いテーブルの下に座るときは、ページ番号と ColumnCount から、それらの断片を自分のコードで連結してください
最初の検査は純粋に幾何的です。早い方の断片の下端がページ下端の ContinuationMargin ポイント以内にあり、遅い方の断片の上端が次ページの上端の同じ距離以内になければなりません。既定は 36 ポイント、半インチです。固定のコンテンツボックスを満たすレイアウトエンジンのレポートはこれを簡単に通ります。1 インチ余白の Word 出力は両側で最低 36 ポイント外れ、通るまで余白を広げるのは間違いです。同じ数字が 2 つ目の検査のヘッダーバンドとフッターバンドを設定するからです
2 つ目の検査、コンテンツ対応のものが、ワープロ出力を処理するものです。2 つは OR で組み合わさります。どちらかが門を開けます
2 つの断片の間の何がテキストと数えられるのか
ページ上のすべての単語は、実行ヘッダーバンドかフッターバンドの完全な内側に横たわっていない限り、本文テキストとして数えられます。そして両バンドは ContinuationMargin ポイントの深さです。ページごとに、ExtractDocumentTables は、上端がフッターバンドより上にある単語の中で最も低い下端と、下端がヘッダーバンドより下にある単語の中で最も高い上端を記録します。テーブル自身のセルテキストを含めてです。テーブルがページ N の最後の本文コンテンツであるとき、その下端は最も低い単語の位置以下に座り、検査は AlignmentTolerance(既定 3 ポイント)以内で通ります。遅い方の断片は、ページ N+1 の上端で鏡像の条件を満たさなければなりません
バンドの無視には、仕様での根拠があります。ISO 32000-1 §14.8.2.2 は、実行ヘッダー、フッター、ページ番号をページネーションの作為、つまり文書がページに切られたことだけのために存在するコンテンツとして扱います。タグ付きファイルは marked-content の記事が説明するとおり /Artifact でそれらを宣言できますが、テーブルの継ぎ合わせを最も必要とするエクスポートはめったにタグを運ばないので、位置がタグの代役を務めます。既定のバンドでは、グリフの上端が下端の 30 ポイント上で止まるページ番号は無視されます。40 ポイントに達する免責事項の行は本文テキストであり、リンクを塞ぎます
テキストレイヤーのないページでは、格納された極端値はページ境界へフォールバックし、コンテンツ対応の検査は自明に通り、残りの門が決めます。画像やベクターアウトラインとして描かれたフッターは同じ理由で見えず、決してリンクを塞ぎません
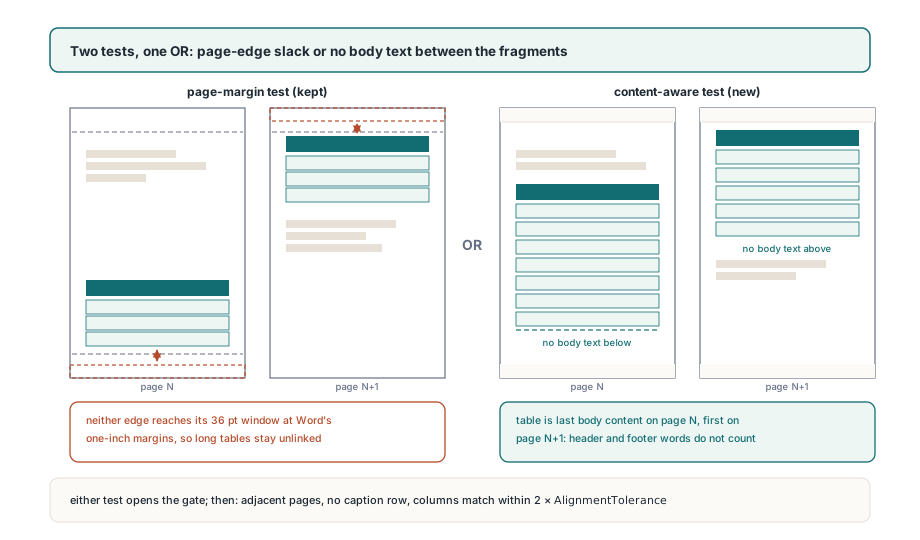
端の検査を通ることは、門を開けるだけです。ページは連続していなければならず、遅い断片はキャプション行で開いていてはならず、列境界は AlignmentTolerance の 2 倍、既定では 6 ポイント以内で揃っていなければなりません。すべてが成立するとき、早い方の断片は新しいグループ番号付きの ptcStart になるか、すでにチェーンを閉じていれば ptcEnd から ptcMiddle へ移り、遅い方の断片は同じグループの ptcEnd になります。3 ページに広がるテーブルは start、middle、end と読めます。グループ番号は 1 から始まり、ptcNone 付きのグループ 0 はテーブルが単独であることを意味します。ToJson は同じデータを "continuationGroup" と "continuation"(none、start、middle、end)として書くので、JSON を受け取るサービスは自分で継ぎ合わせられます
下の一覧は、約 50 ポイントの深さの 2 行フッターを持つ Word 出力を想定しています。だから余白は、両方の行をバンドの中に保つために 54 に上げられます
uses
  System.SysUtils, PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;  // DetectContinuations = True
    Options.ContinuationMargin := 54;               // フッターは約 50 pt の深さと想定

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d, %d rows',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d, %d x %d',
          [Tables[I].PageNumber, Tables[I].RowCount,
           Tables[I].ColumnCount]));
      end;
  finally
    Pdf.Free;
  end;
end.
全幅の最初の行が 2 つのテーブルを引き離す仕組み
最初の行がすべての列にまたがる 1 つのセルである遅い断片は、端の検査が通り、列が一致していても、新しいテーブルとして報告されます。フォームこそ、コンテンツ対応の検査が行き過ぎる場所です。1 つのテーブルが 1 ページ目の下端近くで終わり、次の節が 2 ページ目で同一の列幅で開き、すべての幾何検査が通ります。違いは 2 つ目のテーブルの開き行、全幅にわたって 1 つの結合セルとして敷かれた RECIPIENT INFORMATION のような節キャプションです。本物の継続はそのようには開きません。テーブルのキャプションは、テーブルが始まるページにとどまるからです
規則が読むのは遅い断片のセルだけです。その断片は最低 2 列と、RowIndex = 0、ColumnIndex = 0、ColumnSpan = ColumnCount のセルが要ります。早い方の断片は決して検査されないので、自分のキャプションがページ N の上端に座るテーブルは、ページ N+1 の継続へ普通にリンクします
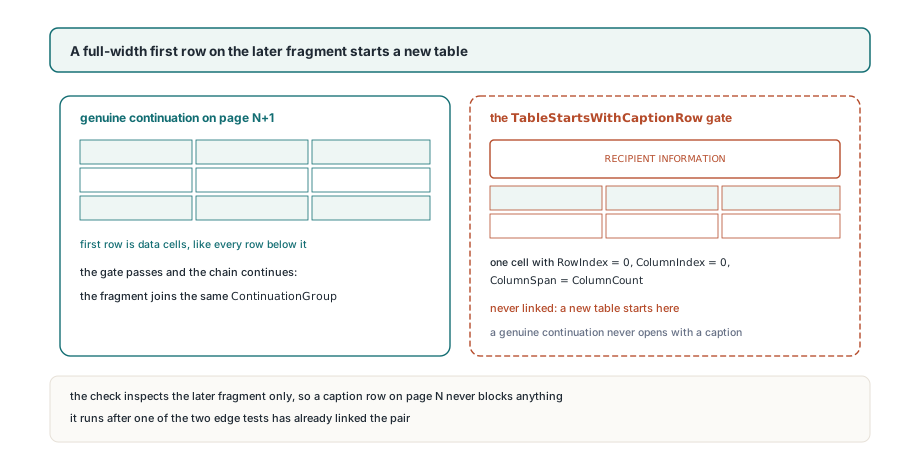
その後に続く列の比較は、等しい列数より厳格です。各断片の境界位置はセル矩形から再構築されます。結合セルの下に隠れた境界は、両側の最も近い既知の境界の間を等間隔に空けて埋められます。それからすべての境界ペアが比較され、6 ポイントを超える差がリンクを拒みます。違う比率の 2 つの 4 列テーブルは離れたままです。ジェネレーターがページ間で列を 8 ポイントずらした本物の継続もそうです。それを受け入れるために AlignmentTolerance を上げると、検出の間に使われるクラスタリングも緩みます
改ページの上の 1 つの罫線行
1 つの行を次のページへ押し出す罫線グリッドは、チェーンへリンクするときその行を保ち、しないとき失います。既定の MinRows である 2 は、迷い込んだ 2 本の罫線のペアがテーブルとして報告されるのを止めます。改ページの向こうへ押し出された行は違います。それは本物のデータであり、落とすと、継ぎ合わされたテーブルは 1 行足りず、隙間を説明する断片はもう残りません
文書走査はこれを 3 工程で処理します。DetectContinuations と DetectRuledTables が両方ともオンのとき、罫線検出器はすべてのページの上で、行の下限を 1 に下げて走ります。継続はその後、結果全体の上で印付けされます。最後に、呼び出し側の MinRows より少ない行数で、チェーンに入らなかったテーブルが削除されます。普通のページの真ん中の 1 行グリッドはそのフィルタを通り、消えます。それこそ MinRows の役目です
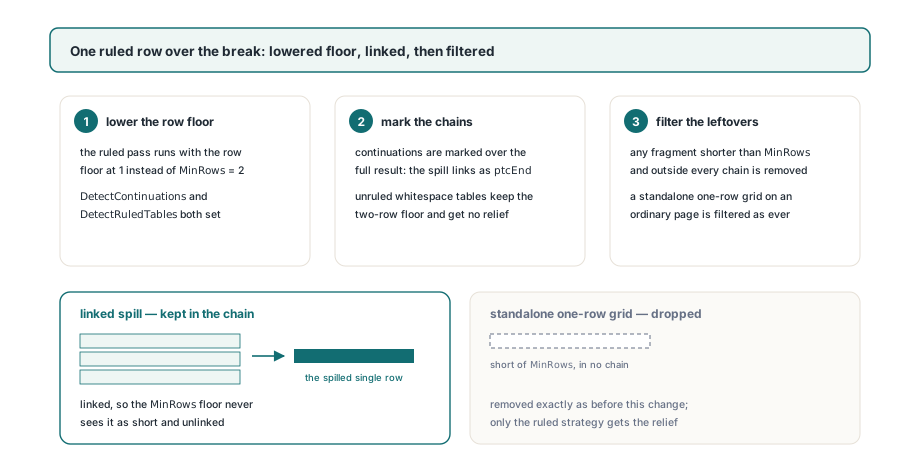
MinRows は 2 のままにしてください。自分で 1 に設定すると最終フィルタが切れ、すべてのページのすべての 1 行罫線グリッドが戻ってきます
例外が当てはまるのは罫線グリッドだけです。空白の戦略は、テーブルを認識するのに最低 2 つの揃った行が要るので、MinRows が何と言おうと内部の下限 2 を保ちます。ExtractTables は MinRows = 1 を受け入れますが、それを尊重するのは罫線検出だけです。1 行こぼれる罫線のないテーブルには、ページの単語ボックスか、構造化テキストブロックと読み順で記述されるブロックが、その行を自分で復元するための位置を与えます
チェーンを 1 つのテーブルへ縫い戻す
チェーンは連続した状態で戻ってきます。リンクが結ばれるのは、ソートされた配列の中の隣接の間だけなので、ptcStart 断片の直後には ptcMiddle と ptcEnd 断片が続き、ptcNone か ptcStart でリセットし、ptcNone か ptcEnd で書き出すループは、グループ番号で何かを引く必要がまったくありません
繰り返されるヘッダー行が厄介な部分です。Word はそれを毎ページ繰り返せますが、他のジェネレーターはしません。TPdfTableCell の IsHeader フラグはそれを決着できません。それは位置、つまり RowIndex < HeaderRowCount によって、断片ごとに別々に割り当てられるからです。継続の行 0 は、ヘッダーを繰り返していようがデータを運んでいようが、ヘッダーとして旗が立ち、前節の 1 行のこぼれも旗が立ちます。下のルーチンは、各継続の最初の行のテキストをチェーンの最初の行と比較し、完全一致のときだけ落とします
それはまた、ToCsv の出力を行に分割する代わりに、Cells から行を組み立てます。セルの中でテキストが折り返すセルは、視覚的な行の間に CR LF 付きで返り、ToCsv はその改行を引用符付きフィールドの中に保つので、CSV テキストの最初の行を削ると、2 行のヘッダーセルが半分に切られます
// リーダー側のヘルパー(ライブラリの一部ではない): 各チェーンを
// 1 つのタブ区切りファイルとして再構築し、後のページで繰り返されたヘッダーを落とす
function RowText(const T: TPdfTable; Row: Integer): string;
var
  Parts: array of string;
  I: Integer;
begin
  SetLength(Parts, T.ColumnCount);
  for I := 0 to High(T.Cells) do
    if (T.Cells[I].RowIndex = Row) and (T.Cells[I].ColumnIndex >= 0) and
       (T.Cells[I].ColumnIndex < T.ColumnCount) then
      Parts[T.Cells[I].ColumnIndex] :=
        StringReplace(string(T.Cells[I].Text), #13#10, ' ', [rfReplaceAll]);
  Result := '';
  for I := 0 to High(Parts) do
  begin
    if I > 0 then
      Result := Result + #9;
    Result := Result + Parts[I];
  end;
end;

procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R, FirstRow: Integer;
  Header: string;
  Lines: TStringList;
begin
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      FirstRow := 0;
      if Tables[I].Continuation in [ptcNone, ptcStart] then
      begin
        Lines.Clear;
        Header := RowText(Tables[I], 0);
      end
      else if (Trim(Header) <> '') and (RowText(Tables[I], 0) = Header) then
        FirstRow := 1;                     // このページでヘッダーが繰り返された
      for R := FirstRow to Tables[I].RowCount - 1 do
        Lines.Add(RowText(Tables[I], R));
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Lines.SaveToFile(Format('%s\table%d-page%d.tsv',
          [Folder, I, Tables[I].PageNumber]));
    end;
  finally
    Lines.Free;
  end;
end;
正確な比較が正しい選択です。ワープロが繰り返したヘッダーは文字単位で一致する一方、ファジーな一致はいずれ、ヘッダーに似たデータ行を呑み込みます。迷い込んだ余分なヘッダーは出力の中で見つけやすいのですが、欠けたデータ行はそうではありません
推測の代わりにフッターバンドを測る
ContinuationMargin は 1 つの数字で 3 つの仕事をします。最初の検査のためのページ端の遊び、2 つ目のためのフッターバンドの深さとヘッダーバンドの深さです。バンドより深いフッターはその上の行を本文ゾーンに残し、早い断片はテキストが自分の後ろに続いているかのように見え、チェーンはそのページで切れます。深すぎるバンドは本物のコンテンツを呑み込み始めます。下余白のすぐ上の短い結びの行がその内側に落ち、その行の上のテーブルは、次のページを開く何にでもリンクできてしまいます
数字は文書自身が供給できます。TPdf.PageWordBoxes は現在のページのすべての単語を、Top が Bottom より大きいページ空間の Rect 付きで返すので、本文余白より下に横たわる単語の中の最も高い Top がフッターの深さです。下のプローブは、レイアウトの下余白のすぐ下の値、1 インチページなら 70 を受け取り、フッターのない文書のために 36 ポイントを床として保ちます
// リーダー側のヘルパー(ライブラリの一部ではない): どのページでも
// BodyMargin の下で見つかった最も高い単語の上端、つまりフッターゾーンの深さ
function MeasureFooterDepth(Pdf: TPdf; BodyMargin: Double): Double;
var
  P, I: Integer;
  Words: TPdfWordBoxes;
begin
  Result := 0;
  for P := 1 to Pdf.PageCount do
  begin
    Pdf.PageNumber := P;
    Words := Pdf.PageWordBoxes;
    for I := 0 to High(Words) do
      if (Words[I].Rect.Bottom < BodyMargin) and
         (Words[I].Rect.Top > Result) then
        Result := Words[I].Rect.Top;
  end;
end;

// uses System.Math for Max
Options := TPdfTableExtractionOptions.Default;
Options.ContinuationMargin := Max(36.0, MeasureFooterDepth(Pdf, 70) + 2);
Tables := Pdf.ExtractDocumentTables(Options);
バンドは両端で同じ深さなので、深い実行ヘッダーもページ上端に対して測り、大きいほうの値を使ってください。遊びは 2、3 ポイントに抑えてください。余分な 1 ポイントごとに、コンテンツ対応の検査が見えなくなる本文テキストが 1 ポイント増えます
1 つのレイアウトが、構造上の理由でキャプション規則を裏切ります。すべての継続断片の最初の行として結合された「continued」バナーを書くジェネレーターです。そのような断片はそれぞれ新しいテーブルとして報告されるので、連続するページ番号、等しい ColumnCount、行 0 のバナーテキストから、自分のコードで連結してください
継続の印付け、キャプション規則、1 行の例外は、すべて ExtractDocumentTables の中で走ります。Delphi、C++Builder、Lazarus の各ビルドで同じように振る舞います。表抽出オプションの完全なセットは、PDFium Component for Delphi のページに列挙されています