オブジェクト番号1はページ1ではありません。この一事実は、フォーマットの他のどの部分よりも多くのPDF処理コードを引っかけます。その理由が見えてくるのは、ビューアーが描画するものを見るのをやめ、ビューアーが実際に読んでいるオブジェクトグラフを見始めたときです
PDFファイルは番号付きの間接オブジェクトの集合です。各オブジェクトはオブジェクト番号と世代番号を運び、他のオブジェクトはN G Rと書かれる参照で指します。3 0 Rはオブジェクト3の現行バージョンの意味です。ページも他と同じオブジェクトですが、ファイルのどこに置かれ、どの番号を持つかは、表示順序について何も語りません。順序は/Pagesツリーから来ます。オブジェクトを番号順に走査すると、実世界のファイルのかなりの割合で、ページを誤った順序で組み立てることになります
このツリーは、見えにくい動作の住みかでもあります。形状はビューアーが8,214ページへどれだけ速くジャンプできるかを決め、内部ノードはページサイズとフォントを下のリーフへ黙って渡し、構造全体を高速にする/Countの合計は、何ひとつ強制されていません。順序そのものから始めて、この3つを順に見ていきます
ページツリーが順序を決める
すべてのPDFにはドキュメントカタログ(ISO 32000-2 §7.7.2)があり、カタログの/Pagesエントリはページツリーのルートノードを指します。そのルートは/Type /Pages、間接参照の/Kids配列、そして配下のリーフページ数を与える/Countを持つ辞書です。表示順序はこのツリーの深さ優先・左から右へのウォークです。規則はそれだけで終わりです
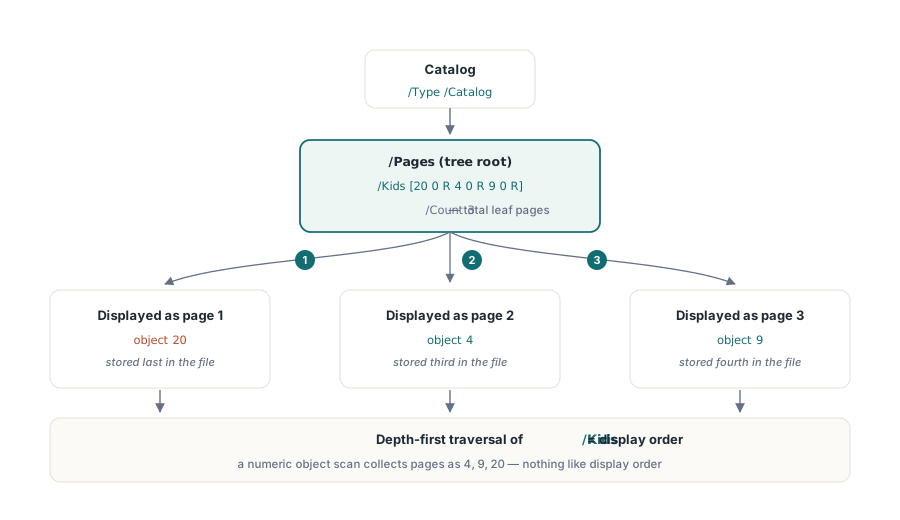
最小の3ページ構成のファイルで具体化します:
%PDF-1.7

1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [20 0 R  4 0 R  9 0 R] /Count 3 >>
endobj

% オブジェクト4はファイルでは3番目に格納されるが、表示順序はページ2
4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 5 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% オブジェクト9は4番目に格納されるが、ページ3
9 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 10 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj

% オブジェクト20は最後に格納されるがページ1。決めるのはKids[0]でありオブジェクト番号ではない
20 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792]
   /Contents 21 0 R /Resources << /Font << /F1 6 0 R >> >> >>
endobj/Kids配列は[20 0 R 4 0 R 9 0 R]と読め、オブジェクト20がページ1、オブジェクト4がページ2、オブジェクト9がページ3です。オブジェクトを番号順に反復して/Type /Pageを集めるコードは、このファイルを誤ります。さらに悪いことに、出力はそれらしく見えます。ページ数は正しく、各ページの内容も判読でき、順序だけが違うのです
ジェネレーターがこのような配置を作るのは、ごく普通の理由からです。全ページのオブジェクト番号を前もって予約するライブラリは、作成順に番号を付け、その後シリアライザに都合のよい順でバイトを書きます。マージツールは衝突を避けるため各ソース文書のオブジェクトを番号付け直すので、ページオブジェクトは統合後のオブジェクトテーブルに散らばり、新しいルートの/Kids配列が正しい順序を保持します。そしてインクリメンタル更新は新しいオブジェクトを新しい番号でファイル末尾に追記するため、リビジョンで追加されたページは、位置1にあるべきでもバイトストリームの終端近くに住みます
食ってくるのは最後のケースです。単一ツールが生成したテストコーパスは完全に通るのに、マージワークフローのファイルや、いくつかのリビジョンを経た文書は、シャッフルされた状態で出てきます。ヒューリスティックな対処は持ちこたえません。失敗の有無がジェネレーターとファイルの編集履歴に依存するからです。本当の修正は短いものです。カタログから出発し、/Pagesを解決し、/Kidsを再帰的に歩いて、出会った順にリーフを出力する。ページ順序のデバッグのケーススタディは、まさにこの症状を誤診から根本原因まで追跡し、再帰走査のコードと結果確認のqpdf手順を示しています
ファンアウトはパフォーマンス上の決定事項です
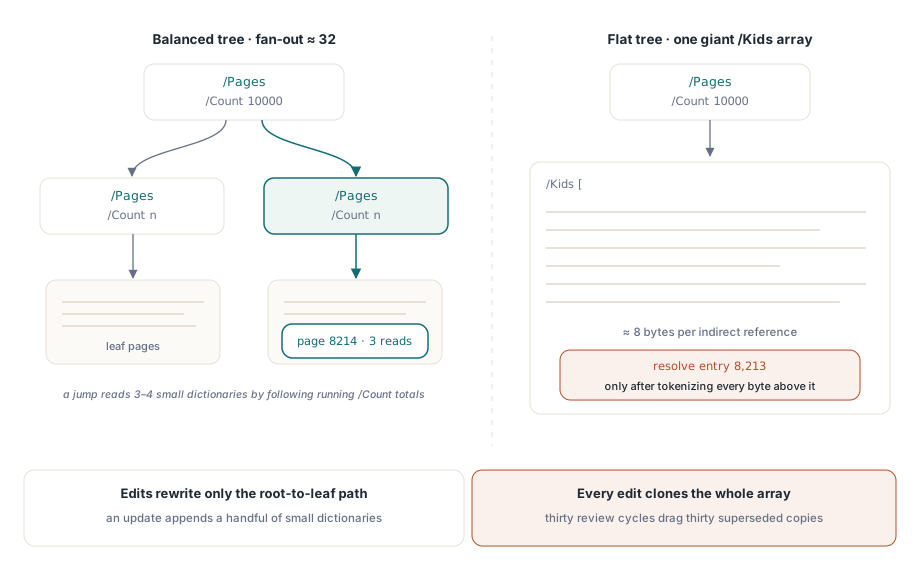
仕様は2つの形状を許します。単純なジェネレーターはフラットなツリー、つまり/Kidsが/Pageリーフしか持たない1つのルート/Pagesノードを出します。ネストを強制するものは何もなく、1つの配列に10,000個のリーフ参照を持つ10,000ページの文書でも準拠しています。それでもPDF Referenceは大規模文書にバランスの取れたツリーを推奨しており、主流のジェネレーターはその助言に従い、中間ノードごとに数個から数十個の子供という穏当なファンアウトで出力します。各中間ノードは独自の/Kidsと独自の/Countを持ちます
理由は、ビューアーが何かを表示する前に読まなければならない量です。10,000ページファイルの8,214ページへの直接ジャンプを考えます。フラットツリーでは、ビューアーはまずルートをパースしなければなりません。ルートは1つの巨大配列です。間接参照あたり約8バイトとして、エントリ8,213が解決される前に端から端までトークン化すべき80 KBのオブジェクトです。ファンアウト32のバランスツリーでは、同じジャンプはルートを読み、累積/Countの合計を比較して正しい子を選び、降りていくだけです。3、4個の小さな辞書で、1個あたり数百バイト。このO(log n)のランダムアクセスこそツリーが提供するよう設計されたものであり、中間ノードに/Countが存在する理由のすべてです。リーダーは内部のオブジェクトを1つも開かずにサブツリー全体をスキップできます
ツリーの形状は編集のコストも決めます。1ページを挿入するインクリメンタル更新は、/Kidsか/Countが変わったすべてのノード、つまり新しいリーフの親からルートまでの経路を書き換えなければなりません。バランスツリーではこの経路は、ファイルに追記される数個の小さな辞書にすぎません。フラットツリーではその「経路」とは巨大なルート配列であり、リビジョンごとに丸ごと複製されます。30回のレビューと注釈のサイクルを経る契約書は、同じ80 KB配列の置き換え済みコピー30個をバイトストリームに引きずることになりかねません
処理コードにとって、ネストの帰結はもっと直接的です。/Kidsの第1レベルにページが入っていると仮定してはならず、すべての子を確認する必要があります。/Type /Pagesなら再帰、/Type /Pageならリーフです。第1レベルで止まるコードは、出会うフラットなファイルすべてで正しく動き、ジェネレーターが最初にネストした瞬間に、サブツリーごと黙って落とします
内部ノードは継承された属性を持ちます
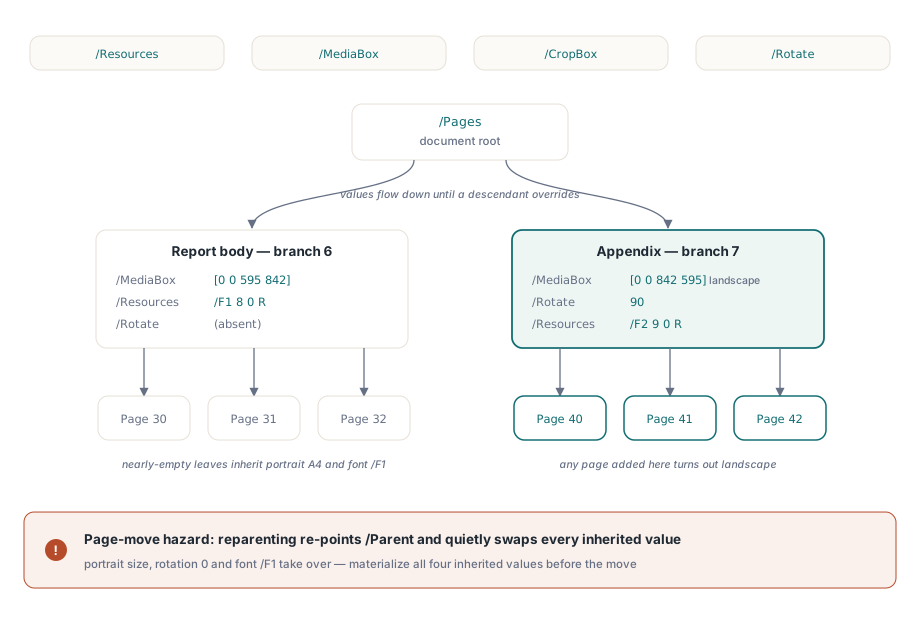
中間ノードは検索の経由地以上の仕事をします。4つのページ属性は継承可能です(ISO 32000-2 §7.7.3.4):/Resources、/MediaBox、/CropBox、/Rotate。どれも/Pagesノードに置けて、子孫が上書きしない限り配下のすべてのリーフに適用されます。横向きの付録を含むレポートを生成するライターは、そのレイアウトをツリー自体で表現できます:
5 0 obj   % ドキュメントルート
<< /Type /Pages /Count 6 /Kids [6 0 R  7 0 R] >>
endobj

6 0 obj   % レポート本文:縦向きA4、本文フォント
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [30 0 R  31 0 R  32 0 R]
   /MediaBox [0 0 595 842]
   /Resources << /Font << /F1 8 0 R >> >> >>
endobj

7 0 obj   % 付録:横向きA4、回転あり、専用フォント
<< /Type /Pages /Parent 5 0 R /Count 3
   /Kids [40 0 R  41 0 R  42 0 R]
   /MediaBox [0 0 842 595] /Rotate 90
   /Resources << /Font << /F2 9 0 R >> >> >>
endobj

40 0 obj  % 付録ページ:サイズ、回転、フォントを継承
<< /Type /Page /Parent 7 0 R /Contents 43 0 R >>
endobj
オブジェクト40〜42はほとんど空です。ページサイズ、回転、フォントリソースはすべてノード7から届くため、ファイルはコンパクトで自己保守的です。付録ノードの下に4ページ目を追加しても、誰も触れなくても横向きで出てきます
これは、ページのプロパティがすべてページの上にあるとは限らないことも意味します。オブジェクト40には/MediaBoxキーがありませんが、それは完全に合法です。欠けたキーを不正な入力として扱うリーダーは、有効なファイルを拒否してしまいます。検索はエントリが見つかるかルートに達するまで、/Parent連鎖を上へ歩かなければなりません。この歩行にはサイクルガードが必要です。破損したファイルは、すでに訪れたノードへ逆指しする/Parent参照を運べます。訪問済み集合がなければ、検索は永久に回り続けます
同じメカニズムが、古典的なページ移動の危険を生みます。ツールが2つの/Kids配列を編集し、/Parentをノード6へ付け替えることでオブジェクト40をレポート本文へ移すとします。移動は構造的に有効ですが、オブジェクト40は縦向きの/MediaBox、回転なし、フォント/F1を継承するようになります。ところがそのコンテンツストリームは依然として/F2を選択しており、これはもはや解決されません。1回の編集でページは縮み、回転が解け、テキストを失います。堅牢な並べ替えコードは、親を付け替える前に、継承可能な4属性すべての解決済み値をページ辞書に書き込みます。エディタでページをドラッグしたらサイズや向きが変わった、という経験があれば、それがあなたの見たメカニズムです
フラット化:合法、一般的、場合によっては高コスト
逆の方向へ進むツールも多いです。最小限のライターは単純さゆえに単一レベルのツリーを出し、多くのマージ・分割ユーティリティは、バランス出力が余分な作業でありフラット出力は常に準拠しているため、読んだツリーを1つのフラットな/Kids配列へ組み立て直します。正しい組み立て直しは、継承の解決を同時に行わなければなりません。リーフが継承していた属性はすべてリーフへコピーするか、文書全体で均一なら新しいルートへ引き上げる必要があります。この工程を飛ばすと、出力のジオメトリはページ移動のケースとまったく同じように変わります
典型的な文書では、フラット化は無害です。規模が大きくなると効いてきます。すでに述べた2つの形です。ルート配列が1つの大きなオブジェクトになり、すべてのオープンとすべてのページジャンプが丸ごとパースし、すべての構造編集が丸ごと書き直します。フラット化が破壊しないのは、間接参照による共有です。10,000ページすべてが同じ/Resources辞書オブジェクトを指すフラットツリーは、依然として重複排除されています。失われるのは、エントリをページに書かず先祖に供給させるという選択肢だけです
/Countが嘘をつくとき
/Countは純粋な簿記です。ノードのサブツリー内のリーフページ数と等しくなければならず、ファイル形式にはそれを強制するものがありません。実世界で見かける嘘のカウントの大部分は、2つの破損パターンで説明がつきます
1つ目は、増分更新によって残された古いカウントです。エディタはページを挿入し、新しい/Kidsと更新された/Countで直近の親を書き換え、両方をファイルに追加しますが、先祖にはまったく触れません:
% Original revision
12 0 obj
<< /Type /Pages /Count 9 /Kids [13 0 R  14 0 R  15 0 R] >>
endobj

14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 3
   /Kids [50 0 R  51 0 R  52 0 R] >>
endobj

% Appended revision:middle branchにpageを1枚挿入
% Object 14 is superseded; object 12 is never rewritten
14 0 obj
<< /Type /Pages /Parent 12 0 R /Count 4
   /Kids [50 0 R  51 0 R  90 0 R  52 0 R] >>
endobj
ツリーには現在10個のリーフがありますが、ルートは依然として9と言っています。ルートを信頼するビューアーはページカウンターに9を表示します。内部カウントでページジャンプを二分探索するビューアーは、挿入位置より後のすべてのページで誤ったインデックスを計算します。完全な走査は10を見つけます。1つのファイルに、3つの異なる答えです
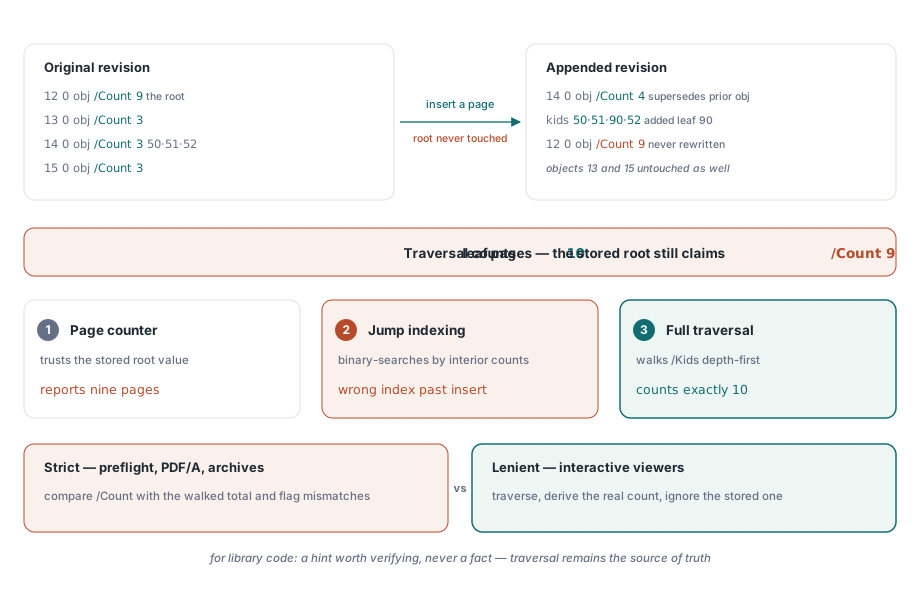
同じファイルに静かに噛まれる道もあります。ルートのカウントを読み、ツリーを歩き始め、その数だけページを集めた時点で止まるコードは、ページ10を永遠に見ません。例外も警告もなく、ただ1ページ足りない文書が残るだけです。/Countをループ境界や範囲チェックに使うことこそが間違いであり、歩行は保存された数値が何と言おうと、ツリーが尽きるまで走らねばなりません
2つ目のパターンは、最初から正しくあり得ないカウントです。負数、ページを持つノードでのゼロ、ありえないほどの巨大数。これらはファジング、伝送時の破損、そしてときにはエディタの算術バグから来ます。危険なのは、割り当てのために/Countを信頼するコードです。-3の/Countから配列サイズを決めれば、せいぜい範囲エラーで済みますが、20億の/Countから決めるのはサービス拒否(DoS)級の割り当てです。この値は、ファイル内の他の数値と同様、信頼できない入力として扱ってください
この点でパーサーは2つの陣営に分かれます。プリフライトツール、PDF/A検証ツール、アーカイブパイプラインといった厳密な消費者は、/Countを走査結果と比較し、ファイルを拒否するか印を付けます。インタラクティブなビューアーはほぼ例外なく寛容です。走査して実際のカウントを導き、保存された値を黙って無視します。古いカウントのファイルが、自動化ワークフローの中でより厳密なパーサーに出会うまで、何年も文句を言われずに流通できるのはまさにこのためです。ライブラリコードの既定としては、中間の立ち位置が正しいと私たちは考えます。/Countは事前割り当てのヒントとして、そして検証が済んだ後のサブツリースキップに使い、真実の源は走査に保つのです
本番環境では、これらの失敗はツリーの問題として名乗り出ることはまれです。シャッフルされたページ、マージ末尾で消えた1ページ、並べ替え後にサイズや向きが変わったページとして現れます。デバッグのケーススタディは、そのような報告を1件、ツリーまで遡って追跡しています。周囲のファイル構造(オブジェクト、クロスリファレンスデータ、トレーラー)については、PDFファイル構造の概観から始めるのがよいでしょう
HotPDF Delphi Componentは、これらすべてを内部で処理します。任意の深さのネストしたツリーを走査し、ページのコピー・移動時に継承属性を解決し、/Countを信頼する代わりに実際のリーフ数と照合して検証します。そのためAPIのページインデックスは常に論理ページを意味します