典型的な症状はオフバイワン(off-by-one)エラーに見えます。ページをコピーするルーチンが3ページのドキュメントの1ページ目を要求すると、常に2ページ目が返ってきます。インデックスのロジックを調べても問題ありません。呼び出しは0ベースの論理インデックスを使い、計算は正しく、境界条件も問題ありません。それでも、毎回間違ったページが出てきます
原因はコピーのコードには全くありません。ローダーがページ配列をどのように組み立てているかにあります。そしてこれは、PDFパースで最も陥りやすい罠の1つです
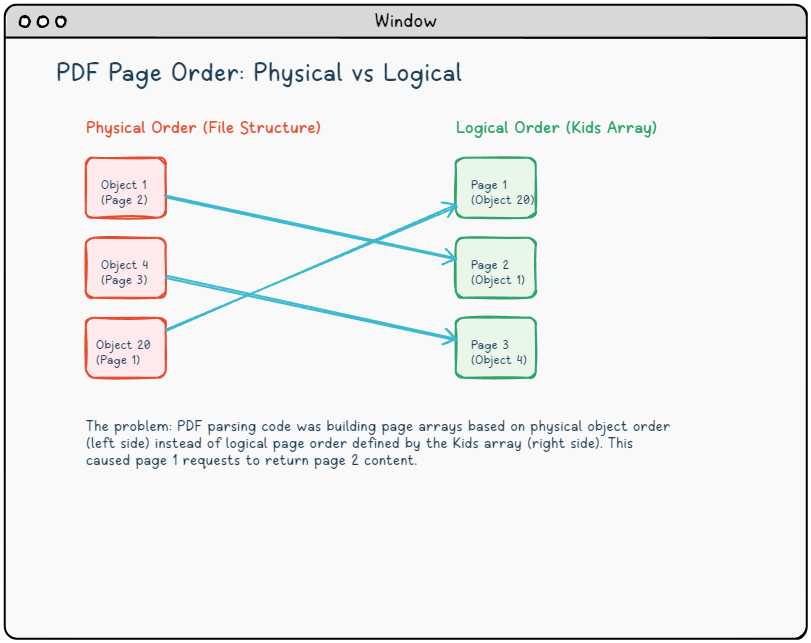
2つの順序、混乱の1つの原因
PDFファイルはインダイレクトオブジェクトの集合体であり、それぞれがオブジェクト番号で識別されます。ファイル構造において、これらの番号が読み取り順序を反映する義務はありません。オブジェクト1がページ2を保持し、オブジェクト20がページ1を保持することもあります。実際に読み取り順序を定義するのはページツリーです。これは、ビューアがページを表示すべき順序でページ参照をリストした /Kids 配列を持つ /Pages 辞書の階層です(ISO 32000-1 §7.7.3)
この罠をさらけ出してくれるページツリーがこちらです:
{ Pages tree root、object 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { logical page 1 }
         1 0 R    { logical page 2 }
         4 0 R]   { logical page 3 }
>>
endobj
そのファイルは偶然、バイトストリーム内でオブジェクト20の前にオブジェクト1とオブジェクト4をリストしていました。ファイル順にインダイレクトオブジェクトを反復処理し、ページタイプの辞書を見つけるたびにそれらを PageArr に記録するパーサーは、インデックス0にオブジェクト1、インデックス1にオブジェクト4、インデックス2にオブジェクト20を配置することになります。論理ページ1は PageArr[2] に配置されます。ページインデックス0を要求すると、代わりに論理ページ2が取得されます
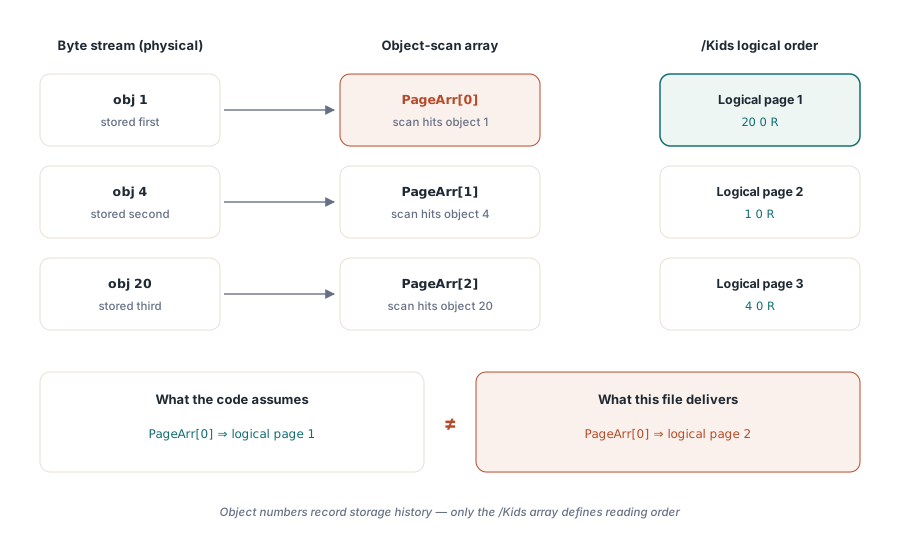
仮説の確認
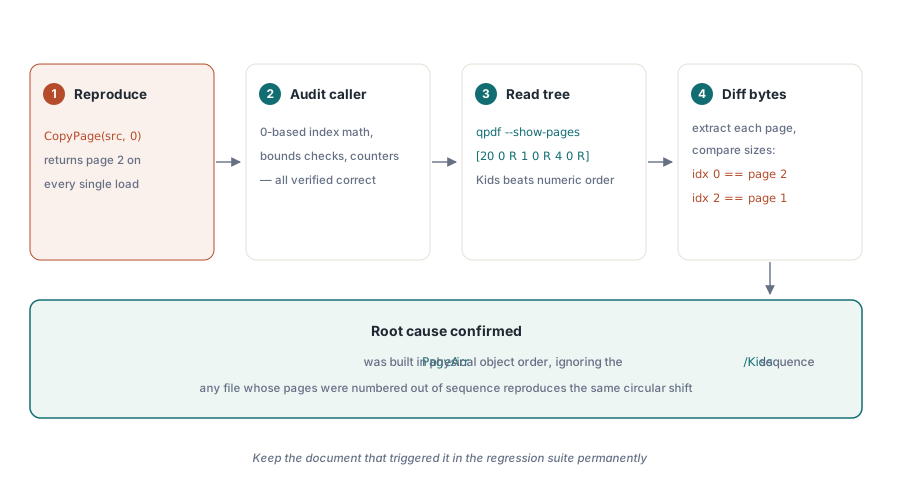
コードを変更する前に、不一致を推測するのではなく証明しましょう。qpdfコマンドラインツールを使えば簡単にできます:
{ shell }
qpdf --show-pages input.pdf
{ OutputがKids orderを示す:20 0 R、続いて1 0 R、続いて4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ reading orderでの/Pages dictionaryと/Kidsを表示 }
各ページを個別に抽出してファイルサイズを比べれば、マッピングが確認できます。オブジェクト走査で組み立てた PageArr[0] が生成するのは論理ページ2に属するコンテンツであり、PageArr[2] は論理ページ1を保持しています。この循環的なずれが決定的な証拠です。症状が多くの異なるソースドキュメントで現れる理由もこれで説明がつきます。ページオブジェクトが偶然、前の論理ページより小さなオブジェクト番号を持っているPDFなら、この問題が起こります
PDFがこの状態になるのには単純な理由があります。増分更新は変更したオブジェクトのオブジェクト番号を保持しますが、新たに追加したもの、たとえば先頭に挿入された表紙ページには、ファイルにすでにあるすべてより大きな新しい番号が与えられ、その参照は Kids 配列の先頭へ入ります。ドキュメントをマージや再編成するツールは、都合のよい順序でオブジェクトに番号を振り直します。一部のジェネレータは、論理的なページ順ではなく、コンテンツのストリーミングに便利な順序でページを書き込むだけです。PDFフォーマットは、それ以外の方法を誰にも要求していません
正しいアプローチ:Kids配列をたどる
ページリストは、インダイレクトオブジェクトをスキャンするのではなく、カタログのルートから /Kids チェーンをたどって組み立てます。この走査は再帰しなければなりません。大きなドキュメントは通常、ページを中間の /Pages ノードに分散させるからです。さらに、自分の祖先を指し返す不正なツリーへの防御も必要です。以下のスケッチでは、TPdfDict と TPdfArray は、使っているパーサーの辞書型と配列型の代役です:
type
  TPageList = array of TPdfDict;

procedure CollectPages(Node: TPdfDict; var Pages: TPageList;
  Depth: Integer = 0);
var
  Kids: TPdfArray;
  Child: TPdfDict;
  I: Integer;
begin
  if Depth > 64 then  // 循環か、病的に深いツリー
    raise EPdfError.Create('Page tree too deep or cyclic');
  Kids := Node.GetArray('Kids');
  if Kids = nil then
    Exit;
  for I := 0 to Kids.Count - 1 do
  begin
    Child := Kids.ResolveDict(I);  // インダイレクト参照をたどる
    if Child = nil then
      Continue;
    if Child.GetName('Type') = 'Pages' then
      CollectPages(Child, Pages, Depth + 1)  // 中間ノード
    else
    begin
      SetLength(Pages, Length(Pages) + 1);   // 葉:表示順で次のページ
      Pages[High(Pages)] := Child;
    end;
  end;
end;

// 使い方:カタログの /Pages エントリから開始する
SetLength(Pages, 0);
CollectPages(Catalog.ResolveDict('Pages'), Pages);
if Length(Pages) <> Catalog.ResolveDict('Pages').GetInteger('Count') then
LogWarning('Page tree /Count disagrees with the pages actually found');細部が2つ、意図的なものです。/Type エントリを持たない葉もページとして扱います。書き手によってはこれを省略するものがあり、ビューアはそういうファイルを問題なく開けるからです。そして最後の /Count 比較はコストゼロですが、呼び出し側がインデックスアクセスする前に、切り詰められたり手で編集されたりしたツリーを捕捉します
HotPDFでドキュメントを読み込むなら、この順序はロードの時点で解決済みです。ページインデックスはページツリーの表示順に従い、ネストした /Pages ノードも込みなので、インデックス0は常にビューアが表示する最初のページです。上の走査が重要になるのは、自分のコードがPDF構造を直接パースするときです
CopyPageFromDocument で論理インデックスを使う
HotPDFはページ順をロード時に解決するので、論理ページインデックスは呼び出し側の期待どおりの意味を持ちます。より高レベルの CopyPageFromDocument は0ベースの論理インデックスを受け取り、正しいページを宛先ドキュメントへコピーします:
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { logical page 0(userが見る最初のpage)をcopy }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;インデックスが表示順のインデックスであるため、CopyPageFromDocument は物理順と論理順が異なるドキュメントに対しても正しく動作します。バッチ操作には InsertPagesFromDocument が使えます。論理インデックスの配列を受け取り、1回のパスでコピーします
これがPDF解析について明らかにするもの
PDFの仕様は明確です。論理的なページの順序は、オブジェクト番号やバイトオフセットではなく、ページツリーの /Kids 配列によって定義されます(ISO 32000-1 §7.7.3.2)。ショートカットとして異なる順序を使用するパーサーは、ほとんどのジェネレータがページを自然な順序で書き込み、連番のオブジェクト番号を割り当てるため、目にする大部分のドキュメントで正しい結果を生成します。この誤りは、誰かが増分編集されたPDF、別のツールによって再編成されたPDF、または異なるレイアウトを選択したソフトウェアによって生成されたPDFを読み込むまで隠れています
自己生成したPDFだけを相手にテストしていては、この種の問題を完全に見逃します。ページ順序の処理には、さまざまなソースからのドキュメントのテストコーパスが必要です。増分保存、表紙が挿入されたスキャン済みドキュメント、オブジェクトグラフの線形化や最適化の仕方が異なるツールが生成したPDF。物理順と論理順が異なるドキュメントは、そのコーパスに恒久的な席を与えるに値します
HotPDF Delphi Component のページでは、CopyPageFromDocument、InsertPagesFromDocument、および MovePage を含む、ページ操作の完全なAPIについて説明しています