ビューアの検索ボックスは請求書の2ページ目で「Acme Corp」をハイライトします。ところが、減張されたページストリームを同じ9文字でバイト検索すると空振りです。最初の単語だけでも、ストリームには <0024004600500048> Tj のようなものが格納されていることがあります。埋め込みサブセットフォントの2バイトグリフコードであり、2つの単語の間の隙間はスペース文字ではなく位置指定オフセットが作っています。この社名を置き換えるには、コードを Unicode へデコードし、そこで照合し、ヒットを生んだ正確なバイトまで辿り戻り、同じフォントが理解できる新しいコードを書き込みます。サブセットが新しいテキストに必要なグリフを一度も含んでいなかった場合は、書き込むべきコードが存在しません
この背後にある要求は、平凡な文書メンテナンスです。会社名が変わり、3000件のアーカイブ済み請求書がまだ旧社名を運んでいる。契約テンプレートが昨年の期限日のままと言い出した。製造中止の部品番号を、全データシートで後継番号に変えなければならない。ワープロならどれも30秒の作業ですが、PDF ではどれも、ページの実際の格納方法という壁に突き当たります
PDFのページはテキストの代わりに何を格納するのか
PDF のページは、編集可能なテキストではなく、位置指定されたグリフを保持します。ISO 32000-1 §9.4 のもとで、コンテンツストリームは Tj や TJ のようなテキスト表示オペレータを駆動し、テキストマトリクスが定めた位置に文字コード列を描画します。コードは、現在のフォントが宣言するエンコーディングへのインデックスです。読める文字への帰り道は、/ToUnicode CMap(§9.10.3)か、/Differences 配列を持つ /Encoding か、Type0 フォントの CID マッピングチェーンを通ります。段落オブジェクトもテキストフローも存在せず、1つの可視単語を1つの文字列として格納する義務はプロデューサーにはありません。[(Ac) -12 (me)] TJ は、単語をカーニングするごく普通のやり方です
置き換えは、デコードの上にもう1つの要件を乗せます。テキスト抽出器は、Unicode を取り出したらバイト位置を捨てて構いません。置き換え器にはそれらが必要です。どの文字列オペランドのどのバイトが各グリフを生んだかを知らなければ、まさにその範囲だけを書き換え、他は一切触れないことができないからです。だからこそ、ストリームバイトへの素の StringReplace は、たまたま WinAnsi エンコーディングのファイルに対してさえ、間違ったツールです。どの ( が文字列のものか、どの Tf がバイトに意味を与えるフォントを選んでいるのかを、まったく知らないからです
デコード済みグリフ列の検索
HotPDF Delphi Component は、ロードした文書を SearchLoadedPageText と SearchLoadedDocumentText で検索します。ニードルを、各ページのデコード済み Unicode グリフ列に対して照合し、生のストリームバイトに対して決して照合しません。したがってヒットは、フォントがどうエンコードしていようがヒットです。デコードの間、各グリフは、文字列オペランド、TJ 配列項目、そして自分の来たバイトオフセットの記録を保持します。これが後の置き換えステップが倚るものです。同じグリフインタプリタが、Delphi でロード済み PDF からテキストを抽出するAPI を駆動しており、検索は単に、抽出が捨てるソース位置を保持し続けるだけです
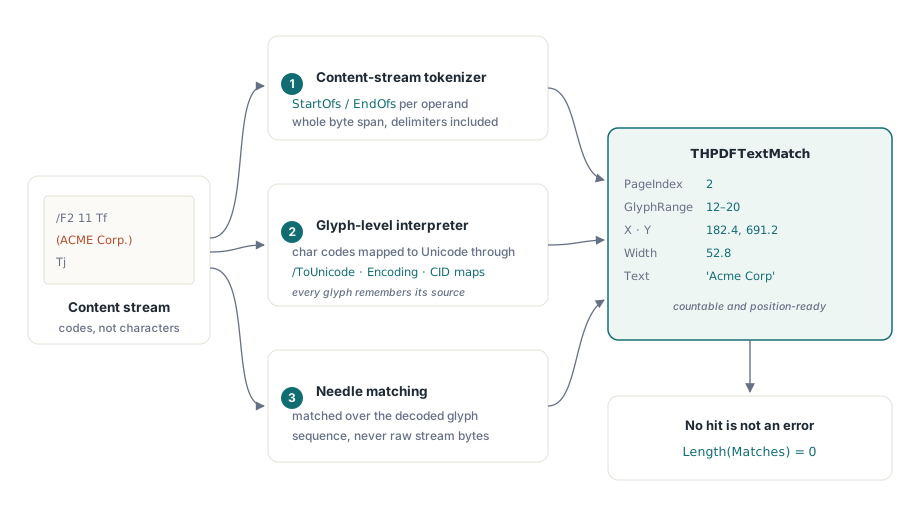
各ヒットは THPDFTextMatch レコードとして返ります。PageIndex、GlyphStart と GlyphEnd の両端を含むグリフ範囲、ユーザースペースの原点 X と Y、ヒットの Width、ソースの TokenIndex と ItemIndex、マッチした Text です。PageIndex はゼロ始まりです。ニードルが現れない場合、空の配列と True の結果が返るため、呼び出しコードに「見つからない」の場合分けは要りません
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to High(Matches) do
          WriteLn(Format('page %d at (%.1f, %.1f), width %.1f: "%s"',
            [Matches[I].PageIndex + 1, Matches[I].X, Matches[I].Y,
             Matches[I].Width, Matches[I].Text]));
  finally
    Pdf.Free;
  end;
end;
このループが何かを印字するかどうかは、何よりも先に、スペース次第です。検索テキストは、ページが実際に描くグリフから、グリフ1つにつき1文字で組み立てられます。視覚的に2つの単語を離す TJ のオフセットは、グリフではなく配列の中の数値です。スペース文字の代わりにオフセットで語間を設定するプロデューサーは、グリフ列に「AcmeCorp」を出し、ニードル「Acme Corp」はそれに一致しません。可視のフレーズが一致を拒むときは、まず最も長い単語1つで検索し、返ってきたものの Text を見てください
大文字小文字は、もう1つの確認点です。CaseSensitive を False にした場合、Delphi XE2 以降のビルドは文字を Unicode の simple lowercase マッピング経由で比較します。ロケール非依存であり、É は é に一致し、ギリシャ文字やキリル文字の大文字も小文字形に一致します。古いコンパイラのビルドは A〜Z だけを折りたたみます。マッピングは1文字対1文字なので、各ニードル位置は正確に1つのグリフと整列し続けます。帰結として、ß は SS に一致しません。単語単位の UI フローには、より長い単語の内側に座るヒットを落とす SearchLoadedPageTextWholeWord があり、ハイライトを描くための1つの矩形へマッチを変えるのが GetLoadedSearchHitRect です
検索と置換は、どちらもページ自身の /Contents ストリームの上で動きます。Form XObject の内側に描かれたテキスト、つまり多くのツールがスタンプ済みのヘッダーやフッターを置く場所は、ページが Do で呼び出す別のストリームに住んでおり、両操作の外側です
ReplaceLoadedDocumentTextでマッチしたバイトを書き換える
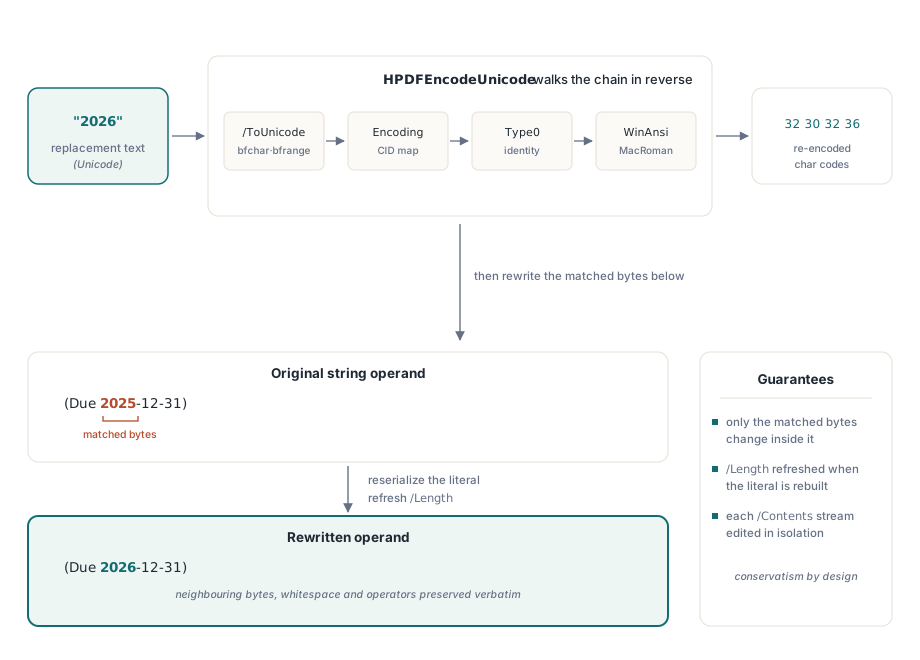
ReplaceLoadedPageText と ReplaceLoadedDocumentText は、フォントデコードを逆に走らせて、ニードルのすべての出現を書き換えます。各置換文字は、デコーダーが使うのと同じチェーンを逆向きに参照されます。/ToUnicode の bfchar と bfrange エントリ、Type0 フォントの CID マッピング、恒等マッピング、そして事前定義の WinAnsi と MacRoman テーブルです。できあがった文字コードは、リテラル文字列として、あるいは印刷可能 ASCII の外に出るバイトがあるときは16進文字列として書き戻されます。エスケープの規則は、コンテンツストリームパーサーが読むものと同じです
変わるのは、マッチがカバーするバイトだけです。同じオペランド内のマッチしないバイト、トークン間の空白、コメント、周囲のすべてのオペレータは、無傷で通ります。abcabc の内側の bca を置き換えると a + 置換 + bc になります。置換はニードルより短くても長くてもよく、ページの /Contents 配列の各ストリームは独立に処理されるため、ページは整形式を保ちます。マッチが複数の文字列オペランドにまたがるとき、たとえば Hello が [(He) -20 (llo)] TJ として格納されている場合は、置換はマッチの始まるオペランドへ書き込まれ、マッチしたバイトは後続のオペランドから取り除かれます
var
  Pdf: THotPDF;
  Rewrites: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, Rewrites) then
        WriteLn(Format('%d operand rewrites', [Rewrites]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
ページは再組版されません。PDF にリフローはありません。したがって元より幅の広い置換は、そのぶん水平方向の場所を取り、右に描かれたものにぶつかることがあります。次のグリフの位置はプロデューサーが固定しており、動きません。日付、バージョン文字列、部品番号、同程度の長さのスペル修正こそ、このメソッドが作られた仕事です。段落の言い換えは、下流のすべてを再組版することになるため、その変更はソース文書の側にあるべきです
フォントサブセットは、かつて含まなかった文字をなぜ受けられないのか
埋め込みサブセットが一度も含まなかった置換文字には、逆にたどる文字コードが存在しません。プロデューサーがフォントをサブセット化するとき、その /ToUnicode CMap とエンコーディングは、元の文書が使ったグリフだけをカバーし、それ以外のグリフの輪郭はそもそもファイルにありません。そのフォントで大文字の E を一度も印字していない文書では、どのバイト列もそれを選べません。この限界はファイルの中にあり、置き換えを行うツールの側にはありません
ReplaceLoadedDocumentText は、エンコードできない置換に対して保守的に振る舞います。1文字でも再エンコードできなければ、その出現は丸ごとスキップされます。例外も半分だけ置き換わった文字列もなく、元のテキストは読めるままです。上の日付の例では、数字の 6 が同じフォントのどこかに存在しなければ、書き換えは成功しません。フォントが「2025」と、6を含まない注文件数を印字したきりだとしましょう。日付は元のまま残ります
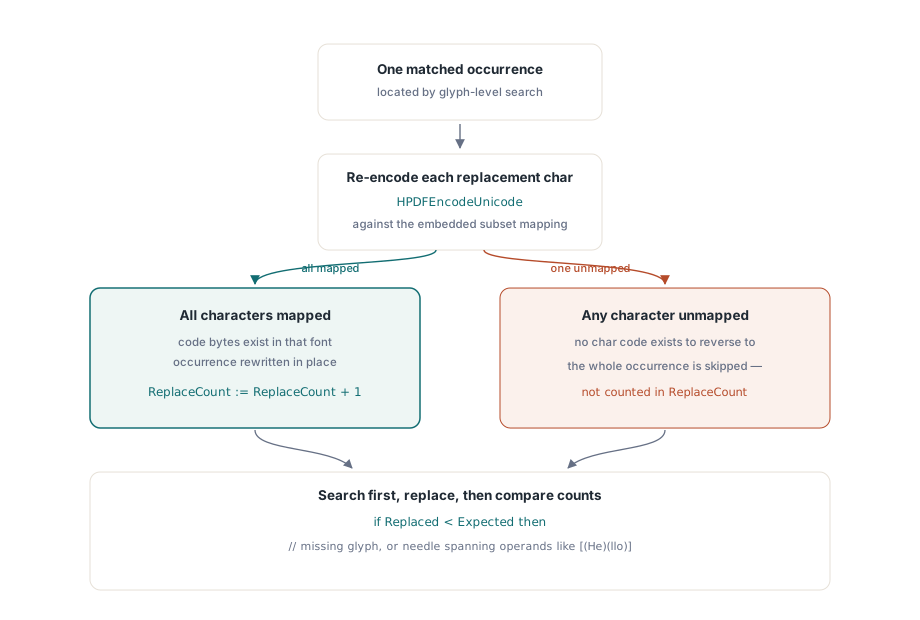
ReplaceCount はオペランドの書き換え数を報告し、複数のオペランドにまたがる1つのマッチは複数の書き換えとして数えられます。カウントがヒット数より少なければ、何かがスキップされたことは分かりますが、正確な答えは置き換え後の再検索から来ます。2回目の検索が見つけたものが、ページと位置つきで、残ったものです
procedure ReplaceAndAudit(Pdf: THotPDF; const OldText, NewText: UnicodeString);
var
  Before, After: THPDFTextMatchArray;
  Rewrites, I: Integer;
begin
  // 再検索が機能するのは、NewText 自身が OldText を含まないときだけ
  Pdf.SearchLoadedDocumentText(OldText, True, Before);
  Pdf.ReplaceLoadedDocumentText(OldText, NewText, True, Rewrites);
  Pdf.SearchLoadedDocumentText(OldText, True, After);
  WriteLn(Format('%d found, %d operand rewrites, %d left',
    [Length(Before), Rewrites, Length(After)]));
  for I := 0 to High(After) do
    WriteLn(Format('  left on page %d at (%.1f, %.1f)',
      [After[I].PageIndex + 1, After[I].X, After[I].Y]));
end;
サブセットが足りないとき:新しいフォントでのプレビューと適用
バイトレベルの方法ではエンコードできない出現には、PreviewLoadedPageTextReplacement と ApplyLoadedPageTextReplacement が別の道を取ります。マッチしたグリフを取り除き、選んだフォントで、元のサイズ、元のベースラインのまま、その場に置換を描きます。既定の THPDFLoadedTextReplacementOptions は、マッチしたテキストのフォントサイズで Arial を使い、ボックスをマッチしたテキストの幅に合わせ、Atomic をオンに保ちます。ページ上の1つの拒否されたマッチが、他をロールバックさせます。プレビューはマッチごとに1つの結果を持つ計画を返し、それぞれ Status を、拒否された場合は Reason を運びます
var
  Opts: THPDFLoadedTextReplacementOptions;
  Plan, Applied: THPDFLoadedTextReplacementPlan;
  I: Integer;
begin
  // Pdf はロード済みの THotPDF。PageIndex は監査が旗を立てたゼロ始まりのページ
  Opts := THPDFLoadedTextReplacementOptions.Default;
  Opts.Appearance.FontName := 'Arial';
  Opts.Appearance.OverflowPolicy := ltopShrinkToFit;
  Opts.Appearance.MinFontSize := 6;
  if not Pdf.PreviewLoadedPageTextReplacement(PageIndex, 'Acme Corp',
    'Apex Corporation', True, Opts, Plan) then
    for I := 0 to High(Plan.Results) do
      if Plan.Results[I].Status = ltrsRejected then
        WriteLn(Format('match %d at (%.1f, %.1f): %s',
          [I, Plan.Results[I].X, Plan.Results[I].Y, Plan.Results[I].Reason]));
  if (Plan.RejectedCount = 0) and (Plan.ReadyCount > 0) then
  begin
    Pdf.ApplyLoadedPageTextReplacement(Plan, Applied);
    WriteLn(Format('%d of %d matches applied',
      [Applied.AppliedCount, Applied.MatchedCount]));
  end;
end;
拒否の理由を印字する価値があるのは、ページのジオメトリに直接対応するからです。あるテキスト行から次の行へまたがるマッチは拒否され、縦書きのテキストもそうです。既定の ltopReject オーバーフローポリシーでは、マッチした幅に収まらない置換も拒否されます。ltopShrinkToFit は代わりに MinFontSize へ向かってサイズを段階的に縮めるため、例がこの設定を使うのは、置換がニードルより5文字長いからです。選んだフォントが表示できない文字を含む置換も同様に拒否されます
計画は、ページのコンテンツとフォントのフィンガープリントを運びます。プレビューと適用の間に何かがページを変えた場合、ApplyLoadedPageTextReplacement は、プレビューが見たことのないページへ書き込む代わりに EInvalidOpException を投げます。釣り合わない q/Q や BT/ET ペアを持つページと、署名フィールドを含む文書は EArgumentException を投げます。署名済み文書には、署名済みリビジョンを無傷に保つため、増分更新が必要です
バイトレベルの置換が先に走り、フォント差し替えの経路は、監査がまだ旧テキストを見つけるページでのみ動きます。バイトレベルの書き換えは元のフォント、そのメトリクス、カーニングを保つため、編集されたテキストは行の隣の文字と調和します。プレビュー経路は別の書体で描くため、コンデンスドやセリフのフォントで組まれた行では、目の肥えた読者には変更が見えます。テキストを言い換えるのではなく消すことが目的なら、真のコンテンツ除去のほうが良いツールです。Delphi でロード済み PDF を墨消し・再構成する記事がその道を扱います
保存されるファイルで何が変わるのか
ReplaceLoadedPageText が編集したコンテンツストリームは、無圧縮で保存されます。編集のためにストリームはデコードされ、再構築されたバイトが書き戻されるとき、/Filter と /DecodeParms エントリは落とされ、/Length が更新されます。PDF は有効で、普通に描画されます。代価は、編集されたストリームごとに大きくなるファイルです。何千もの請求書を回すバッチジョブは、その肥大化を見積もるか、後で圧縮パスを走らせるべきです
プレビュー・アンド・適用の経路は、もう少し多くを変えます。適用されたページは、元の /Contents の代わりに、1つの新しい無圧縮コンテンツストリームを受け取り、置換フォントを加えたリソース辞書の自分専用コピーを持ちます。文書内の他のすべては放置されます。触れていないストリームは圧縮を保ち、既存のフォントと画像は書き直されず、ヒットのないページは書き込みのために開かれることはありません。保存時に書き換えられたオブジェクトが相互参照構造へどう着地するかは、HotPDF のオブジェクトストリームと増分更新で扱っています
検索、バイトレベルの置換、プレビュー・アンド・適用の置換、抽出、墨消しは、すべて同じコンテンツストリームインタプリタ上で動き、Delphi 5 から現行の RAD Studio まで、外部依存なしで動きます。メソッドリファレンス、置換オプション、トライアルビルドは、HotPDF Delphi Component の製品ページにあります