生成多項式を定数項から順に格納し、その後で最高次の項から割っていくReed-Solomonエンコーダは、誤り訂正をまったく計算していません。HotPDFはまさにそれを4つの2Dバーコードエンコーダ、QR、Data Matrix、PDF417、Aztecに出荷し、それらが生成するすべてのシンボルは、適合スキャナが使えないチェックブロックを載せていました
面白いのは算数の間違いではありません。伝播です。1つのエンコーダが先に書かれ、その除算ループが次の3つにコピーされ、新しい形式はそれぞれ、公開されたテストベクタの1つにも照合されたことのない欠陥を継承しました。シンボルは描画され、ファインダーパターンは正しい位置にあり、サイズも正しかったのです。2Dバーコードが汚れを乗り越えるためのバイトだけが、ガラクタでした
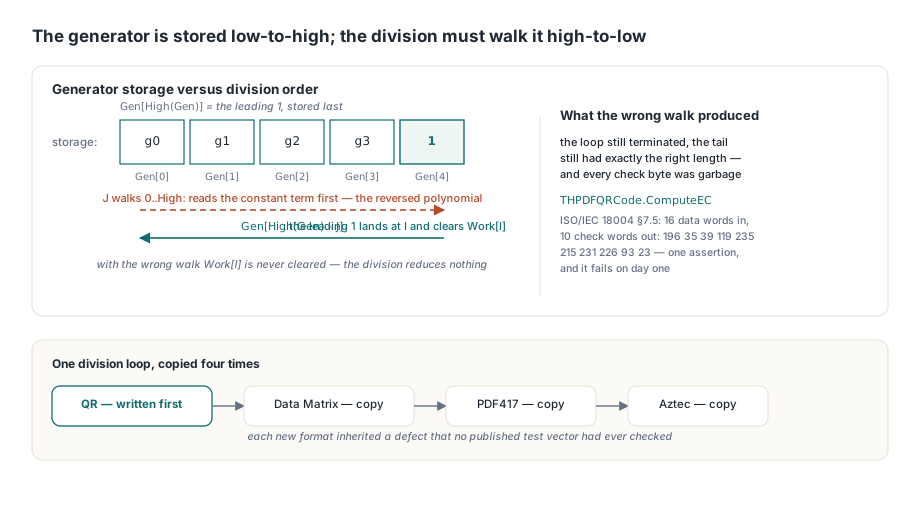
1つの逆順多項式が4つのエンコーダにコピーされた
根本原因は、組み立て除法ループの中での格納順の不一致です。HotPDFの4つのエンコーダはすべて、生成多項式を係数の低次から高次の順に構築するため、Gen[0]が定数項を、Gen[High(Gen)]がモニックな最高次係数を保持します。除算ループはメッセージを歩きながらGen[J]を順方向にインデックスしました。これは逆順の多項式で割ることと算術的に同一です。最初の問題を隠す2つ目の帰結がありました。最高次係数が位置Iに到達しないためWork[I]は決してクリアされず、除算は実際には何も減算しませんでした。それでもループは終了し、テールにはちょうど正しい長さの配列が埋められました
// HPDFQRCode.pas 内の THPDFQRCode.ComputeEC
Gen := GeneratorPoly(ECCount);            // Gen[0]は定数項
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)]はWork[I]をクリアする最高次の1。Genを順方向に
  // 歩くと逆順の多項式で割ることになる
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;修正は単一のインデックス式Gen[High(Gen) - J]です。その後に、THPDFQRCode.ComputeECはISO/IEC 18004 §7.5の計算例を再現します。バージョン1-Mのバイトモードブロック32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17は、10個のチェックワード196 35 39 119 235 215 231 226 93 23を生みます。それは1つのアサーションで、初日に失敗していたはずです
Aztecシンボルもなぜペイロードを失ったのか
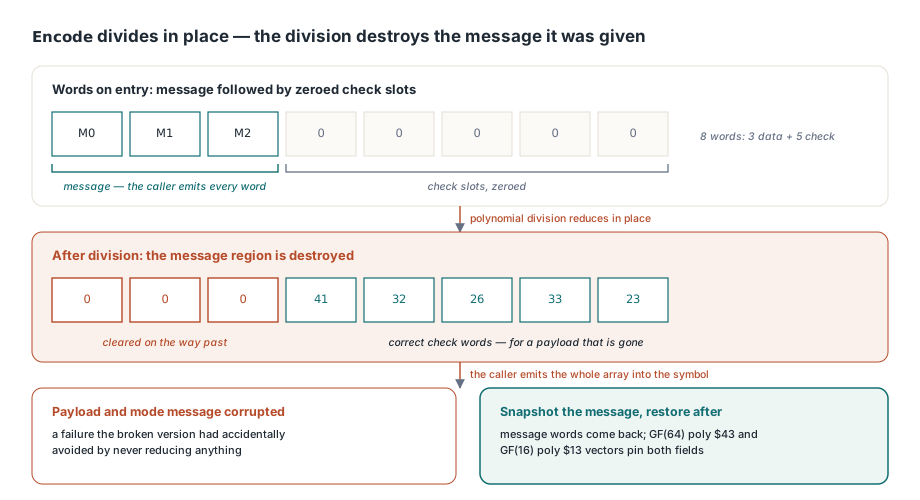
Aztecは同じバグの重い版を抱えていました。TAztecGF.Encodeがその場で除算するからです。このルーチンは、メッセージの後にゼロで埋められたチェックワード用スロットを続けたWordsを受け取り、呼び出し側はその配列全体をシンボルへ出力します。多項式除算は減算しながら被除数を破壊するため、ループを実際に減算するよう修正すると、メッセージワードも途中で上書きされました。ペイロードとモードメッセージの両方が壊れて出てきました。壊れた版が何も減算しないことで偶然回避していた失敗です
// HPDFAztec.pas 内の TAztecGF.Encode
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// 除算はメッセージ領域を消すが、呼び出し側は配列全体を
// シンボルへ出力するため、データワードは戻さなければならない
for I := 0 to DataCount - 1 do
Words[I] := Message[I];Aztecは2つの異なる体を使い、回帰テストフィクスチャは両方を実行します。GF(64)は原始多項式$43から作られる6ビットシンボルの体で、5つのチェックワードを伴うワード12 45 3は41 32 26 33 23を生み、先頭の3つは無傷のままです。GF(16)は原始多項式$13によるモードメッセージの体で、ワード5 9は11 15 6 8を生みます。どちらもHPDFAztecTestEncodeフックを通じてISO/IEC 24778に照合されます
Data Matrixが1つではなく2つの修正を必要とするのはなぜか
THPDFDataMatrix.ComputeECは、共通のエラーの上に2つ目の独立したエラーを積み重ねていました。根がα^0から始まる生成多項式を構築したのです。ISO/IEC 16022附属書Eは根がα^1から始まることを規定しているのにです。除算インデックスだけを修正すると、標準の例に対してチェックワード146 107 90 179 128が出ます。これは正しいものとまったく同じくらいもっともらしく見え、それでも読めません。数字が一致するには、両方の欠陥を取り除く必要がありました
// HPDFDataMatrix.pas 内の THPDFDataMatrix.ComputeEC
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1]:根はalpha^0からではなくalpha^1..alpha^ECCountを走る
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;参照点はコメントに収まる程度に小さく保つ価値があります。文字列'123456'はASCIIコードワード142 164 186にエンコードされ、10x10のシンボルは5つのチェックワードを運び、正しいブロックは114 25 5 88 102です。HPDFDataMatrixTestComputeECは{$IFDEF HPDF_TESTING}ゲートの背後にあるクラス関数を公開するため、フィクスチャはエンコーダをインスタンス化せず、ページも描画せずに、それら5つの値をアサートします。原始多項式$12DをInitDMTablesでDMExpとDMLogテーブルへ展開して作られるガロア体そのものは、ずっと正しいままでした。まさにそれが、バグがあれほど上手く隠れた理由です
PDF417は符号が重要な素数体で割る
PDF417は1つではなく4つの変更を必要としました。GF(929)が素数体であり2進拡大体ではないからです。加算はxorではなく、減算は加算ではなく、各生成因子の符号は表記ではなく実数計算です。各因子は(x - 3^i)でなければならず、コードでは929 - GF929Pow(3, I)の乗算を意味します。減算ステップは引き算でなければならず、根はISO/IEC 15438 §5.5により3^1から走り、Factorは内側のループが走る前にローカルへラッチしなければなりません。J = 0のパスがWork[I]を書き、そうしないと自分の下で乗数を変えてしまうからです。HPDFPDF417TestComputeECが修正後の結果を固定します。4つの誤り訂正ワードを伴うコードワード5 453 178 121 239は452 327 657 619を与えます
// HPDFPDF417.pas 内の THPDFPDF417.ComputeEC
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // 因子は (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // ラッチ:J = 0がWork[I]を書き換える
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
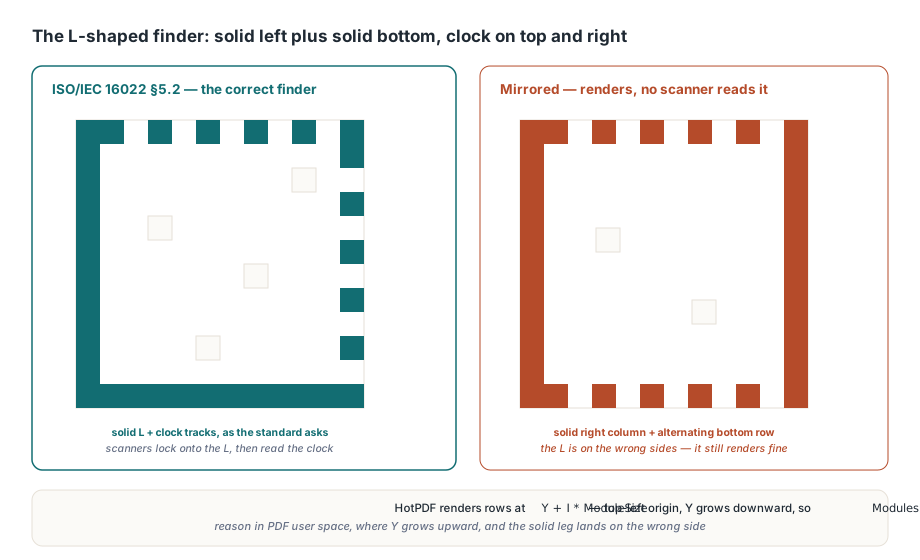
Data Matrixのファインダーが裏表逆に配置されていた
正しいチェックワードは、ファインダーパターンが鏡像になったシンボルを救いません。同じリリースでそれも修正しなければなりませんでした。配置コードは、塗りつぶした左列と塗りつぶした右列、そして上辺と下辺に沿った交互モジュールを描きました。ISO/IEC 16022 §5.2が求めるのは、塗りつぶした左列と塗りつぶした下辺、つまりL字型ファインダーで、交互クロックトラックは上辺と右列に沿って走ります。これを逆にしやすいのは座標規約のせいです。HotPDFはモジュール行をY + I * ModuleSizeで描画します。これは左上原点の意味論で、Modules[Size - 1, *]が印刷シンボルの最下行になります。Yが上向きに伸びるPDFユーザ空間で考える人は、塗りつぶし脚を間違った側に置き、画面上では何も怪しく見えません
壊れた4つのエンコーダが何年もテストを通ったのはなぜか
テストが構造をアサートし、欠陥が算数の中にあったからです。既存のQR、Data Matrix、Aztecのテストケースはファインダーモジュール、タイミングパターン、シンボル寸法を検査しました。そのすべては本当に正しかったのです。チェックワードを公開ベクタと比較したテストは一度もありませんでした。2つ目の理由はさらに一般化します。HotPDFは内蔵のQRデコーダを同梱しており、それでエンコーダを検証するのは明らかなラウンドトリップに見えます。ただしこのデコーダはデータコードワードを読むだけでReed-Solomon訂正を行わないため、エンコーダが書いたものをそのまま読み戻して成功を報告しました。エンコーダとデコーダが同じ前提を共有しているとき、ラウンドトリップテストが証明するのは両者が一致していることであって、どちらかが正しいことではありません。誤り訂正符号は、規格に印刷されたベクタに対して検証しなければならず、自分のデコーダに対してではありません。フィクスチャTHPDFBarcodeECCTestsは今、形式ごとに1つのテストを持ち、それぞれが固定する内容にちなんで命名され、{$IFDEF HPDF_TESTING}の下でのみコンパイルされるフックを通じて算数に到達します
QRCheckWordsMatchISO18004Exampleはバージョン1-Mバイトモード例の10個のチェックワードをアサートしますDataMatrixCheckWordsMatchISO16022Exampleはコードワード142 164 186に対する114 25 5 88 102をアサートしますPDF417CheckWordsMatchGF929Referenceは根3^1から3^4でGF(929)上の452 327 657 619をアサートしますAztecCheckWordsKeepMessageAndMatchReferenceはチェックワードと、メッセージワードがインプレース除算を生き延びることをアサートします
4つの質問で、あなたが保守するどのエンコーダでもこの種の欠陥のほとんどを捕まえられます。生成多項式の格納順は除算のインデックス順と一致していますか。それを証明する行を指し示せますか。根は規格の言う場所から始まっていますか。Data Matrixではα^1、PDF417では3^1です。インプレース除算はその後メッセージ領域を復元しますか。少なくとも1つのテストが、モジュール数ではなくチェックワードを、仕様に印刷された数と比較していますか。既存の成果物をどうするか決めるとき、範囲も重要です。v2.748.0より前に生成されたシンボルは描画され、理想的な条件ではしばしばスキャンも通ります。きれいな画像は読むのに訂正を必要としないからです。失われたのは、これらの形式を選ぶ理由そのものである損傷耐性です。影響を受けたシンボルを載せた長期ラベルやアーカイブ文書は、スマホカメラでスポットチェックするより再生成する価値があります。エンコーダはHotPDFのバーコードサポートの中にあり、QRデコード経路とその向きの処理、そしてシンボルをページに配置するレポート出力レイヤーと並んでいます。完全なバーコードAPIリファレンスは、DelphiとC++Builder向けのHotPDF Delphi Componentに同梱されます