パーサが不正なPDFでハングするのは、ある分岐が1バイトを読み、それを処理せず、カーソルを動かさないまま戻るときです。呼び出し側のループは進展も停止する理由も見えないので、永遠に回り続けます。HotPDFはまさにこの欠陥を3つの独立したパーサに出荷しており、そのすべてが50バイト未満の入力から到達できます
これは名前を付けて区別する価値のあるサービス拒否(DoS)のクラスです。誰もがすでに防御しているタイプとは見た目が違うからです。解凍もなく、割り当ての増大もなく、ウォッチドッグを発火させるメモリ圧力もありません。プロセスはバッファの中の数バイトを相手に、1コアでCPU使用率100パーセントのまま座っているだけです。ネストしたフィルタ増幅とPDF爆弾の記事を読んでデコード予算を足したとしても、その予算はここでは発火しません。何もデコードされず、何も割り当てられないからです。失敗の種類が違えば、修正も違います
40バイトのファイルが解凍爆弾より高くつくのはなぜか
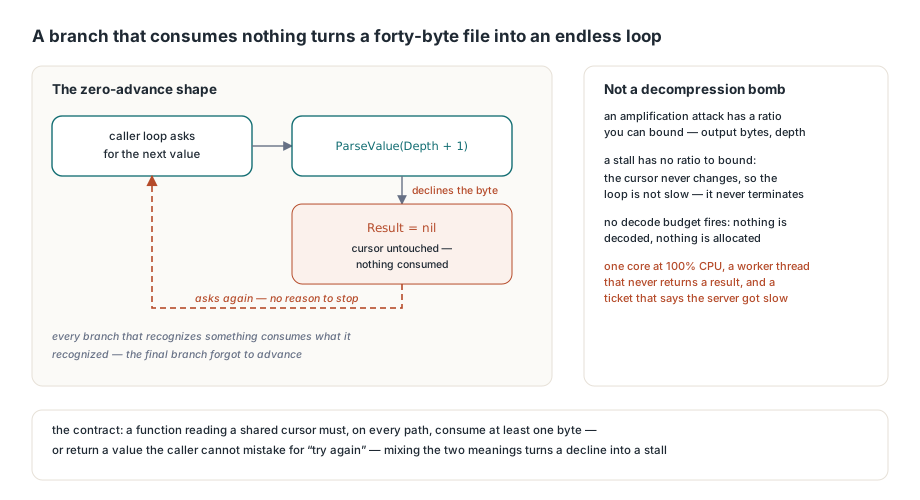
そのコストは入力サイズとまったく関係がないからです。増幅攻撃には制限できる比率があります。出力バイトに上限をかけ、再帰深度に上限をかけ、最悪ケースは有限になります。前進ゼロのループには制限できる比率がありません。ループ条件が決して変わらないカーソルの関数なので、遅いのではなく終了しないのです。上流でどれだけサイズ上限を設けても、それを捕まえられません。運用上も独特に厄介です。クラッシュならスタックが取れ、メモリ不足ならログの行が出ますが、ストールしたパーサが残すのは、結果を返さないワーカースレッドと、下流の何も開始に気づいていないためにタイムアウトしないリクエストと、「火曜日にサーバが遅くなった」というチケットです。構造的な原因はいつも同じ形をしています。トークナイザか値パーサには、現在のバイトで分岐するチェーンがあります。何かを認識した分岐は、認識したものを消費します。そして最後の分岐、あるいはチェーンの前のガードが、誰にも主張されないバイトに対して戻り値を返します。作者はそれをスキャン手順ではなくエラー経路とみなします。エラー経路は戻ります。スキャン手順は進みます。1つの関数が両方を兼ねなければならないとき、忘れられるのは前進の方です
オブジェクトパーサ:誰も消費しなかった2つのデリミタ
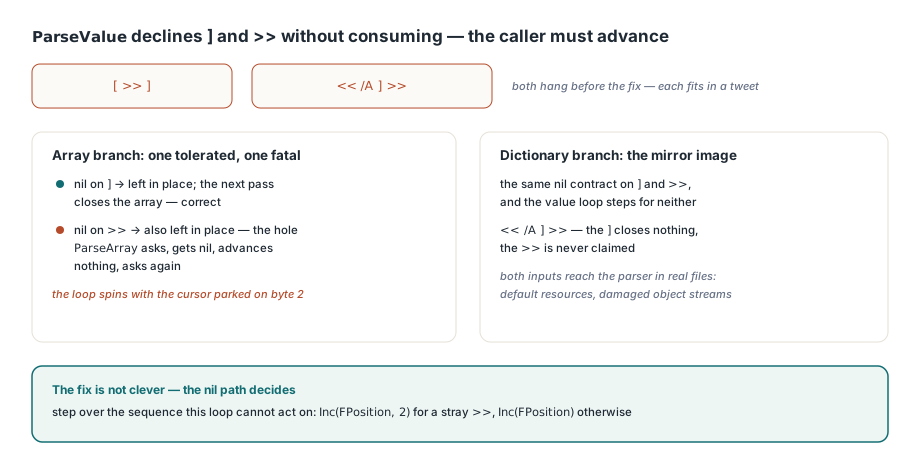
HPDFParserのTHPDFSpanObjectParser.ParseValueは、2つのバイト列を最初から拒否することから始まります。ISO 32000-1 §7.3によれば、値は]や>>で始まれません。これらは値を開くのではなくコンテナを閉じるものだからです。したがってParseValueは両方を消費せずにnilを返します。これは正しい契約であり、前進する責務のすべてを呼び出し側に負わせます。配列分岐はその半分を守りました。nilの結果に対して]を検査し、次回のパスで配列を閉じられるようそこに残し、それ以外はすべて踏み越えました。ただし、その検査はたまたま、迷い込んだ>>もそこに残す書き方になっていました。だから[ >> ]はハングします。ParseArrayが値を要求し、nilを得て、何も進めずにまた要求するからです。辞書分岐には鏡像の穴があり、<< /A ] >>も同じようにハングします。どちらの入力もパーサに到達するには十分に正しく、ツイートに収まる程度に短いのです
uses
  HPDFObjs, HPDFParser;

procedure ProbeParserStalls;
var
  Stats: THPDFParserViewStatistics;
  Arr: THPDFArrayObject;
  Dict: THPDFDictionaryObject;
begin
  // 修正前は、以下のどちらの呼び出しも決して戻りませんでした
  Arr := HPDFParserParseSimpleArrayWithStatistics('[ >> ]', Stats);
  Arr.Free;
  WriteLn('array errors=', Stats.ErrorCount, ' valid=', Stats.Valid);

  Dict := HPDFParserParseSimpleDictionaryWithStatistics('<< /A ] >>', Stats);
  Dict.Free;
  WriteLn('dict errors=', Stats.ErrorCount, ' valid=', Stats.Valid);
end;
修正は賢くありません。そこが要点です。nil経路は、未消費の2つのシーケンスのうち現在のループが処理できるのはどちらかを明示的に決め、もう片方を踏み越えなければなりません
Value := ParseValue(Depth + 1);
if Value = nil then
begin
  RecordError;
  // ParseValueは']'と'>>'の両方に、消費せずにnilを返す
  // ']'は次のパスで配列を終えるが、迷い込んだ'>>'は
  // 配列内では踏み越えないとパースが進まない
  if (FPosition < FLength) and StartsWithPair('>', '>') then
    Inc(FPosition, 2)
  else if (FPosition < FLength) and (CharAt(FPosition) <> ']') then
    Inc(FPosition);
  Continue;
end;もう1つ、ここで注目に値することがあります。THPDFSpanObjectParser.RecordErrorはTHPDFParserViewStatisticsのErrorCountを増やすだけで、何も上限を設けません。パーサはネストを制限するためにHPDFParserMaximumDepthを64に設定しますが、エラー数に相当する上限はありません。誰も読まないカウンタは、外されたサーキットブレーカーです。前進が戻ったとしても、1バイトあたり1エラーを生む入力は、全体走査ではなく早期終了に値する速度で大きなオブジェクトを食い尽くします。パースのたびに統計レコードのValidを確認し、大きなErrorCountを単なる診断情報ではなく、オブジェクトを信頼するのをやめる理由として扱ってください
CMapトークナイザとXFDFリーダにも同じ形
HPDFCMapReader.NextTokenは、そのフォールバック分岐にまったく同じ欠陥を抱えていました。この関数はTCMapTokを返し、<、(、/を専用の分岐で処理し、それ以外は「空白かデリミタまで読む」に落ちます。開始バイト自体がISO 32000-1 §7.2.2の集合のデリミタである場合、そのループは0回実行され、トークンは空で返り、呼び出し側は同じトークンをまた要求します。そこに落ち得る6文字のうち、[だけはbfrange処理が先に捕捉するため、ToUnicode CMapのどこかに迷い込んだ)、>、]、{、}のいずれか1つで、テキスト抽出がストールするのに十分でした
// キーワードまたは数値:空白かデリミタまで読む
StartP := P;
while (P <= Len) and (not IsCMapWhiteSpace(Text[P]))
  and (not IsCMapDelimiter(Text[P])) do
  Inc(P);
// 上のどの分岐も主張しないデリミタ(迷い込んだ')'、'>'、
// '['、']'、'{'、'}')はPをその場に残し空の
// キーワードを返すため、呼び出し側は同じトークンを永遠に要求し続ける
if P = StartP then
  Inc(P);
AKeyword := Copy(Text, StartP, P - StartP);
Result := ctKeyword;XFDF側には、由来は異なるが同じ効果を持つ亜種がありました。HPDFXFDFXml.ParseElementは冒頭でResult := Pを設定します。Pがまだ開きの<を指しているうちに、です。その後でローカルのカーソルを進めるため、それに続くすべての早期終了は、先にResultを上書きしない限り、エントリ位置を返します。XML 1.0 §2.8によるDOCTYPE宣言や、<1a>のようなパース可能なタグ名を持たないものは、Resultを決して更新しない終了経路を取り、子要素ループは渡した位置をそのまま受け取りました。属性ループにはさらに3件あります。ReadNameも空白スキップも=処理も、名前文字でも空白でも=でも>でも/でもないバイトを拒否し、どれもそれを消費しないからです。隣のCDATA修復は、ガードを足すのではなく責任を移動しました。XML 1.0 §2.7によるCDATAセクションは<で始まるため、子ループは以前それをParseElementに渡し、そこがセクション内容からタグ名を読み出していました。IsCDATAStartで子ループ内に認識し、IsCDATAEndまでバイトをテキストバッファへコピーするのが正しい分担です。古いスキップも1バイト分しかありませんでした。マーカーが!から数えて8バイトだからです
宣言カウントがデータより長生きする
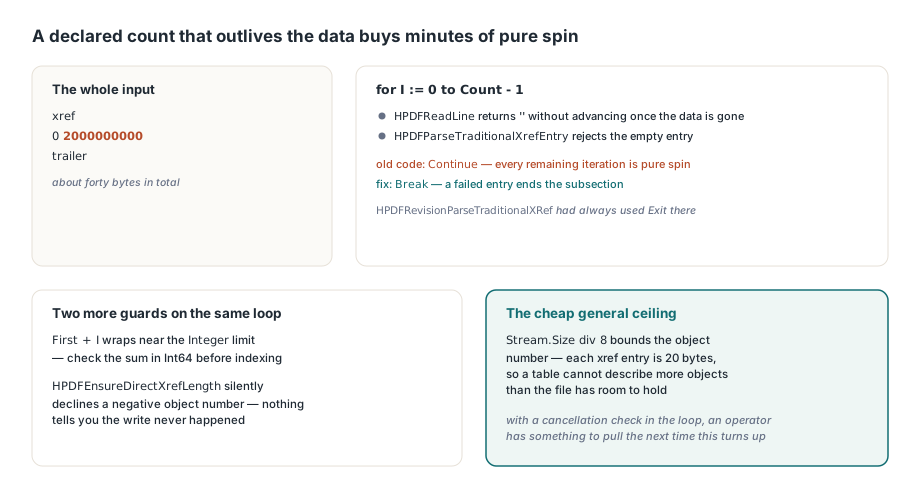
後のリリースで、同じパターンが反対方向から浮上しました。そしてこれが、自分のコードに存在する可能性が最も高い亜種です。ISO 32000-1 §7.5.4によるクロスリファレンスサブセクションヘッダはfirst countのペアで、HotPDFの伝統的なxrefパーサは2つとも、それに対してfor I := 0 to Count - 1でループし、エントリのパース失敗ではBreakではなくContinueを使いました。それは1行の不良への寛容に見えます。実際は違います。HPDFReadLineはデータが尽きると進めずに空文字列を返し、HPDFParseTraditionalXrefEntryは空のエントリを即座に拒否するため、宣言カウントの残りの反復はすべて純粋な空回りです。算数も容赦ありません。xref\n0 2000000000\ntrailerというヘッダに最小限のラッパーを足すと約40バイトで、ループのどこにもキャンセル検査がないまま、ビジーコアの数十秒を買えます。手がかりは同じユニットにありました。HPDFRevisionParseTraditionalXRefはその位置でずっとExitを使ってきたからです。同じ文法をパースする2つの関数が、失敗したエントリでサブセクションを終えるべきかについて食い違うとき、その片方は修正を受け取るのをやめたフォークです。これはハイブリッドクロスリファレンス処理で、伝統的なテーブルとストリームが同じオブジェクトを記述する場面に現れるのと同じシグネチャです
if not HPDFParseIntegerPair(Line, First, Count) then
  Exit;
for I := 0 to Count - 1 do
begin
  Entry := HPDFReadLine(XrefData, P);
  // 宣言カウントがテーブルより大きい場合、読み取るデータが
  // 残っていないままここで空回りすることになる
  if not HPDFParseTraditionalXrefEntry(Entry, EntryOffset, GenNum, InUse) then
    Break;
  // Firstはサブセクションヘッダ由来なので、宣言開始位置が
  // Integerの限界付近だと合計がラップし、成長ヘルパは
  // 負のインデックスを黙って拒否する
  if (First < 0) or (Int64(First) + I > MaxInt) then
    Break;
  ObjNumber := First + I;
  if (ObjNumber < 0) or (Int64(ObjNumber) > Stream.Size div 8) then
    Break;
  HPDFEnsureDirectXrefLength(State, ObjNumber);
  // ... エントリを記録する ...
end;Breakの後にある2つの境界は同じ修復に属します。HPDFEnsureDirectXrefLengthは負のオブジェクト番号に対して配列の拡張を拒否し、それについて何も言いません。First + IはIntegerの限界付近の宣言開始位置でラップするため、負のインデックスが下の書き込みに到達します。Stream.Size div 8というオブジェクト番号の上限は安上がりな汎用解です。伝統的なクロスリファレンステーブルは、ファイルが収められる以上のオブジェクトを記述できず、それ以外を主張するヘッダは存在しないファイルを記述しているからです。壊れたテーブルを手作業で修復しているなら、同じ理屈が逆側からも当てはまります。それが手編集されたPDFの診断と修復のメモが扱う領域です
ハング修正が実際に効くことをどう証明するか
古いコードを走らせることです。読み直すのではありません。ストールは、計装なしのバイナリ信号で修正を検証できる数少ない欠陥クラスの1つです。プロセスが戻るか戻らないかのどちらかであり、制御フローについての推論は、そもそもそのバグを作った張本人のスキルだからです。その手順は真似する価値があります。変更したユニットの修正前リビジョンをスクラッチディレクトリに展開し、ユニット検索パスがそのディレクトリを実ライブラリより先に置くようにして、小さなプローブを1つコンパイルします。dcc32 -U<scratchdir>;<Lib> probe.dprです。コンパイラは先に見つけたものを古いソース、それ以外を現在のソースとして取るので、1つのプローブバイナリが古いパーサをライブラリの残りと一緒に実行します。タイムアウト付きで走らせてください。40秒あれば十分です。終了コード124をアサーションとみなします。その後、スクラッチディレクトリからユニットを1つずつ退かして再ビルドします。3件のストールはすべてこの方法で再現し、それぞれ特定のユニットに帰属でき、修正済みソースがパスに戻ると3件とも戻りました。ユニット1つにつきコンパイル1回のコストでです
試す前に知っておくべき落とし穴が2つあります。ユニット検索パスは黙って寛容です。シェルから-Uへ$PWDのようなUnix形式のパスを渡すと、コンパイラは一言も言わずにそのディレクトリを無視し、プローブは現在のソースに対してコンパイルされ、間違った理由でパスします。まずパスをネイティブなWindows形式に変換してください。2つ目は、スクラッチディレクトリがインクルードファイルを持ち込まないことです。HotPDF.incのために-I<Lib>も必要で、これがないとビルドはパス問題ではなくソース問題に見える形で失敗します。そして、この方法が与えてくれないものについて正直になりましょう。特定の入力が特定のビルドでハングしなくなったことを確認するだけで、思いつかなかった入力については何も語りません。前進ゼロの欠陥は、ファジングか、すべてのトークナイザのすべての分岐を読むことで見つかります。事後的に書いた回帰テストでは見つかりません
自分のパーサで監査すべきこと
再利用できる規則は契約であって、チェックリストの項目ではありません。共有カーソルから読み取る関数は、失敗経路を含むすべての経路で、最低1バイトを消費するか、呼び出し側が「もう一度試して」と誤解できない値を返さなければなりません。この2つの意味を単一のnilや単一の空トークンに混ぜることが、拒否をストールに変えるのです。だから症状ではなく形を監査してください。終了が他関数の所有するカーソルに依存するループをすべて見つけ、その関数が現在のバイトを拒否したら何が起きるかを問いかけます。「Xまで読む」と書かれたフォールバック分岐をすべて見つけ、カーソルがすでにXの上にいるときに何をするかを問いかけます。ファイルからではなくデータから出たカウントで境界づけられたループをすべて見つけ、失敗した要素は反復をスキップするのではなくループを終えさせてください。同じ文法を2か所でパースしているなら、差分を取ってください。片方が受け取り、もう片方が受け取らなかった修正があるからです。そして、呼び出し側が供給する反復回数だけ走り得るループにはキャンセル検査を入れ、次にこれが本番で現れたときにオペレータが引く何かを用意しておいてください
ここで説明したパーサは、統計レコードと深度制限を公開した状態で、DelphiとC++Builder向けの現在のHotPDF Delphi Componentに同梱されます。自分の堅牢化がその上に構築できるようにです