HotPDFは、人間が読んで編集できるよう設計された診断形式でロード済みドキュメントを保存し、編集後にそのファイルを修復できる。SaveLoadedDocumentDiagnosticは、決定的な辞書順序、通常の間接オブジェクトとしてのすべてのオブジェクト、オブジェクトストリームなし、クロスリファレンスストリームなし、リニアライズなしでドキュメントを書き出す。その後、編集によって無効になったバイトオフセット、ストリームの長さ、相互参照テーブル、トレーラーをRepairDiagnosticDocumentが再構築する
この一対の機能は1つのワークフローのために存在する:PDFの中に実際に何が入っているかを理解し、あるいは修正することである。レンダリングの問題をデバッグしたことがある開発者なら誰もが、ファイルを開いて1つの辞書の1つの数値を変更し、結果を見たいと思ったことがあるはずだ。通常のPDFではそれは不可能である。コンテンツはオブジェクトストリームに圧縮されており、挿入する1バイトごとに、相互参照テーブルが厳密に記録しているオフセットがずれてしまうからである
診断保存が通常の保存と異なる点
6つの設定がまとめて変更される。辞書のキーは決定的な順序で書き出されるため、同じドキュメントの2回の保存結果を比較できる。診断出力モードは構造に注釈を付ける。完全な書き直しが強制されるため、手を加えられていない増分リビジョンとして持ち越されるものは何もない。リニアライズされたファイルはリーダー向けではなくWebビューア向けに構成されているため、リニアライズはオフになる。クロスリファレンスストリームはオフになるため、テーブルはプレーンテキストになる。そしてオブジェクトストリームもオフになるため、圧縮コンテナの中に隠されるオブジェクトは存在しない
その結果得られるファイルは、ヘッダーに通常の%PDF-署名と並んで診断用マーカーを持ち、本文はどのエディタでもページ送りして読める。オブジェクトは1つずつ順に現れ、辞書は判読でき、コンテンツストリームも見つけられる場所に置かれる。修復ツールはそのマーカーを確認し、それを持たないファイルは拒否する。なぜなら、通常のPDFのコンパクトな構造はバイト範囲修復ツールが解釈を試みるべきものではないからである

uses
  HPDFDoc;

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoice.pdf') <= 0 then
      Exit;
    // blockごとに1 object、object streamに隠れたもののないReadable output
    Pdf.SaveLoadedDocumentDiagnostic('invoice-diagnostic.pdf');
  finally
    Pdf.Free;
  end;
end;
編集がファイルを壊す理由、そして何を再構築する必要があるか
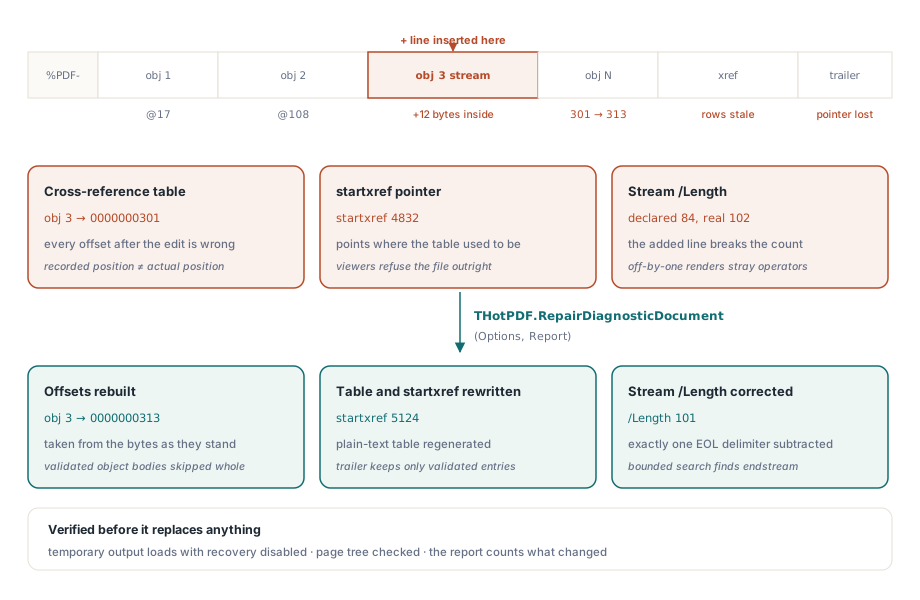
PDFの中で3つの要素がバイト位置またはバイト数を符号化している。相互参照テーブルはすべてのオブジェクト番号をバイトオフセットにマッピングする。ファイル末尾のstartxrefの値はそのテーブルを指す。そしてすべてのストリーム辞書は、ストリーム本体が何バイトを占めるかを示す/Lengthを持つ
ファイル末尾より前のどこか1文字を変更すれば、それ以降のオフセットはすべてずれてしまう。コンテンツストリームに1行追加すれば、その/Lengthもずれる。ほとんどのビューアはそのファイルを拒否し、復旧できるビューアもスキャンによってそれを行うため、誤りを修正するのではなく覆い隠してしまう。修復処理は、現在のバイトが実際に示している内容から、これら3つすべてを再構築する
var
  Options: THPDFDiagnosticRepairOptions;
  Report: THPDFDiagnosticRepairReport;
begin
  Options := THPDFDiagnosticRepairOptions.Default;
  Options.VerifyOutput := True;         // replace前にresultをload

  if THotPDF.RepairDiagnosticDocument('invoice-diagnostic.pdf',
       'invoice-fixed.pdf', Options, Report) then
    Writeln(Format('%d objects, %d streams, %d lengths corrected, ' +
      '%d xref rows rebuilt, %d pages verified',
      [Report.ObjectCount, Report.StreamCount,
       Report.RepairedStreamLengthCount, Report.RebuiltXRefEntryCount,
       Report.VerifiedPageCount]))
  else
    Writeln(Format('repair failed (%d): %s',
      [Ord(Report.Status), string(Report.Diagnostic)]));
end;
バイトをコピーする、再シリアライズはしない
このツールを信頼できるものにしている設計上の決定は、ドキュメントを一切ロードして書き戻すことをしない点にある。検証済みのオブジェクトのバイト範囲をコピーし、誤っている/Lengthの値だけを変更し、その周囲にテーブル、トレーラー、startxrefを再構築する
ロードして再シリアライズする方が実装ははるかに簡単だが、それは静かに何かを変えてしまう。未知のオブジェクト構文は正規化され、文字列のエスケープはライターの好む形式に書き換えられ、すでにエンコード済みのストリームペイロードが再エンコードされてしまうこともある。デバッグツールとしてはそれは受け入れられない:1つの数値を編集したなら、差分は1つの数値だけを示すべきであり、無関係な書式変更が千個も現れてはならない。2つのファイルの間で正確に何が変わったかを知りたい場合、それは比較の問題であり、構造とピクセルによる2つのPDFファイルの比較で扱われている

誤ったオブジェクトの検出を防ぐ2つの解析規則
バイト範囲スキャナーは明白な罠に直面する:オブジェクトヘッダーに見えるテキストが、ストリームのペイロード内や文字列の中に現れることがある。素朴なスキャンでは、コンテンツストリームの途中を指す相互参照の行が出力されてしまい、その結果得られるファイルは新たな、より紛らわしい形で壊れてしまう
HotPDFはこれを、記録済みの終端オフセットを使って、検証済みの各オブジェクトのバイト範囲全体をスキップすることで回避する。そのためオブジェクト本体の中にあるものが候補として扱われることは決してない。オブジェクトとオブジェクトの間には、PDFの空白文字とコメントのみが許され、それ以外が現れればその領域は理解できないことを意味し、そのバイト列を出力に取り込んではならない
ストリームの長さも同等の注意を必要とする。実際のペイロードの長さは、ライターがendstreamの前に挿入する行末デリミタを除いたものである。宣言された長さがそのマーカーにちょうど一致する場合、その宣言はそのまま受け入れられる。一致しない場合、修復処理はendstreamとendobjのペアを範囲を限定して探索し、CR、LF、またはCRLFのいずれか1つのデリミタ分だけを正確に差し引く。これを1バイトでも誤ると、開けはするがコンテンツストリームの末尾に1つ余計な演算子を持つページをレンダリングするファイルができてしまう
トレーラーが保持を許されるもの
再構築されたトレーラーは古いものの単なるコピーではない。/Size、/Prev、/XRefStmはいずれも以前のファイルレイアウトを記述するものであり、再計算されるか破棄される。ターゲットが検証済みのエントリのみが残される:/Info、/ID、/Encryptである。そして/Rootは正確に1つのCatalogオブジェクトに解決されなければならない——0個でも複数個でもなく、それはオブジェクトブロックをコピー&ペーストで組み立てたファイルにありがちな状態である
出力の安全性は、人々が大切にするファイルに対して動作するツールにふさわしい方法で扱われる。結果はターゲットディレクトリ内の一時ファイルに書き出され、その後クロスリファレンス復旧を無効化した通常の経路でロードすることで検証される。そのため、復旧のおかげでしか開けないファイルは失敗として扱われる。ページツリーが検証された後にのみ、一時ファイルはターゲットをアトミックに置き換える。修復に失敗した場合、既存の出力が上書きされることは決してない
予算と正直な失敗コード
作業には3つの上限がある:入力バイト数、候補オブジェクト数、最大オブジェクト番号であり、デフォルトはそれぞれ8 GiB、200万、200万である。オブジェクト番号の上限は見た目以上に重要である。なぜなら、数個のオブジェクトが数十億台の番号を持つ疎なテーブルは、そうでなければ再構築される相互参照テーブルを途方もなく肥大化させてしまうからである。クラシックな相互参照テーブルはまた、10桁を超える10進数を必要とするオフセットも拒否するが、これは実装上の選択ではなくフォーマット上の制限である
失敗はブール値ではなく具体的なステータスを報告する:引数が不正、ソースが大きすぎる、診断ファイルではない、オブジェクト数上限超過、不正なオブジェクト、重複オブジェクト、カタログ欠落、不正なトレーラー、出力エラー、検証失敗である。それぞれが異なる修正方法に対応する。重複オブジェクトは、あるオブジェクトブロックを2回貼り付けてしまったことを意味する。カタログ欠落は通常、/Type /Catalogを保持するオブジェクトが破損していたことを意味する。検証失敗は、構造は今や一貫しているがページツリーがロードされないことを意味し、これは典型的には/Kids配列がその/Countと食い違う形で編集されたことによる
実務上の注意点を2つ挙げて締めくくる。修復済みのファイルだけでなく診断用ファイルも保持しておくこと。そうすれば次の編集は読みやすいベースから始められる。そして診断出力をエンドユーザーに配布しないこと。何もオブジェクトストリームに圧縮されていないため通常の保存より大きくなる。コンパクトなファイルのための本番用経路はオブジェクトストリームと増分更新で説明されている通常の保存経路である。目的が変更ではなく何が問題かを見つけることである場合、プリフライトレポートの自動化にある自動化された経路の方が、バイトを読むより速く答えを出す
診断保存、修復、プリフライト、比較はいずれも、DelphiおよびC++Builderにおいて同じロード済みドキュメントモデル上で動作する。機能一覧の全体はHotPDF Delphi PDFコンポーネントページにある