OCRテキストレイヤー、バーコード境界、顔の黒塗りボックスが、トリミングされたPDFページでずれるのは、ビットマップのピクセルを、レンダラーが実際にラスタライズしたボックス——MediaBoxへクリップされたCropBox(ISO 32000-1 §14.11.2)——ではなくMediaBox経由でページへ写し戻すからです。HotPDFはApplyLoadedOCRTextLayer、DecodeLoadedPageBarcodes、DetectLoadedRedactionFindingsの結果をその可視ボックスを通してマップします。そして自作のエンジンや検出器にも、同じことをしてもらわなければなりません
症状は、一度見てしまえば容易に見分けがつきます。スキャンした契約書アーカイブをOCRパイプラインにかけると、出力は検索可能で、条項番号の検索ヒットが、印字された番号の半インチ下・左にハイライトされます。バッチの中の大半のファイルは正常です。ずれたものはすべて、原稿台の余白を切り落とす/CropBoxを書く1つのスキャンステーションから来ています。この1つの細部が、OCRエンジンが見た絵と、テキストレイヤーが置かれたフレームを切り分けており、同じ食い違いがバーコード境界を動かし、もっと深刻には、顔の黒塗りボックスを動かします
OCRテキストレイヤーがスキャンされた単語からずれる理由
テキストレイヤーがずれるのは、パイプラインの2つの半分が、ビットマップがどの矩形を覆うかについて食い違うときです。HotPDFの描画、SVGエクスポート、ビュアー、印刷はすべてCropBoxに従います。ページは、ISO 32000-1 §14.11.2が定めるとおり、MediaBoxへクリップされたCropBoxを通して表示され、GetLoadedPageVisibleBoxはその可視ボックスを返します。一方、GetLoadedPageBox(PageIndex, pbMediaBox, ...)から組み立てたデバイスからページへの変換は、ラスタがMediaBoxを覆うと仮定します。ラスタと変換は異なる矩形を記述することになり、認識された位置はすべて、2つの間の隙間ぶんだけオフセットされて返ってきます
これを正しくやるということは、認識機能ごとに3つの事柄を一致させておくことです。変換、ピクセル予算の見積り、そしてリクエストレコードでカスタムエンジンに渡されるページボックスです。HotPDFは3つすべてを可視ボックスから導出します。これはまた、認識がビュアーが実際に表示するコンテンツだけを見ることを意味します
この食い違いの影響を受けないケースがいくつかあります:
/CropBoxのないページや、CropBoxがMediaBoxと等しいページは、どちらのボックスを通しても同一にマップされますHasRegionを設定したDecodeLoadedPageBarcodesは、渡されたリージョンを正確に描画し、その同じリージョンを通してマップします。リージョンがページ内にあるかの検査はMediaBoxを使います- パターンベースの黒塗り検出結果(メールアドレスやカード番号など)は、ラスタからでなくユーザー空間のテキスト抽出から来るため、ラスタマッピングに依存するのは顔検出の検出結果だけです
3つの座標フレームと、どのHotPDF APIがどれを使うか
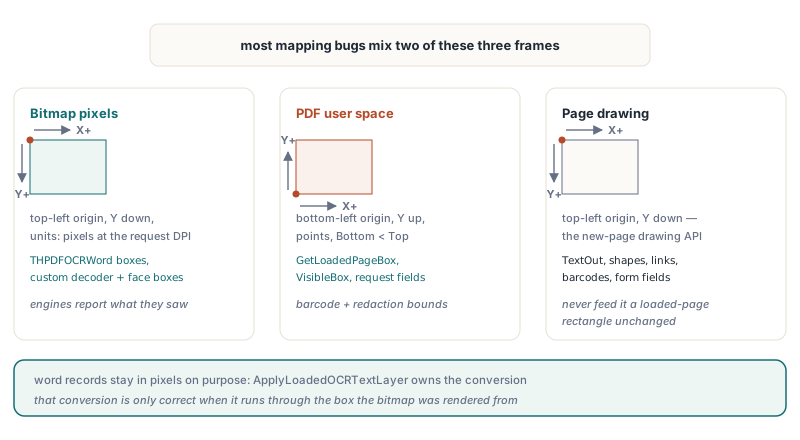
認識に触れるHotPDFコードは3つのフレームを扱い、マッピングエラーの大半はそのうち2つを混ぜることから来ます
- ビットマップピクセル:左上原点、Yは下向き、単位はリクエストDPIでのピクセルです。
THPDFOCRWord.Left、Top、Right、Bottomはこのフレームにあります。オプションのベースライン点も、カスタムIHPDFBarcodeDecoderが返す結果も、カスタムIHPDFFaceDetectorのボックスもそうです - ロード済みページのPDFユーザー空間:左下原点、Yは上向き、単位はポイントで、
Bottom < Topです。GetLoadedPageBoxとGetLoadedPageVisibleBoxはこのフレームでLeft、Bottom、Right、Topを返します。そしてTHPDFOCRRequestのPageLeft、PageBottom、PageRight、PageTopフィールドも、THPDFDecodedBarcodeの境界も、THPDFRedactionFindingの矩形もそうです - HotPDFのページ描画座標:新しいページを組み立てるAPI(テキスト出力、図形、バーコード、リンク、フォームフィールド)は、左上原点と下向きのYで働きます。このフレームはドキュメント生成の持ち物で、上のロード済みドキュメントAPIとは無関係です。だからロード済みページのユーザー空間矩形を、変更せずにここへ食わせてはいけません
OCRの単語レコードが意図的にピクセルベースなのは、エンジンが画像で見たものを報告し、変換はApplyLoadedOCRTextLayerが所有するからです。この分担が機能するのは、変換が正しいボックスを使っているときだけです。だからこそHotPDFは、それを可視ボックスから組み立てます
OCR、バーコード、顔の背後にあるデバイスからページへの変換
HotPDFはビットマップピクセルを、5つの入力から組み立てた1つのアフィン行列でページへマップします。回転、スケールDPI / 72、ビットマップの高さ、そして描画されたボックスのLeft、Bottom、Right、Topです。OCR、バーコードデコード、顔検出はこれに1つのルーチンを共有するため、ボックス入力が3つすべての精度を一度に決めます。回転されていないページでは、ページからデバイスへの行列[A B C D E F]はこうなります:
A = ScaleとD = -Scale。ただしScale = DPI / 72。負のDが、ユーザー空間(Y上向き)をビットマップ空間(Y下向き)へ反転させますB = C = 0。回転されていないページには、軸間のシアーや入れ替わりがないからですE = -Left * Scale。ボックスの左端をピクセル列0へ動かしますF = BitmapHeight + Bottom * Scale。ボックスの下端をy = BitmapHeight、つまりビットマップの下端へマップし、上端が行0に着地するようにします
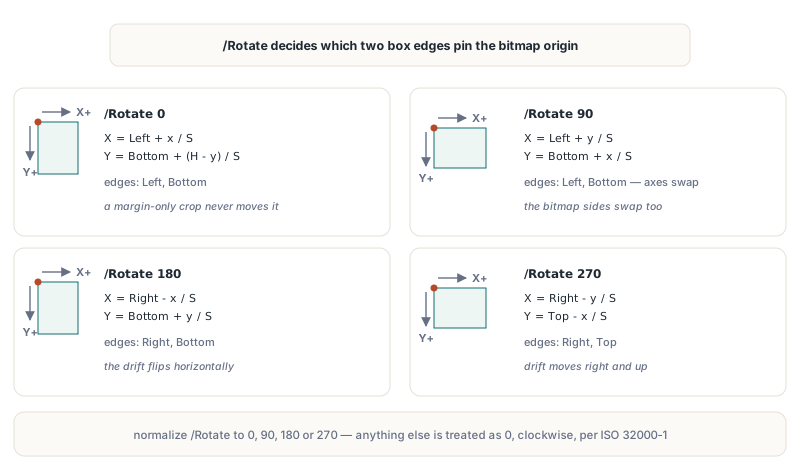
ピクセルはその行列の逆変換でページへ戻ります。Request.PageRotationはページの/Rotateを0、90、180、270へ正規化して運びます(90の倍数でない値は0として扱われ)、レンダラーはISO 32000-1 §7.7.3.3が要求するようにページを時計回りに回します。回転の下では軸が入れ替わり、別のボックス辺のペアがビットマップ原点へ固定されます。逆公式として書き出すと、S = DPI / 72、xとyはピクセル、Hはビットマップの高さです:
| /Rotate | ページX | ページY | マッピングが依存するボックス辺 |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left、Bottom |
| 90 | Left + y / S | Bottom + x / S | Left、Bottom |
| 180 | Right - x / S | Bottom + y / S | Right、Bottom |
| 270 | Right - y / S | Top - x / S | Right、Top |
最後の列が、MediaBoxベースのマッピングが本番でランダムに見える理由を説明します。ページの上だけを切り落とすCropBoxはLeftとBottomに触れないので、正立ページは完璧に出て、/Rotate 270を運ぶページだけがずれます。回転はビットマップの寸法も入れ替えます。90と270では、ビットマップは幅(Top - Bottom) * Sピクセル、高さ(Right - Left) * Sピクセルになります
MediaBox [0 0 612 792]とCropBox [36 36 576 756]で何が起きるか
全辺を半インチずつ切り落とすと、MediaBoxを使った回転なしページのテキストレイヤーは、スキャンされた単語から正確に36ポイント左、36ポイント下へ着地します。各辺から36ポイント(0.5インチ)を切り落とすCropBoxを持つUS Letterページを考えます。可視ボックスは540×720ポイントなので、デフォルトOCR解像度の300 DPIではスケールは300 / 72 ≈ 4.1667で、ビットマップは2250×3000ピクセルです
エンジンが、ピクセルボックスLeft 450、Top 600、Right 900、Bottom 660でベースラインなしの単語を報告したとします。HotPDFはベースラインを、単語の高さの20%ぶん下端の上に置き、ピクセル行648に来ます。そして始点(450, 648)をマップします:
- 可視ボックス経由:x = 36 + 450 / 4.1667 = 144.0、y = 36 + (3000 - 648) / 4.1667 = 600.48。単語が印字されているのはまさにここです
- MediaBox経由:x = 0 + 108.0 = 108.0、y = 0 + 564.48 = 564.48。(-36, -36)ポイントの一様なシフトです
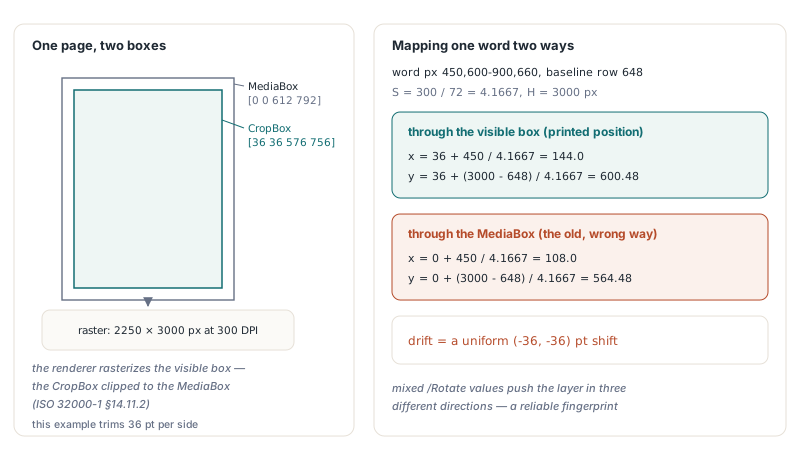
同じページを回すと、関わる辺が変わるのでエラーの方向も変わります。/Rotate 180ではXの項がRightを使い、576でなく612がレイヤーを36ポイント右へ押しやり、Bottomは依然として36ポイント下へ引きます。/Rotate 270ではRightとTopの両方が大きすぎて、レイヤーは36ポイント右、36ポイント上へ動きます。向きの混ざったドキュメントは、ずれを3方向に示し得ます。この間違いの頼もしい指紋です。ボックスからスケールを導く手書きコード、たとえばBitmap.Width / (Right - Left)は、そのオフセットに加えて、すべての座標を612 / 540、およそ13%ぶん引き伸ばしもします
自分のPDFページのどれにCropBox対応マッピングが必要か
少なくとも1ページの可視ボックスがMediaBoxと異なるとき、PDFドキュメントには注意が必要です。HotPDFなら、それを数行で調べられます。全ページについて、pbMediaBox付きのGetLoadedPageBoxをGetLoadedPageVisibleBoxと比較し、上の表からずれの方向を予測できるよう、GetLoadedPageRotationも並べて印字してください。THPDFPageBoundaryにはpbCropBox、pbBleedBox、pbTrimBox、pbArtBoxもありますが、GetLoadedPageBox(pbCropBox)はcropボックスが存在しないときMediaBoxへフォールバックし、クリップはしません。だから比較すべき相手は可視ボックスです
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // 保存された配列は四隅をどの順でも列挙し得る
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // すでに正規化されMediaBoxへクリップ済み
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;この種のスクリプトにとって、GetLoadedPageVisibleBoxの2つの細部が効いてきます。この関数は失敗時にoutパラメーターへ触れないので、呼び出し前にデフォルトのページサイズを仕込んでおくのは安全なパターンです。そして不正なCropBoxがMediaBoxとまったく交差しないとき、関数は空の矩形でなくMediaBoxを返します。レポートが、以前のパイプラインがMediaBoxベースのマッピングでOCRをかけたページを列挙しているなら、コミット済みのテキストレイヤーは保存ファイルの中に残り続けることを忘れないでください。デフォルトのSkipPagesWithTextオプションは、オフにするか古いレイヤーを先に取り除かないかぎり、2回目のパスでそれらのページをスキップします
カスタムIHPDFOCREngineはピクセルをPDF空間へどう写し戻すべきか
カスタムIHPDFOCREngineは、単語ボックスをビットマップピクセルで返し、マッピングはHotPDFに任せるべきです。ユーザー空間への変換は自分の判断のためだけに行い、そのときはリクエストのボックスを使い、MediaBoxは決して使いません。リクエストのPageLeft、PageBottom、PageRight、PageTopは描画された可視ボックスを記述するので、Request.Bitmapと正確に一致します。下のヘルパーはライブラリの変換の逆で、正立ページに実際のビットマップ高さを使う点まで含めて、ピクセル単位でHotPDFと一致します
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// ビットマップピクセル(左上原点、Y下向き)をPDFユーザー空間へ
// (左下原点、Y上向き)。ビットマップの描かれたボックスを通して
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;エンジンの内側でユーザー空間が要る現実的な理由は、ゾーンルールです。レターヘッドを検索可能にされたくない請求書や、認識器を混乱させるスタンプ領域です。下のエンジンは、生存期間を参照カウントに任せるためTInterfacedObjectで書かれており、単語の中心がページ上のどこに落ちるかでフィルターし、生き残ったものをピクセル座標のままそのまま返します。RunRecognizerがあなたの認識器呼び出しの代役です
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // ユーザー空間
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // 自前の認識器、ピクセルボックス
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // まだピクセル:マッピングはHotPDF自身がやる
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;このエンジンは、他のエンジンと同様にApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info)へ渡します。ライブラリは信頼する前に、返ってきたものを検証します。ボックスがビットマップを外れたとき、Right <= LeftかBottom <= Topのとき、あるいはConfidenceが0..1の外にあるかMinimumConfidence未満のとき、単語は破棄されてInfo.DroppedWordCountに数えられます。MaxWordsPerPageを超える単語の返却や、累計をMaxTotalWordsへ押し込むことは、予算エラーで呼び出し全体を失敗させるので、エンジン内でRequest.MaxWordsを守ってください。返す前に単語ボックスをユーザー空間へ変えてはいけません。HotPDFはポイント値をピクセルとして扱い、レイヤーはビットマップ原点へ潰れます
自前の検出器出力のマッピング
同じヘルパーは、RenderLoadedPageToBitmapの上に組まれた自家製パイプラインにも使えます。これは認識機能と同じく、可視ボックスを描画し/Rotateを適用します。ボックスはGetLoadedPageVisibleBoxで読み、回転はHotPDFと同じやり方で正規化し、各ピクセルボックスの対角の2隅をマップします。Y軸は反転し、90度と270度では軸が入れ替わるので、マップされた隅は決まった順で出てきません。マップされた点の最小と最大を取ってください。HotPDFがバーコード境界を組み立てるのも同じやり方です
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // 自前のコード、ピクセルボックス
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;回転の挙動については、ページボックスを壊さずにページ回転をフラット化するで、同じ変換を消費するバーコードデコードパイプラインは、PDFページから回転QRコードをデコードするで、それぞれより深く扱っています。エンジンが外部認識器を包むなら、検索可能PDFのためのTesseract OCRアダプターが、同じインターフェースのプロセス分離とキャンセルの側面を示します
クイックリファレンス:CropBox安全な座標マッピング
- レンダラーがラスタライズするのは可視ボックス、つまりMediaBoxへクリップされたCropBoxです(ISO 32000-1 §14.11.2)。ピクセルからページへのマッピングはすべて、
GetLoadedPageVisibleBoxで読んだそのボックスを使わなければならない ApplyLoadedOCRTextLayer、ページ全体のDecodeLoadedPageBarcodes、DetectLoadedRedactionFindingsによる顔の検出結果は、すべて可視ボックスを通してマップします。カスタムのエンジンや検出器もそうしなければなりませんTHPDFOCRWordボックスは左上原点のビットマップピクセル。GetLoadedPageBoxとGetLoadedPageVisibleBoxは、左下原点でBottom < TopのPDFユーザー空間を返す- スケールは
DPI / 72。DPIから導くこと。ページボックスをビットマップ幅で割るやり方では決してない - /Rotateがどの辺が効くかを決める。0と90ではLeftとBottom、180ではRightとBottom、270ではRightとTop
- OCR単語はピクセルで返し、マッピングはHotPDFに任せる。変換するのは自分のフィルタリングロジックのためだけ
- すでにテキストレイヤーを運ぶページでOCRを再実行するときは、
SkipPagesWithTextがそれらのページをスキップすることを忘れないこと。オフにするか、古いレイヤーを先に取り除く
ここで使った認識機能、ページボックス照会、ロード済みドキュメントの描画は、すべてDelphiとC++Builder向けのHotPDFコンポーネントに同梱されています。ライセンス、トライアルダウンロード、完全な機能リストは、HotPDF Delphi PDF component pageにあります