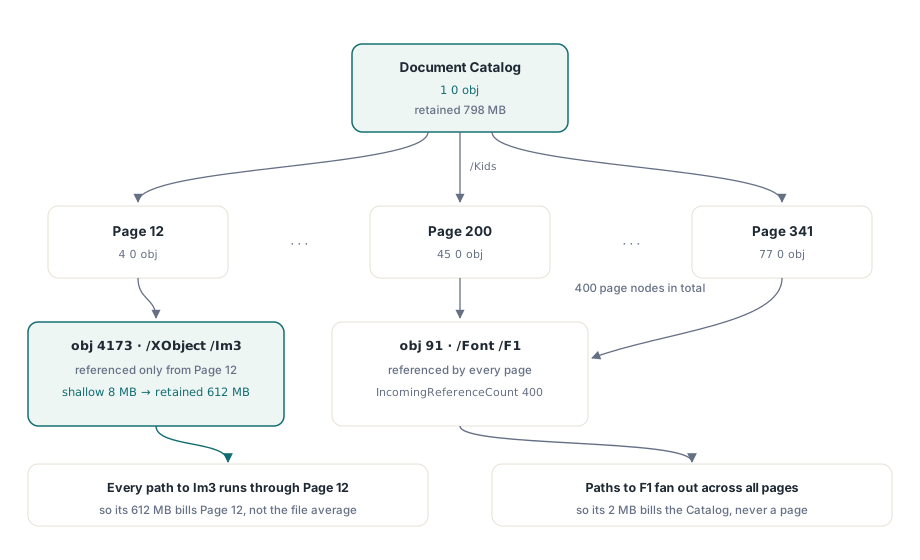
2 MBのフォントを1つ埋め込んだ400ページのレポートで、参照するすべてを各ページに課金すると、奇妙な合計になります。ページを足し上げるとフォントは800 MBになり、ディスク上のファイルは30 MB程度かもしれません。逆にフォントを均等割りにすれば各ページの負担は約5 KBで、高価なものは何もなく、メモリはどこからともなく湧いてきたように見えます。どちらの数字も、本当の問い、すなわちあるオブジェクトが消えたときに何バイト解放されるのかには答えてくれません
この数字はヒープ解析の世界では保持サイズ(retained size)という名前を持ち、グラフ理論にはそれを計算するきれいな方法があります。オブジェクトはドミネーターに課金されます。ドミネーターとは、ルートからそこへ至るすべての経路が通過する最も近いオブジェクトのことです。共有オブジェクトは本当に所有するノードにたどり着くまで上位へ浮かび、排他的なオブジェクトはその場に留まり、合計は二重計上なしに足し上がります
HotPDFにおけるシャロウサイズ、保持サイズ、ドミネーターの規則
HotPDFは、ロード済みドキュメントに対してこの計算をTHotPDF.BuildLoadedObjectDependencyGraphで行います。この呼び出しは、ロード済みの間接オブジェクトごとに1つのTHPDFObjectDependencyNodeを、間接参照ごとに1つのTHPDFObjectDependencyEdgeを返した後、トレーラーの/Rootエントリが名指すオブジェクト、すなわちドキュメントCatalogをルートとするドミネーター解析(ISO 32000-1 §7.7.2)を実行します。各ノードは2つのサイズを持ちます。EstimatedShallowBytesはオブジェクト単体でかかるコスト、EstimatedRetainedBytesはそのコストに、自分が支配するすべてのオブジェクトのシャロウコストを加えたものです
フォントに戻ると、すべてのページがこれを参照するため、これを支配する単一のページは存在しません。経路が収束するのは、それらのページの上にあるページツリーノードで、フラットなツリーならルートの/Pagesオブジェクトです。フォントの2 MBはそこに着地し、さらにCatalogへと持ち上がります。ページ12でだけ描画される画像XObjectは正反対で、そこへのすべての経路がページ12を通るため、ページ12の保持サイズに画像全体が含まれます。したがって保持リストの上位は、取り除けばメモリが解放されるオブジェクトのリストになります
同じ計算から、検算が1つ無料で手に入ります。THPDFObjectDependencyGraphInfo.CatalogRetainedBytesはCatalogから到達可能なすべてのオブジェクトのシャロウサイズの合計に等しく、TotalEstimatedBytesは到達可能性にかかわらず、ロード済みのすべてのオブジェクトのシャロウサイズの合計です。この2つの差が、ドキュメントがもはや指していないオブジェクトが抱えているメモリです
グラフの実行と失敗した結果の読み方
このメソッドは解析全体が完了したときにだけTrueを返すため、確認すべきはこの戻り値です。Falseのときもinfoレコードは埋まりますが、その配列を報告に使うべきではありません。オブジェクト数がMaxObjects(デフォルト250,000)を超えると、メソッドはノードを1つも構築する前に停止し、ObjectCountを上限より1大きい値に設定します。わかるのは上限が小さすぎたことだけで、ドキュメントがどれほど大きいかはわかりません。エッジ予算(デフォルト2,000,000)や直接オブジェクトの256レベルのネスト上限が走査中に使い切られた場合、ノードは部分的なシャロウサイズだけで返り、保持サイズも到達可能性もまったく入りません
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFileはページ数を返す。0はロード失敗
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // オフラインのフォレンジック実行向けに上限を引き上げる
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Logは独自のログ出力ルーチン
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // 部分的なノード配列をランク付けや合計に使わない
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;失敗側の分岐には、ほかに見ておくべきフラグが2つあります。InvalidObjectGraphは、Catalogオブジェクトがロード済みオブジェクトの中に見つからないとき、あるいは直接オブジェクトが自分自身を含んでいることが判明したときに設定されます。後者は入力が壊れている場合にしか起こりません。LimitExceededは、128パス経ってもドミネーター解析が収束しないケースもカバーします。Diagnosticがそれぞれのケースを1行で説明します。MaxObjectsにゼロか負の値を、MaxEdgesに負の値を渡した場合は、Falseを返す代わりにEArgumentOutOfRangeExceptionが送出されます
上限で失敗したら、配列は捨てて、より大きなバウンドで実行し直してください。部分的なシャロウサイズはログの上ではもっともらしく見えるのに、まさに人を間違ったオブジェクトへ向かわせる形で間違っています。このバウンドが存在するのは、グラフ自体にもコストがあるからです。すべてのエッジはPath文字列を保持するため、800万エッジの実行は、計測対象のドキュメントの上にさらに800万個の小さな文字列を確保します。この解析は、誰かが意図して起動する診断経路に置くべきものです
EstimatedShallowBytesが実際に数えるのは何か
EstimatedShallowBytesが推定するのはファイルの中のバイト数ではなく、常駐メモリです。オブジェクトごとに、パース済みオブジェクトとその直接の子のインスタンスサイズ、辞書リストと配列リストが保持するスロット、すべてのキー・名前・文字列の長さを加算し、さらにストリームのペイロードがRAMにある場合(メモリストリーム、あるいはすでにメモリへ読み込まれた遅延ロードのストリーム)にはそのペイロードも加えます。バイトがまだソースファイルの中にいるストリームや、一時ファイルへ退避されたストリームは、オブジェクト自体のオーバーヘッドしか寄与しません
ここから実用上の帰結が生まれます。スキャン中心のファイルをロード直後にプロファイルすると、画像の保持サイズは控えめに見えることがあります。まだ何もデコードしていないからです。プロセスを膨らませた処理(レンダリング、テキスト抽出、マージ)の後にグラフを実行すれば、実体化したストリームが本当の重さで現れます。再現性のあるチェックには、同じファイルを2回プロファイルしてください。LoadFromFileの直後に1回、高コストな操作の後に1回実行して、上位エントリを比較します
ObjectTypeは粗い分類です。報告するのはPDFの値の型で、otStreamやotDictionaryなどにすぎないため、画像もフォントプログラムもページコンテンツストリームも、すべてotStreamに見えます。役割が現れるのは入ってくるエッジの側です。THPDFObjectDependencyEdge.Pathは、参照がソースオブジェクトのどこで見つかったかを記録します。$で始まり、辞書エントリは/Key、配列項目は[n]、ストリームの辞書は/dictionaryで表されます。ページからの$/Resources/XObject/Im3や、独立したリソース辞書からの$/XObject/Im3は、そのオブジェクトがIm3という名前のXObjectとして使われていることを意味し、フォントディスクリプタからの$/FontFile2は埋め込みTrueTypeプログラム、$/Contents[0]はページコンテンツを意味します
// ライブラリの一部ではない独自のヘルパー:上位Count個のノードを
// 保持サイズ順にランク付けし、入力参照のパスを1つ出力する
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;ほとんどのオブジェクトは、入力経路が1つあれば分類できます。共有オブジェクトなら、IncomingReferenceCountが参照の数を教え、ドミネーター解析の後はImmediateDominatorObjectNumberとその世代番号が、どのオブジェクトが所有者かを教えてくれます。このフィールドはCatalogと、Catalogから到達できないすべてのオブジェクトで-1になります。ResolvedフラグがFalseのエッジは、ロードされていないオブジェクト番号を指しており、これらはUnresolvedReferenceCountに数えられます。他は健全なファイルでこの数が多いときは、たいていクロスリファレンスセクションの破損を意味します
到達不能なオブジェクトはどこから来るのか
ReachableFromCatalogがFalseのノードはロード済みでメモリを消費しますが、Catalogからの参照チェーンがそこへ至らないため、ドキュメント構造のどこにもビューアをそこへ導くものがありません。ドミネーター解析は到達可能なオブジェクトだけを対象に走るため、このノードの保持サイズはシャロウサイズと等しくなります。したがって、到達不能ノードにわたってEstimatedRetainedBytesを合計すると、TotalEstimatedBytes - CatalogRetainedBytesと同じ答えになります
増分更新もよくある発生源ですが、多くの人が思い浮かべる形での話ではありません。後のリビジョンがオブジェクト2120を再定義すると、最新のクロスリファレンスエントリが勝ち、古い定義は決してロードされません。つまり同じオブジェクト番号の置き換え前のコピーはグラフに現れません。現れるのは、後のリビジョンが単に参照しなくなったオブジェクトです。書き直された/Annots配列から落ちた注釈、新しいオブジェクト番号に置き換えられた画像、AcroFormから削除されたフォームフィールドです。ISO 32000-1 §7.5.6のどこにも、更新がそれらのエントリを空きとして印を付ける義務はなく、クロスリファレンスデータが使用中として列挙している限り、ローダーはそれらを生きたオブジェクトとして扱います。リビジョンが積み重なる仕組みは、オブジェクトストリームと増分更新の記事で扱っています
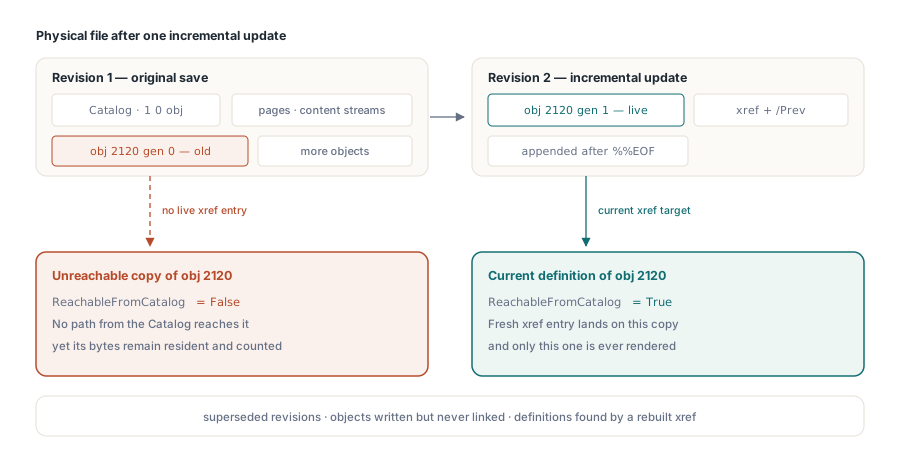
残る2つの発生源は、オブジェクトを書き出したのにリンクし損ねる生成側と、クロスリファレンスデータを走査によって再構築せざるを得なかった破損ファイルです。走査は、何からも参照されないオブジェクト定義を拾い上げることがあります。推定合計の大きな割合が到達不能ノードに沈んでいる場合は、さらにリビジョンを追記するよりもファイルをクリーンに書き直す方が有利で、遅い保存を正当化するためのバイト数をグラフが提示してくれます
メモリを抱えているのはパーサーではないか
ドキュメントを疑う前に、ロード処理自体がどう振る舞ったかを確認してください。内容ではなくパーサーを記述する呼び出しが2つあり、どちらもLoadFromFileかLoadFromStreamの開始時にリセットされるため、常に直近のロードについての値になります
GetLastParserArenaStatisticsは、パース中の短命なトークンとバッファを保持するブロックアリーナについて、THPDFParserArenaStatisticsレコードを埋めます。ブロックは64 KiB(BlockSize)で、ブロックより大きい確保要求にはそのサイズ専用のブロックが割り当てられます。AllocationCountからReusedAllocationCountを引いた値がBlockAllocationCount、つまりアリーナがメモリマネージャに新しいブロックを要求せざるを得なかった回数です。ブロックはTHotPDFインスタンスの生存期間中保持され、破棄時に解放されます。1つのインスタンスでバッチ全体を処理する場合、RetainedBytesはおおよそ、そのバッチのどのファイルが必要とした最大のワーキングセットを反映します。コンポーネントを解放するまで続くメモリのプラトーはこれで説明がつきます。TemporaryObjectElisionCountは、一時的な名前オブジェクトとして構築される代わりにアリーナへ直接読み込まれた辞書キーの数を数えます
GetDocumentStringInternStatisticsは、PDF名・コンテンツストリーム演算子・短い文字列を重複排除するドキュメントごとのプールを表します。対象は1〜64バイトの文字列です。プールは最大65,536エントリと4 MiBを保持し、これらの上限はMaxStringLength、MaxEntryCount、MaxRetainedBytesとしてレコードに返ります。空の文字列、64バイトを超える文字列、プールが満杯のときに新しく来た文字列はBypassCountに数えられ、通常の文字列として保持されます。したがって、膨大な一意な名前を生成するファイルのコストは、プールなしの場合とほぼ同じで、それ以上にはなりません
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // ライブラリの呼び出しではない独自のチェック:上限に達したプールを検出する
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;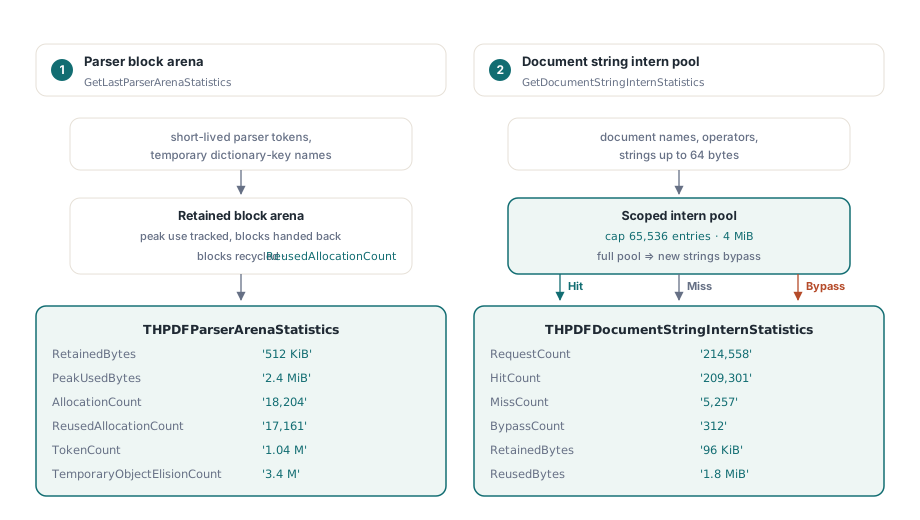
典型的なPDFは、名前と演算子の小さな語彙を繰り返すため、HitCountはRequestCountに近いところに座り、ReusedBytesはページ数とともに伸びます。中規模のファイルでBypassCountがRequestCountに迫るのは異常です。信頼できないアップロードを扱う取り込み経路では、ログに残しましょう
メモリに関する問い合わせのトリアージ順序
CatalogRetainedBytesから始めてください。プロセスで測った増加量に近ければ、メモリはドキュメントの中にあり、保持リストの上位が名前を指してくれます。大幅に下回っているなら、メモリはグラフが計測しない場所、たとえば自前のキャッシュ、レンダリング済みビットマップ、パーサーアリーナにあり、次に読むべきはアリーナの記録です
EstimatedRetainedBytesでノードをランク付けし、上位10個の入力Pathを読みます。上位にXObjectが来るのはたいていスキャン中心のコンテンツで、ダウンサンプリングが効果を発揮します。/FontFile、/FontFile2、/FontFile3が来るのは、サブセットで済むはずの場所にフルのフォントプログラムが埋め込まれている印です。大きな/Contentsストリームは、地図やCADエクスポートのような生成されたベクター出力に由来することがほとんどですTotalEstimatedBytesからCatalogRetainedBytesを引きます。大きな残りが出たらそれは取り残されたオブジェクトであり、修正は保存のステップに属します- アリーナとインターンの記録は最後に読みます。ギガバイトを説明することはめったにありませんが、すべてのドキュメントを閉じた後も大きいままのプロセスは説明してくれます
この順序で進めてください。最初のステップでほとんどの問い合わせは決着し、非常に大きなドキュメントでは、オブジェクトグラフ全体を一度に保持し続けるのをやめることが構造的な解決策になることが多く、直接ファイルAPIワークフローはまさにそのために作られています
これらの診断機能はすべて、単純なレコードを返す単純なPascal呼び出しであるため、既存のログ経路やテレメトリ経路にそのまま組み込めます。HotPDFはDelphiとC++Builder向けのフルソース付きネイティブVCL PDFコンポーネントです。APIリファレンスと評価版はHotPDF Delphi PDFコンポーネントページにあります