ユーザーが検索ボックスにMüllerと入力しても何も出ず、PDFから同じ名前をコピーしてボックスに貼り付けると、急にヒットします。両方の文字列をデバッガで確認すると、Lengthは入力したほうに6、貼り付けたほうに7を返します。入力された語は事前合成のü1つ、U+00FCを運び、ドキュメントには素のuにU+0308 COMBINING DIAERESISが続く形が保存されています。どちらも同じグリフとして描画されるのに、コードユニット比較は決して等しいと言いません
同じ見た目の文字列が等しくないと判定される理由
Unicodeは同じ抽象文字に対する複数のエンコーディングを意図的に許し、それらを正準等価と呼びます。Unicode標準附属書15は検索に関係する2つの正規形を定義します。事前合成コードポイントを好むNFCと、すべての事前合成文字を基底文字と結合記号に固定順で分解するNFDです。ダイアクリティカルマーク付きのラテン文字は両方の形で存在し、ハングル音節もそうです。1つの事前合成音節としても、2つか3つの組み合わせジャモの連なりとしても現れます
どちらの形がPDFに入り込むかは、それを生んだソフトウェア、動いたプラットフォーム、場合によってはフォントのToUnicodeマップの作られ方次第です。あるマシンで入力され別のマシンで編集されたドキュメントは、同じページに両方の形を混在させえます。検索する人にはどれも見えません。キーボードと入力メソッドはたいていNFCを生むため、ファイル内の分解済みコンテンツは、その人からは検索不能になります
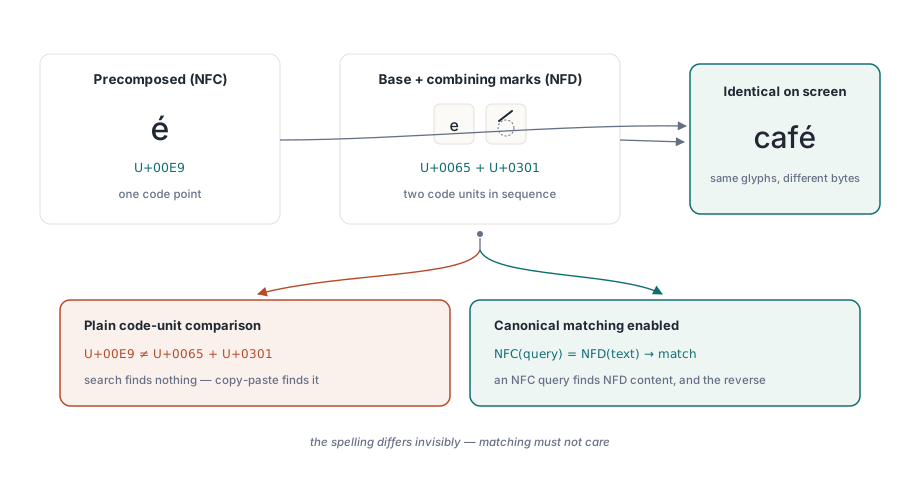
ありふれた回避策は、この問題をケースフォールディングと同じ桶へ放り込むことです。両側を小文字化し、アクセントを剥ぎ、比較する。構造的な理由でこれは壊れます。ケースフォールディングとアクセント除去はコードユニットレベルで1対1なので、折りたたみ済みテキストは元のテキストとちょうど同じ長さであり、折りたたみコピーの位置17での一致は抽出テキストの位置17での一致です。正規化は長さを変えます。事前合成の1文字が2つか3つのコードユニットになり、分解済みの並びは1つへ潰れ、ハングル音節はジャモに展開されます。その変換の後では、返ってきた位置は抽出したテキストを指さなくなります
PDF Library for DelphiでsoCanonicalEquivalentを使って検索する
PDF Library for Delphiでは、TPDFlibSearchOptionsのsoCanonicalEquivalentメンバーが、SearchTextに検索語とページテキストの正準分解を比較させます。NFCの検索語はNFDのコンテンツを見つけ、NFDの検索語はNFCのコンテンツを見つけます。このオプションは集合の一部なので、別のAPIなしでsoWholeWord、soCaseSensitive、soWildcards、soDiacriticInsensitiveと組み合わさります
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // ContextBefore / ContextAfter を満たす
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // 空のページ範囲 = 全ページ

    // Found は全ヒットを数える。コピーされたのは最初の Length(Hits) だけ
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;このループには人が躓く箇所が2つあります。SearchTextはバッファが小さくても総ヒット数を返すため、大きなドキュメントでFound - 1まで回すと500要素の配列の外を歩きます。Minでクランプするか、各ヒットをコールバックへ渡しバッファ自体を要らないSearchTextEachへ切り替えてください。そしてMatchTextは一致を含んだテキストブロック全体で、MatchStartはその中への1始まりのインデックスです。一致した語そのものは上に示したCopyになります
Bäckerを分解形で保存するファイルに対して実行すれば表示される長さは7、NFCのファイルなら6です。同じ検索語、同じオプション集合です。スライスは常に、ドキュメントに坐っているとおりのテキストです
ヒットが元のテキストのどこに着地するか
この最後の性質こそ、正規化検索をyes/no以上の何かに使えるようにするものです。PDF Library for Delphiは、正規化器が生み出すすべてのコードユニットについて、その由来である元のUTF-16範囲の開始と終了を記録します。再帰的な分解は親の範囲を引き継ぎ、合成は入力の範囲を併合し、一致が見つかると検索は写像された区間を走査して最小の開始と最大の終了を探します
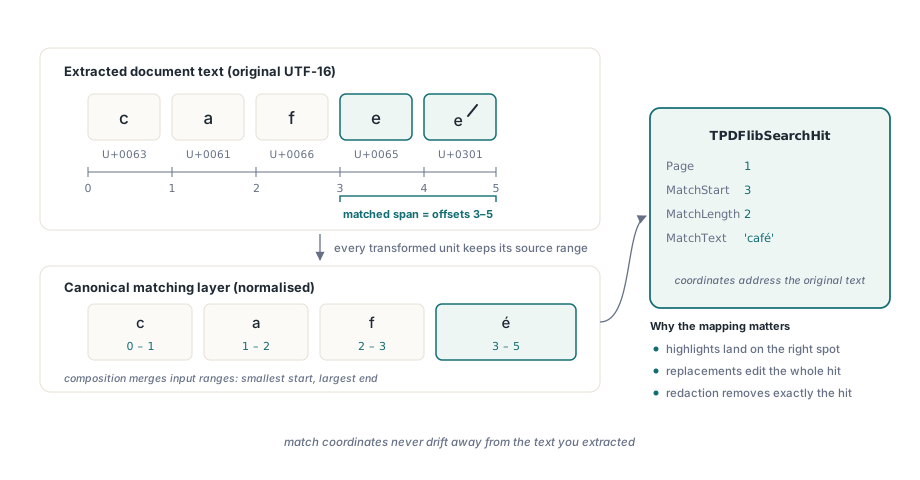
その結果、MatchStart、MatchLength、ContextBefore、ContextAfter、そして両方の置換エントリポイントは、呼び出し側が既に手にしている抽出テキストを指します。「このブロックの中にヒットがある」としか言えず、正確な場所を言えない検索は、結果カウントとしては差し支えなく、それ以外すべてにおいて間違いです。ハイライトはアクセント付き文字ごとに1、2文字ずれていき、置換は間違ったテキストの連なりを書き換えます
正規化器はライブラリに同梱です。Unicode 15.1の正準分解、合成、正準結合クラスのコンパクトなテーブルを運び、ハングルにはテーブルではなくアルゴリズムの規則を適用し、NFDの間に結合記号を安定して並べ替えます。外部データファイルはロードされず、OSの正規化呼び出しも行われないため、WindowsのサービスもLinuxのデーモンもFree Pascalビルドも、同じファイルに対して同じヒットを返します。WindowsではOSに任せることもできるのに、私たちはこの方式を好みます。あるサーバーで作られ別のサーバーで照会される検索インデックスは、2台のマシンが違うUnicodeバージョンで動いたという理由で食い違うべきではないからです
オプションはデフォルトでオフであり、そのデフォルトは妥当です。NFDテキストと位置マップの構築には時間が掛かり、ASCIIだけの請求書に対する検索には一度も要りません。soCanonicalEquivalentが設定されると、各テキストブロックは2つの変換済みコピーを保持します。結合記号ありとなしの1組で、同じブロックに対する一連の照会は正規化を1度で済ませます。素のケースフォールディングはより安い1対1の経路に留まります
ヒットが文字の途中で終わると何が壊れるか
正準等価は「これは同じテキストか」には答えますが、ヒットがどこで止まってよいかは何も言いません。分解形のcaféをsoCanonicalEquivalentだけでcafeで検索すると、最初の4コードユニットが一致し、続く結合アキュートはヒットの外に残されます。soWholeWordはこれを捉えません。単語文字は識別子の規則(ASCII文字、数字、下線)に従い、結合記号は境界と数えられるからです。ハイライトはcafeを覆い、置換は次に来るものの上に浮いた迷子のアクセントを残します
同じことはラテン文字のアクセントをはるかに越えて起こります。旗の絵文字は2つのリージョナルインジケータコードポイントです。家族の絵文字はゼロ幅接合子で繋がれた複数の人物です。デーヴァナーガリーの結合子は子音、ビラーマ、もう1つの子音であり、ベトナム語の母音は2つの記号を積みえます。基本多言語面の外のものはすべてUTF-16ではサロゲートペアで、真ん中で切ると多くのテキストパイプラインがU+FFFDに置き換えるペアなしサロゲートが生まれます
soGraphemeClustersは、リテラルかワイルドカードかにかかわらず、すべてのヒットの両端がUnicode標準附属書29の定義する拡張書記素クラスタ境界に落ちることを要求します。セグメンテーションはCR/LFのペアリング、制御文字、ハングル音節型、ExtendとSpacingMark、Prepend、絵文字のZWJシーケンス、リージョナルインジケータのペア、インド系の結合中断をカバーし、サロゲートペアの中に境界を置きません。このフラグが付くと、cafeは分解形のcaféにまったく一致しなくなります。アクセントを無視する一致が本当に欲しいものならsoDiacriticInsensitiveを足してください
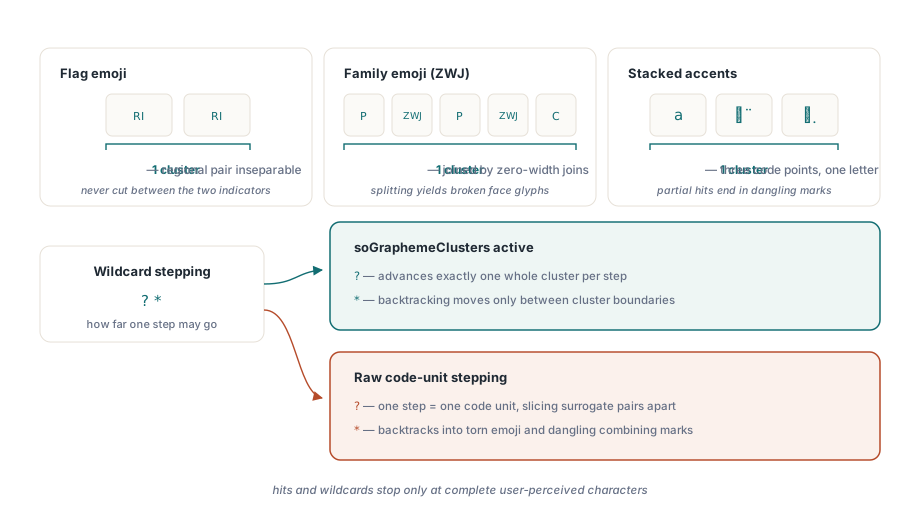
ワイルドカードこそ、このフラグが最も分かりやすく結果を変える場所です。soCanonicalEquivalentの下ではページテキストはNFDで比較されるため、côtéはファイルにどう保存されていようとc o U+0302 t e U+0301になります。soGraphemeClustersなしでは、c?téの?はちょうど1コードユニット、つまりoを消費し、それからtを期待してU+0302を見つけます。ヒットなし。フラグありでは、?はクラスタ1つぶん進み、*のバックトラッキングもクラスタ境界の間でだけ動きます
// 「?」はユーザーが知覚する 1 文字ぶん進む。だからこれは côté に一致する
// PDF が事前合成で保存していようが分解形で保存していようが
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// 置換は同じクラスタ安全な範囲を使うため、絵文字を割ったり
// 迷子のアクセントを残したりすることはない
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
Lib.SaveToFile('contracts-edited.pdf');SearchAndReplaceTextInContentはページコンテンツ内のテキストを書き換え、置換した一致数を返します。ゼロを返したとき、GetLastUnicodeReplacementDiagnosticsが理由を語ります。たとえば、一致がそれを描画したコンテンツへ写像できなかったといった具合です。もう1つの入口、SearchAndReplaceTextは同じオプション集合を受け付け、代わりに一致したブロックの上へ置換を描画します
仕事ごとのオプション集合の選び方
3つの組み合わせがほとんどのアプリケーションをカバーします。ドキュメントビューア内のエンドユーザー検索ボックスには、soCanonicalEquivalentにsoDiacriticInsensitiveを足します。両方のエンコード形が一致し、アクセント付きと無しの綴りも一致します。長年ウェブ検索に慣れた人が期待する挙動です。誤検知1つで誰かの午後が消える法務やコンプライアンスのレビューには、soCanonicalEquivalentにsoCaseSensitiveとsoWholeWordを組み、アクセントの折りたたみはオフのままにします。等価性はファイルがたまたま選んだエンコードの仕方を無視しながら、厳密に保たれます
ドキュメントを変える何かに取り掛かるなら、soGraphemeClustersは毎回足してください。私たちが好みに任せないと申し上げるのはここ1箇所です。1コードユニット足りない範囲を返す検索は、結果を読む人を惑わすだけですみます。同じ範囲を使う置換や削除は、その間違いをファイルに書き込みます。ページが印刷されるか再抽出されるまで誰も気付きません。内容を覆うのではなく破壊しなければならない削除はそれ自体が話題で、本物の墨消しとコンテンツ削除で扱います
複数の語を同じドキュメントへ掛けるときは、SearchTextBatchが有利です。ページのテキストブロックがメモリに居る間にすべての空でない照会を評価するため、各ページは1度だけ抽出され、各ブロックは1度だけ正規化され、照会ごとに独自のオプション集合を運べます
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // ハングル。ファイルには NFC またはジャモで
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;ヒットはページ、ブロック、照会の順で返り、QueryIndexは渡した配列の中のゼロ始まりの位置です。前もってサイズを決められない結果集合には、コールバック形式のSearchTextBatchEachがあります。テキストブロックがそもそもどう抽出されるかは、テキスト検索とページ要素の列挙に述べられています
正準等価が選択肢にならないスクリプト
韓国語では、正準等価が名前が見つかるかどうか自体を決めます。事前合成の音節と分解されたジャモの両方が実文書に現れるからです。ベトナム語は、すでにブレーベやサーカムフレックスを運んでいるかもしれない母音の上にさらにトーン記号を積むため、合成形は完全にプロデューサ次第です。デーヴァナーガリー、ベンガル語、他のインド系文字では、結合の規則がヒットの境界を、読み手が認識できる場所に落とすかどうか決めます。日本語と中国語は検索の面では比較的容易です。レイアウトの面はそうではなく、日本語と中国語の縦書きで扱います
私たちの推奨は率直です。コーパスに英語以外の言語が1つでも含まれるなら、まずsoCanonicalEquivalentをオンにし、自分のドキュメントで時間を計り、コストが受け入れられないと分かった後にだけ切ってください。このオプションが防ぐ失敗は、まさにユーザーが最もよく検索する名前の上に落ちてきます
同じUnicode対応エンジンが、Delphi、C++Builder、Free Pascalから検索、抽出、置換、墨消しを駆動します。オプション集合、バッチAPI、テキストツールキットの残りは、PDF Library for Delphi製品ページに一覧があります