PDF Library for Delphiは、DeduplicateSimilarImagesによって、見た目は同じでもバイト単位では同一でないPDF内の画像を統合できる。完全な重複排除は、辞書とエンコード済みペイロードが一致する画像のみを統合するが、この機能は知覚ハッシュと2つのピクセル誤差閾値を用いて画像が実際にどう見えるかを比較し、すべての参照を1つの正規オブジェクトへリダイレクトする
これが効果を発揮するファイルは、意図せず肥大化したファイルである。スキャンされたバッチで、各ページに異なるスキャナーによって再エンコードされた同じロゴが含まれている場合。それぞれがわずかに異なるJPEG品質で同じチャートを埋め込んだ複数のソースから組み立てられたレポート。2つのツールによってサムネイルが再生成されたカタログ。いずれの場合も、ファイルには1枚の画像の多数のコピーが含まれ、完全な重複排除ではそのどれにも手が届かない
「十分に似ている」が意味しなければならないこと
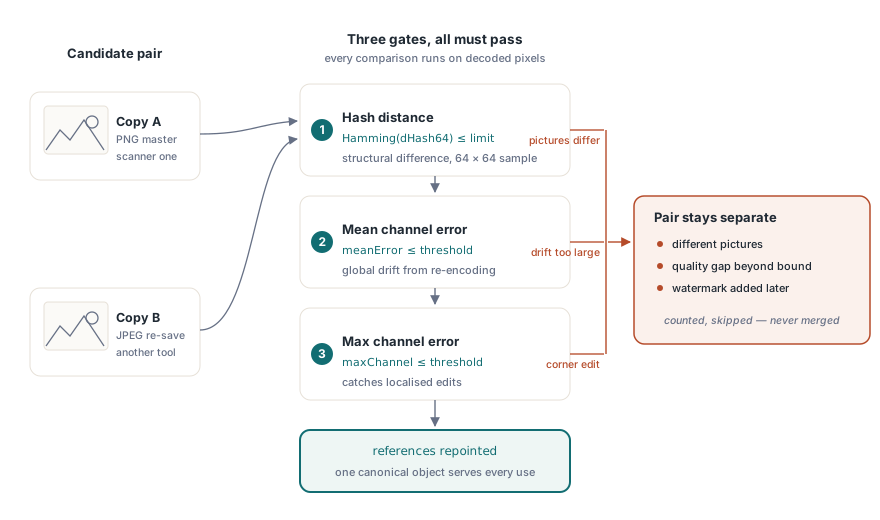
2つの画像を統合する前に3つの閾値すべてが満たされなければならず、それぞれが異なる種類の差異を捕捉する。知覚ハッシュ距離は構造的な差異を制限する:デコードされた画像の64×64サンプルから64ビットの差分ハッシュが計算され、許容されるハミング距離は0から7の範囲である。平均チャンネル誤差は全体的なドリフトを制限し、これは再エンコードによって生じるものである。単一チャンネルの最大誤差は局所的な差異を制限し、これは小さな編集によって生じるものである
この3つすべてを要求することが、この統合を正当化できるものにしている。片隅に透かしが入っているだけで異なる画像は、平均誤差は低いが最大誤差は高いため、最大誤差のゲートによって却下される。再圧縮された画像はどこでも小さな誤差しか持たないため、通過する。これはまさに、サイズ最適化ツールが引くべき区別である
uses
  PDFlibrary;

var
  Lib: TPDFlib;
  Stats: TPDFlibImageSimilarityDedupStats;
  Merged: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('scanned-batch.pdf', '');

    // Hash distance 2, mean error 2, single-channel error 4.
    // Optionsでdry runを指定でき、何も変更しない
    Merged := Lib.DeduplicateSimilarImages(2, 2, 4, 0, Stats);
    if Merged < 0 then
      raise Exception.Create('deduplication failed');

    Log(Format('%d scanned, %d merged, %d refs repointed, %d bytes duplicated',
      [Stats.ImagesScanned, Stats.ImagesDeduplicated,
       Stats.ReferencesRepointed, Stats.DuplicatePayloadBytes]));
    Log(Format('worst accepted: hash %d, mean %.2f, channel %d',
      [Stats.MaxAcceptedHashDistance, Stats.MaxAcceptedMeanError,
       Stats.MaxAcceptedChannelError]));
    Lib.SaveToFile('scanned-batch-optimised.pdf');
  finally
    Lib.Free;
  end;
end;
意味的な同一性は視覚的な類似性より先に来る
ピクセルを比較する前に、候補となる画像は意味的に一致していなければならない。ライブラリは/Length、/Filter、/DecodeParmsを除いた画像辞書全体から安定した署名を構築するため、寸法、色空間、ビット深度、マスク、/Decode配列、補間、オプショナルコンテンツの所属、メタデータがすべて一致していなければならない
この順序が、誤った統合の1つの類型全体を防いでいる。2つの画像は64×64サンプルでは同一に見えても、ページ上では異なる振る舞いをすることがある:/Interpolateがtrueの画像とそうでない画像は拡大縮小時に異なる平滑化のされ方をし、オプショナルコンテンツグループに属する画像はそのレイヤーが非表示になると消える。こうした境界をまたいで統合すると、小さくはなるが誤ったドキュメントが生まれる
スキャンされるのは間接画像XObjectのみである。インライン画像は異なる経済性を持つ別の構造であり、デコードできない画像は、根拠なく統合されるのではなく保守的にスキップされカウントされる——ピクセルの裏付けがなければ統合もない
探索を安価に保つ方法
すべての画像を他のすべての画像と比較することは二次的なコストであり、数千枚の画像を含むドキュメントでは許容できない。そのためハッシュは8つの8ビットバンドに分割され、それぞれに順序付きインデックスが用意される
鳩の巣原理が残りを解決する:2つのハッシュが最大7ビットしか異ならない場合、8つのバンドのうち少なくとも1つでは完全に一致していなければならない。したがってバンドごとに候補を検索すれば、網羅的なペアワイズスキャンなしにすべての許容可能な一致を見つけられる。公表されている上限7は、まさにこの保証がその距離までしか成り立たないために存在する
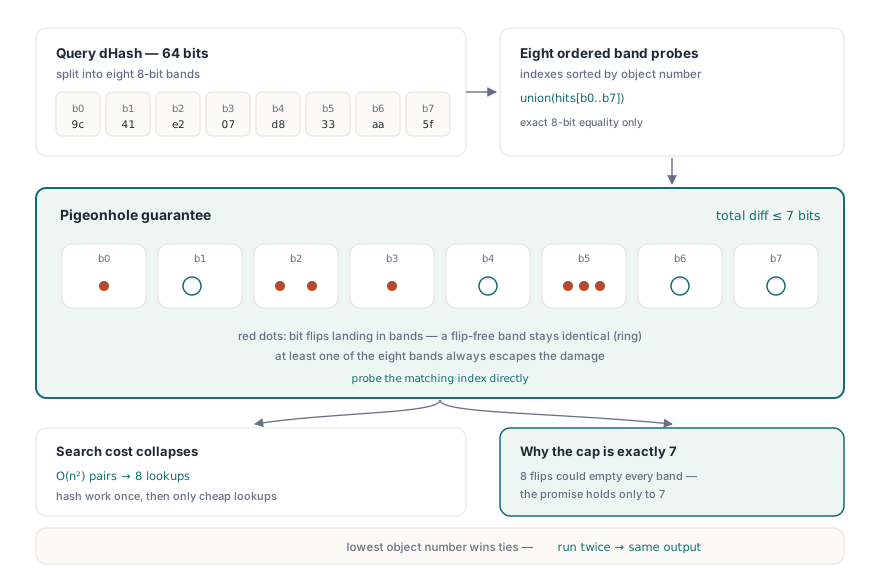
候補とバンドのヒットはオブジェクト番号と世代番号によって決定的に順序付けられ、最も小さいオブジェクト番号が正規のものになる。これにより出力は再現可能になる:同じ入力に対して最適化ツールを2回実行しても同じ正規の選択が得られ、これは結果を比較したり署名したりする際に重要になる
ドライランと正直な報告
統合される画像が同一ではなかったという意味でこれは非可逆的な最適化であるため、賢明なワークフローは飛び込む前に見ることである。ドライランオプションは、オブジェクトグラフを変更することなく何が統合されるか、どれだけのペイロードが回収されるかを報告するため、バッチジョブはその効果をログに記録でき、人間はファイルごとにではなく一度だけ閾値を承認すればよい
報告における正直さに関する注意点が2つある。回収可能量の数値は重複ストリームのエンコード済みペイロードのみを見積もっており、辞書、間接オブジェクト、相互参照のオーバーヘッドはカウントしないため、実際のファイルサイズ削減量は報告値より小さくなるのではなくやや大きくなる。そしてレポートは受理された最大誤差と比較作業量を公開するため、統合が閾値にどれだけ近づいたかを確認できる
固定の64×64サンプリンググリッドは意図的な近似であり、これには明確に述べておく価値のある帰結がある:1サンプルセルより小さい差異は、閾値がゼロであっても見逃される可能性がある。スキャンされたページ内の1単語だけの変更は、そのサンプリングを生き延びない可能性がある。バイトレベルの証明が必要な場合は、代わりに完全な重複排除経路を使うこと——それは真に同一のリソースのみを統合し、視覚的な判断を一切行わない
サイズ削減パイプラインのどこに位置づけるか
パスはリスクの順に並べること。まず完全なリソースの重複排除を実行する。これは無損失で無償である。次にフォントのサブセット化を行う。これも無損失であり、通常テキストの多いドキュメントでは単独で最大の効果を持つ。これはPDFファイルサイズの最適化とフォントのサブセット化で扱われている。次にターゲットの媒体が許すなら画像の再圧縮やダウンサンプリングを行う。知覚的な重複排除はそれらの後に位置づけられる。なぜならそれは結果が判断に依存する唯一のステップだからである
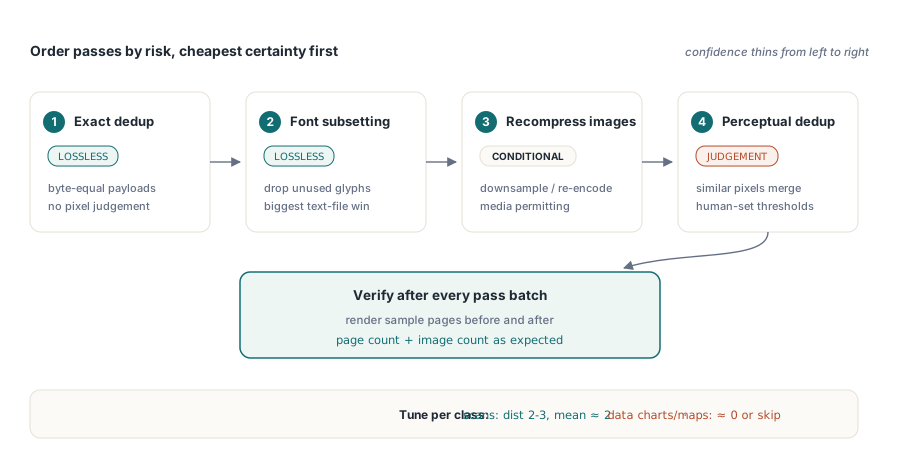
閾値は一律にではなくドキュメントの種類ごとに選ぶこと。すべてのページに同じレターヘッドが含まれるスキャンバッチでは、平均誤差約2を伴うハッシュ距離2から3がレターヘッドを確実に統合する。チャート、地図、医用画像のようにデータを運ぶ画像を含むドキュメントでは、ゼロまたはゼロに近い閾値を使うか、このパス自体をスキップすること。プロットされた1点だけが異なる2つのチャートは、64×64でどれだけ似て見えても2つの異なるチャートだからである
最適化後は検証すること。最適化前後のページのサンプルをレンダリングして比較し、ページ数と画像数が期待通りに変化したかを確認すること。ドキュメントが実際に何を含んでいるかを調べる経路についてはカテゴリ別のPDFファイルサイズ監査で説明されており、これはそもそも画像が問題なのかどうかを見極める最速の方法でもある
知覚的重複排除、完全なリソース重複排除、サイズ監査は、Delphi、C++Builder、Free Pascal向けの同じオブジェクトグラフ上で動作する。機能一覧の全体はPDF Library for Delphiページにある