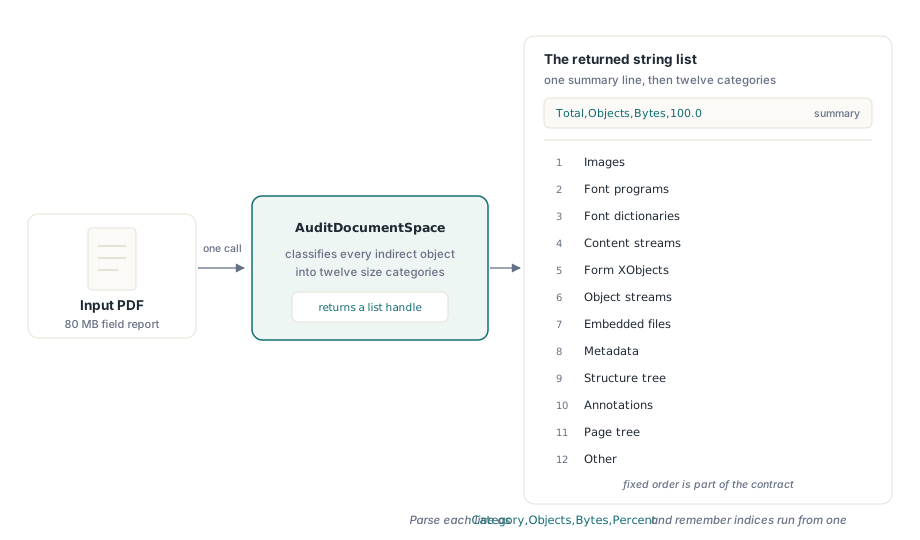
PDFファイルサイズが実際どこに消えているかを知るために、losLab PDF LibraryはAuditDocumentSpaceを公開している。これはすべての間接オブジェクトを12のカテゴリ——画像、フォントプログラム、フォント辞書、コンテンツストリーム、フォームXObject、オブジェクトストリーム、埋め込みファイル、メタデータ、構造ツリー、注釈、ページツリー、その他——に分類し、それぞれのオブジェクト数、格納バイト数、割合を報告する
これが存在する状況にはおなじみのものがある。40ページのレポートがジェネレーターから80MBで出てきて、顧客がなぜかと尋ね、あなたにできるのは推測だけだ。おそらく画像だろう。もしかするとフォントかもしれない。そこでダウンサンプリングを有効にして出荷すると、ファイルは74MBになる——本当の重さは全く別のところにあったのだ。フォントのサブセット化と画像のダウンサンプリングに関する併載記事はPDFを縮小する方法を扱っているが、この記事はまず先に行うべきステップ、つまりこれから縮小しようとしているものを測定することを扱う
なぜ圧縮の前に測定するのか
3つの標準的な最適化パスは、対象のファイルによって見返りが大きく異なり、数えてみるまでどれが該当するかはファイルの何を見ても分からないからだ。フォントがすでにバイト数の2%しかないドキュメントでフォントをサブセット化するのは、丸め誤差を動かすのに午後いっぱいを費やすようなものだ。かさの中身が非圧縮のコンテンツストリームであるファイルで画像をダウンサンプリングしても、同じような失望を生む。最適化処理そのものは難しい部分ではない——どのライブラリも持っている。どの最適化処理をこのファイルに向けるべきかを知ることが難しい部分であり、それは圧縮の問題ではなく会計の問題だ。監査はまた、最適化処理そのものが答えでないケースも捕らえる:ファイルの60%が埋め込み添付ファイルだと判明した場合、それに必要なのはより良い圧縮ではなく、その添付ファイルがそのドキュメントに属すべきかどうかについての会話であり、ファイルの30%が構造ツリーであれば、それはアクセシビリティタグ付けのコストを払っているのであり、通常は意図的なコストなので黙って取り除くべきではない。バイト数が帰属されれば、手近にあるどのスイッチにでも飛びつくのではなく、数字に裏付けられた製品判断を下せるようになる
12カテゴリのレポートに含まれるもの
AuditDocumentSpaceはレコードではなく文字列リストハンドルを返すので、そのレポートはフラットDLLやCOMファサードを越えても変わらずに生き残る。リストにはTotal,Objects,Bytes,100.0のサマリー行に続いて、契約の一部である固定順序で正確に12個のCategory,Objects,Bytes,Percent行が含まれる:Images、Font programs、Font dictionaries、Content streams、Form XObjects、Object streams、Embedded files、Metadata、Structure tree、Annotations、Page tree、Other。カテゴリが空であっても、常に13行だ
var
  Lib: TPDFlib;
  ListID, I: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    ListID := Lib.AuditDocumentSpace;   // ドキュメントが選択されていない場合は 0
    if ListID = 0 then
      Exit;
    try
      // GetStringListItem は 1 始まり: 項目は 1..GetStringListCount を渡る
      for I := 1 to Lib.GetStringListCount(ListID) do
        Memo1.Lines.Add(Lib.GetStringListItem(ListID, I));
    finally
      Lib.ReleaseStringList(ListID);
    end;
  finally
    Lib.Free;
  end;
end;そのループにあるDelphiの細部が、一度だけあなたを噛むだろう。GetStringListItemはGetStringListCountと揃った1始まりの項目インデックスを使っており、範囲外のインデックスは例外を発生させず空文字列を返す。習慣でfor I := 0 to Count - 1とループを書くと、先頭に空行ができ、最後の行が黙って落ち、それが間違っていることを教えてくれる例外もどこにも出てこない。レポート自体はほぼ正しく見えてしまい、それは診断ツールにとって最悪の失敗モードだ
なぜ監査はデコード済みサイズではなく格納長を使うのか
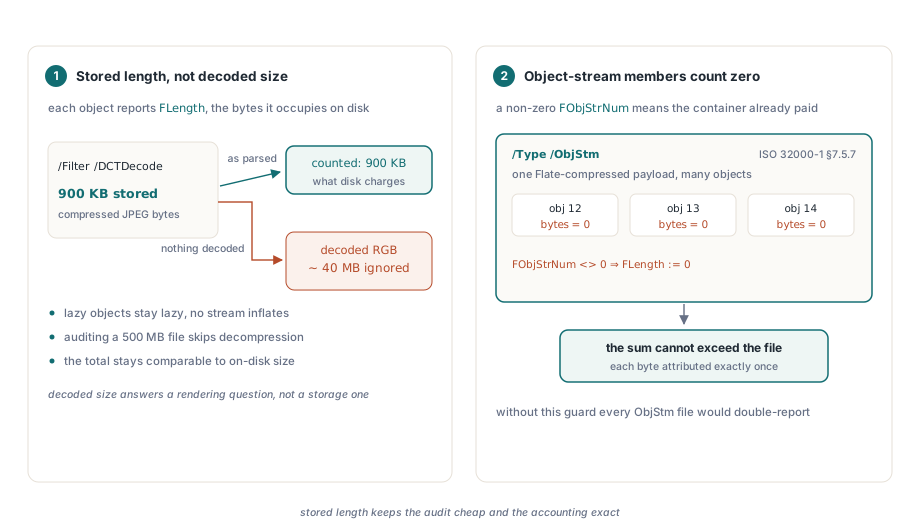
格納長は求めている数値であり、かつ取得が安価な数値でもあるからだ。各間接オブジェクトはTPDFIndObj.FLengthを保持しており、それはパース時にオブジェクトがファイル内で占める生バイト長だ。これを使うということは、900KBのDCTDecode画像がデコードされる40MBのRGBサンプルではなく、ディスク上でかかっているコスト、つまり900KBとして報告されることを意味する。それはまた、監査が何もデコードする必要がないことも意味する:遅延読み込みされたオブジェクトは遅延したままで、フィルターは実行されず、500MBファイルの監査はオブジェクトヘッダーを1パスなぞるだけであり、フル解凍サイクルにはならない
2 つ目のルールは二重計上の防御だ。オブジェクトが圧縮されたオブジェクトストリームの中に住んでいる場合、それは非ゼロの FObjStrNum で示されるが、そのバイト数は 0 として記録される。その格納域は、コンテナストリームがすでに一度払っている。ISO 32000-1 §7.5.7 はそれを、多数のオブジェクトを 1 つの Flate 圧縮ペイロードに収める /Type /ObjStm ストリームとして定義している。各メンバーにそれぞれの取り分を請求し、そのうえでコンテナにもう一度請求すれば、合計は実際のファイルサイズを突き抜けて膨らむ。これは出力の読み方に直接的な帰結をもたらす。下記と、オブジェクトストリームとクロスリファレンスストリームに関する記事でより深く扱っている
なぜフォントプログラムは自分自身を分類できないのか
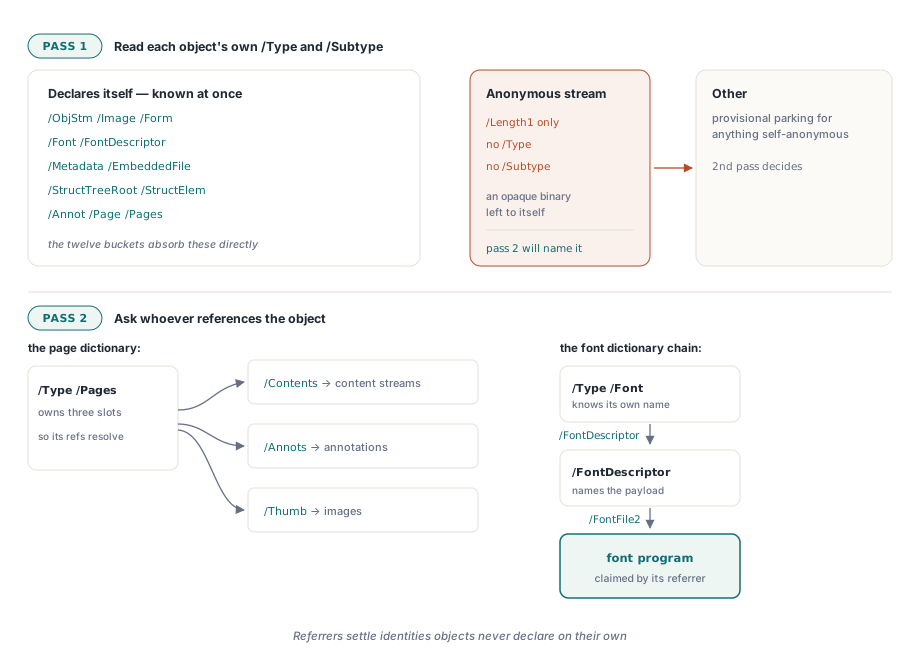
PDFに埋め込まれたTrueTypeフォントファイルには、そうであると示すマーカーがないからだ。ISO 32000-1 §9.8.1は、埋め込みフォントプログラムをフォントディスクリプタの/FontFile、/FontFile2、または/FontFile3の値として定義しているが、その参照の先にあるストリーム辞書は/Length1とフィルターキーは持っていても、それをフォントとして識別する/Typeも/Subtypeも持っていない。単独で見れば、それは匿名のバイナリストリームだ。それを指しているディスクリプタだけが、それが何であるかを知っている。同じ非対称性は注釈にも見られる:§12.5.2は注釈辞書における/Type /Annotを任意にしているので、信頼できる信号はページの/Annots配列のメンバーであることであって、辞書そのものではない
そのため分類は2回実行される。1回目のパスは各オブジェクト自身の/Typeと/Subtypeを読み取り、簡単に取れる勝ち筋を取る:/ObjStm、/Subtype /Image、/Subtype /Form、/Type /Fontと/Type /FontDescriptor、/Metadata、/EmbeddedFileと/Filespec、/StructTreeRootと/StructElem、/Annot、/Pageと/Pagesだ。それ以外はすべて暫定的にOtherに入る。2回目のパスは参照する側を歩き、上書きする:各ページ辞書はその/Contentsをコンテンツストリームに、/Annotsのエントリを注釈に、/Thumbを画像に再割り当てし、各フォント辞書は自身のディスクリプタチェーンを歩く
// 2 回目のパスの形: 参照側がオブジェクトを分類する
Descriptor := DictOf(FontDict.FindValueByKeyName('FontDescriptor'));
if Assigned(Descriptor) then
begin
  MarkRef(FontDict.FindValueByKeyName('FontDescriptor'), catFontDicts);
  MarkRef(Descriptor.FindValueByKeyName('FontFile'),  catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile2'), catFontPrograms);
  MarkRef(Descriptor.FindValueByKeyName('FontFile3'), catFontPrograms);
end;
// Type0 フォントは記述子を一段下に保持する
Descendants := FontDict.FindValueByKeyName('DescendantFonts', True);
if (Descendants is TPDFArray) and (TPDFArray(Descendants).Count > 0) then
  MarkFontProgramRefs(DictOf(TPDFArray(Descendants).Item[0]));
レポートを読み、次の一手を選ぶ
まず割合を読み、次にオブジェクト数を読み、その両者の間に大きな乖離があればそれを信号として扱おう。現代のPDFはほとんどの小さな辞書をオブジェクトストリームの中に入れているので、Page treeとStructure treeは決まってバイト数がほぼゼロなのにオブジェクト数が数十というかたちで現れる——実際のコストはObject streamsの行に折り込まれている。Object streams自体が大きい場合、そのファイルはコンテンツよりもメタデータ的な構造で密になっており、有効な手段は圧縮ではなくオブジェクトの刈り込みだ。注釈の外観ストリームも同様の振る舞いをする:/Subtype /Formを持つので、大量にスタンプされたドキュメントはその重さをForm XObjectsの下に見せ、Annotationsの行は小さいままになる
function CategoryShare(Lib: TPDFlib; ListID: Integer;
  const Category: string): Double;
var
  I: Integer;
  Parts: TArray<string>;
  Inv: TFormatSettings;
begin
  Result := 0;
  Inv := FormatSettings;
  Inv.DecimalSeparator := '.';   // レポートはロケール非依存
  for I := 2 to Lib.GetStringListCount(ListID) do   // 1 行目は Total
  begin
    Parts := string(Lib.GetStringListItem(ListID, I)).Split([',']);
    if (Length(Parts) = 4) and SameText(Parts[0], Category) then
      Exit(StrToFloatDef(Parts[3], 0, Inv));
  end;
end;表示するのではなくパーセンテージをパースするなら、書式に関する2つの事実が重要になる。小数点区切りはマシンのロケールにかかわらず常にリテラルなピリオドなので、ドイツ語やフランス語のワークステーションで周囲のFormatSettingsを使ってパースすると失敗するか、さらに悪いことに誤読される。そして末尾のゼロは切り詰められるので、ちょうど40%のバイトを保持するカテゴリは40と表示され40.0とはならない——固定された小数桁数を想定してはいけない。割合が手元にあれば、対応はほぼ機械的だ:Imagesが支配的な割合を占めていればDownsampleImagesを、Font programsが支配的ならSubsetEmbeddedFontsを、Content streamsがかさばっていればCompressContentを指し示す
監査が意図的に教えてくれないこと
合計は間接オブジェクトの総和であり、PDF ファイルはオブジェクトの総和よりほんの少し大きい。ファイルヘッダー、トレーラー、オブジェクト間の空白、古い形式のクロスリファレンステーブルは間接オブジェクトではないため、これらのバイトはどこにも帰属せず、監査の合計はディスク上のサイズより少し小さくなる。クロスリファレンスストリームは違う。それは /Type /XRef を持つ本物のオブジェクトなので、現代的なファイルではそれらのバイトは Other カテゴリに現れる。どちらの挙動も間接オブジェクトを数えることから帰結する。したがって監査をファイルシステムのバイト数と突き合わせるなら、その差はここから来ている
もう 2 つの境界は率直に述べておく価値がある。第 1 に、これらの数値はロードされたファイルを記述するものであり、作成中のファイルではない。まだ格納長を持たないメモリ上で構築されたオブジェクトについては、サイズはストリーム辞書のための名目上の枠を加えたシリアライズ済み出力へフォールバックする。これは測定ではなく最終的な書き出しの推定だ。正確な数値が欲しいなら、保存と再ロードの後に監査する。第 2 に、太った Other の行はそれ自体が一つの発見だ。通常それは、何からも参照されなくなった孤児オブジェクトを意味し、それはどの圧縮パスの仕事でもなく、マークアンドスイープのガベージコレクションの仕事だ
この方法で使うと、監査は会話の形を変える。80MBのレポートを推測する代わりに、それを開き、1回呼び出して、画像が8%、フォントプログラムが61%、そのドキュメントは3書体しか使わないハウススタイルのために9個の完全なフォントプログラムを埋め込んでいることを読む。それは数字が付いた修正可能な答えだ。AuditDocumentSpaceは、それが指し示す最適化パスとともに、Delphi・C++Builder向けlosLab PDF Libraryに付属しており、リファレンスページには完全なカテゴリ一覧とその周辺の文字列リストAPIが文書化されている