手書きの JBIG2 リーダーが、最初の変わったファイルで踏む間違いがあります。ファイルヘッダーを解析し、最初のセグメントヘッダーを解析し、4バイトのデータ長を読み、そのバイト数をセグメント本体として扱うのです。ほとんどの .jb2 ファイルではそれが正確に正しい。しかしフラグバイトのビット0が立っていないファイルでは、その「本体」バイトは実は2番目、3番目、4番目のセグメントヘッダーであり、算術デコーダーはそれをノイズのビットマップへ変えるか、バッファの末尾を突き抜けます。ファイルは壊れていません。ITU-T T.88 附属書 D.2 のランダムアクセス構成を使っているのです。すべてのセグメントヘッダーが先に来て、すべてのセグメントデータが同じ順序で後に続きます
ランダムアクセスファイルは珍しいものです。圧縮バイトに触れる前に、リーダーにすべてのページと辞書の依存関係を見せたいアーカイブや文書イメージングシステムから出てきます。変換ジョブがそのようなソースのファイルと普通のスキャンを混ぜると、シーケンシャルばかりのバッチの途中に、1つのランダムアクセスファイルが紛れ込むことがあります。これを読むデコーダーは、JBIG2 のカスタム Huffman テーブルと正準プレフィックスコードを扱うのと同じネイティブ Pascal デコーダーなので、符号化の側は変わらず、セグメントの見つかり方の順序だけが違います
1つのフラグバイトの背後にある3つのファイルレイアウト
PDF Library for Delphi は、PDFlibJBIG2 ユニットの TPLJBIG2Decoder を通してスタンドアロンの JBIG2 ファイルを読み、デコーダーはレイアウトをファイルヘッダーから自分で判断します。T.88 附属書 D は、同じセグメント群に3つの並べ方を許します。シーケンシャル(D.1)は各ヘッダーをそのデータの直前に置き、ランダムアクセス(D.2)はすべてのヘッダーを先に、すべてのデータを後に置き、embedded(D.3)は他のコンテナの内側で使われるヘッダーなしの形式です。スタンドアロンファイルは8バイトの識別子 97 4A 42 32 0D 0A 1A 0A で始まり、続いてフラグ1バイト、そしてフラグがページ数既知と言うなら4バイトのページ数が続きます
このフラグバイトのビット0が構成を選びます。1はシーケンシャル、0はランダムアクセスです。ビット1が立っているとページ数は不明で4バイトのカウントは存在せず、最初のセグメントヘッダーはバイト13ではなくバイト9から始まります。ビット2から7は予約済みですが、デコーダーはそれらを拒否ではなく受け入れます。迷い込んだ予約ビットは、セグメントそのものが読めるかどうかを何も語らないからです
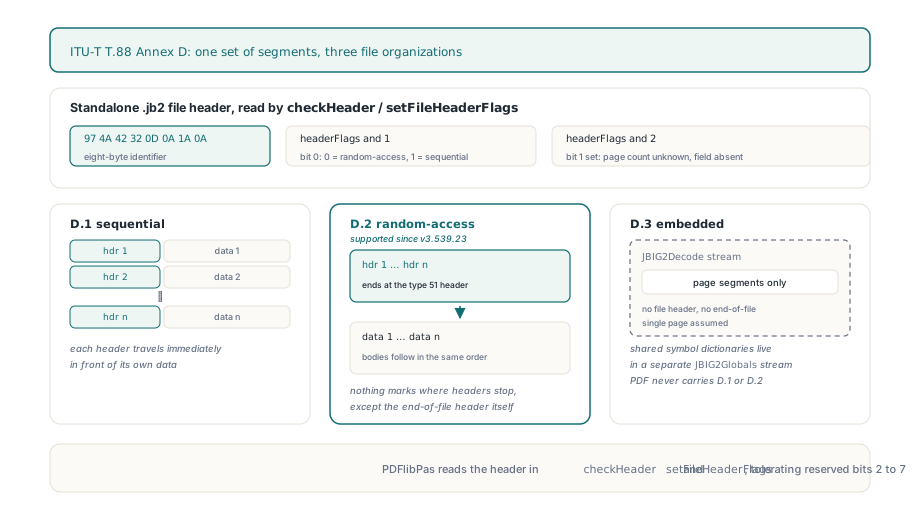
PDF 自身がランダムアクセスのレイアウトを運ぶことはありません。ISO 32000-1 §7.4.7 に記述される JBIG2Decode 画像ストリームは、embedded 形式のページセグメントだけを保持し、共有シンボル辞書は別の JBIG2Globals ストリームへ移され、ファイルヘッダーや end-of-page、end-of-file セグメントは持ちません。デコーダーが8バイトの識別子を見つけられないときは、入力をまさにその種類のストリームとして扱います。シーケンシャル、1ページです。逆方向では、PDF Library for Delphi が JBIG2Decode 画像をネイティブの .jb2 ファイルとして書き出すとき、フラグバイト $03(シーケンシャル、ページ数不明)を書き、end-of-file セグメントヘッダーを追加します。つまりランダムアクセスがやってくるのは常に外側から、TPLJBIG2Decoder へ直接渡されるスタンドアロンファイルとしてです。たいていは、PDFlibPas の JBIG2 エンコーダーバックエンドによる PDF 向けの変換や再圧縮の途中に
ランダムアクセスファイルをファイル順に読めないのはなぜか
end-of-file セグメントヘッダー(タイプ51)そのもの以外に、ヘッダーブロックがどこで終わりデータブロックがどこで始まるかを示すものが、バイトストリームのどこにもないからです。JBIG2 のセグメントヘッダーには固定サイズがありません。参照セグメント数は3ビットの短形式か、リテンションビットマップの付いた長形式かのどちらかです。各参照セグメント番号は、現在のセグメント自身の番号の大きさに応じて1、2、4バイトのいずれかになります。ページ関連付けフィールドは1バイトか4バイトです。次のヘッダーがどこから始まるかを知るだけでも、リーダーはヘッダーのすべてのフィールドをパースしなければなりません
ファイル順に歩くシーケンシャルリーダーは、最初のヘッダーは正しく、その後のすべてを間違えます。もっと悪いことに、しばらく気づかないかもしれません。ヘッダーバイトを与えられたジェネリックリージョンデコーダーは、後のどこかで長さや参照の検査がようやく引っかかるまで、エラーではなくピクセルを出し続けるからです。私たちの見解では、ヘッダーを最初に索引しないデコーダーは、ランダムアクセスファイルをまっこうから拒否すべきです。はっきりした拒否のコストはバッチ内の1ファイルですが、もっともらしく見えて間違ったビットマップは、アーカイブに入り込み、そこに留まります
最初の本体の前に、すべてのヘッダーを索引する
フラグバイトがランダムアクセスを告げているとき、PDF Library for Delphi は何かをデコードする前に、ヘッダーブロックを1回通して索引します。各ヘッダーは完全にパースされてから捨てられ、保持されるのはファイル内のバイトオフセットだけです。圧縮データが並べ替え用の第2バッファへコピーされることはありません。大規模なアーカイブスキャンではデータブロックがファイルの大半を占めるため、これが効いてきます。プリスキャンは最初の end-of-file ヘッダーで止まり、その時点で読み出し位置は最初のセグメントのデータの先頭バイトに乗っています
ランダムアクセスファイルはシーケンシャルより冗長性が低いため、プリスキャンは厳格です。次の場合にファイルを拒否します:
- ヘッダーがバッファの末尾で切れた場合。
JBIG2 truncated random-access header at byte Nとして、そのヘッダーが始まったオフセットつきで報告されます - セグメント番号が(符号なし値として比較して)厳密に増加しない場合。同じ番号を名乗る2つのヘッダーがあると、後のリージョンの参照リストが曖昧になります
- データ長の最上位ビットが立っている場合。
0xFFFFFFFFの「unknown length」マーカーもこれに含まれます。このレイアウトでは次の本体の始まりを探す他の方法がないため、デコーダーは end マーカーを前へ探す代わりに即座に拒否します - end-of-file ヘッダーが何かデータを宣言している場合、あるいはまったく現れない場合(
JBIG2 random-access file is missing its end-of-file header) - 宣言された長さの合計が、残っているバイト数より多い場合、または少ない場合
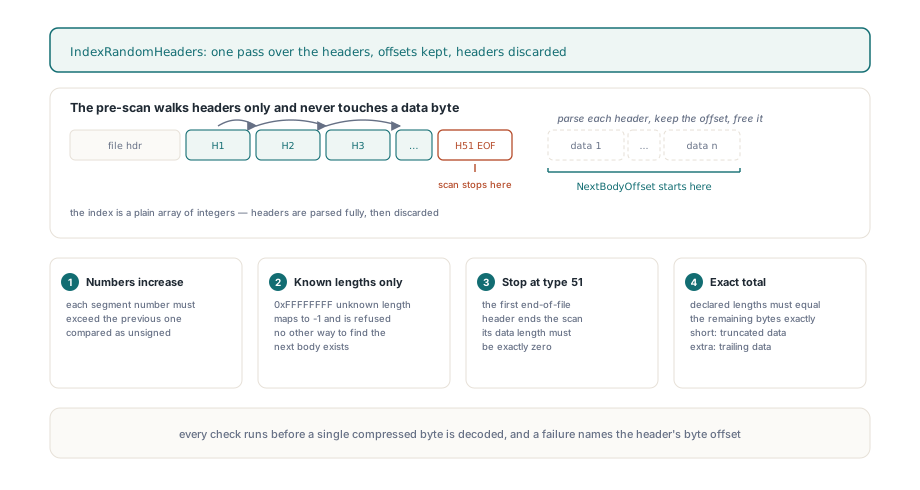
人がつまずくのは最後の規則です。最後の本体の後に余分なバイトが1つあるだけで、JBIG2 trailing random-access data で失敗します。シーケンシャルの経路と並べると厳しく見えます。あちらではデコードは end-of-file セグメントで単に止まり、その後のものは無視されるからです。非対称には理由があります。シーケンシャルのレイアウトでは各ヘッダーが自分のデータの真横に座るため、末尾のゴミは何もずらせません。ランダムアクセスのレイアウトでは、ヘッダーがデータブロックの唯一の地図であり、長さが合わないとき、デコーダーには無害なパディングと、ずっと早い時点で1バイト失われたか加えられたせいで、その後の全本体がずれているケースを見分ける手だてがありません
バイト数で数えるループは最後のend-of-pageセグメントをなぜ落とすのか
「バイトが残っているあいだ」だけ走るループは、ランダムアクセスファイルでは早すぎて終わります。データがヘッダー索引より先に尽きるからです。end-of-page(タイプ49)と end-of-file セグメントはデータをゼロバイトしか運ばず、たいてい最後に来ます。最後のリージョン本体が消費されると、読み出し位置はバッファの正確な終端にあり、バイト数で数えるループはそこで抜けます。長さゼロの end-of-page セグメントは振り分けられないまま、ページは未完成のまま残ります
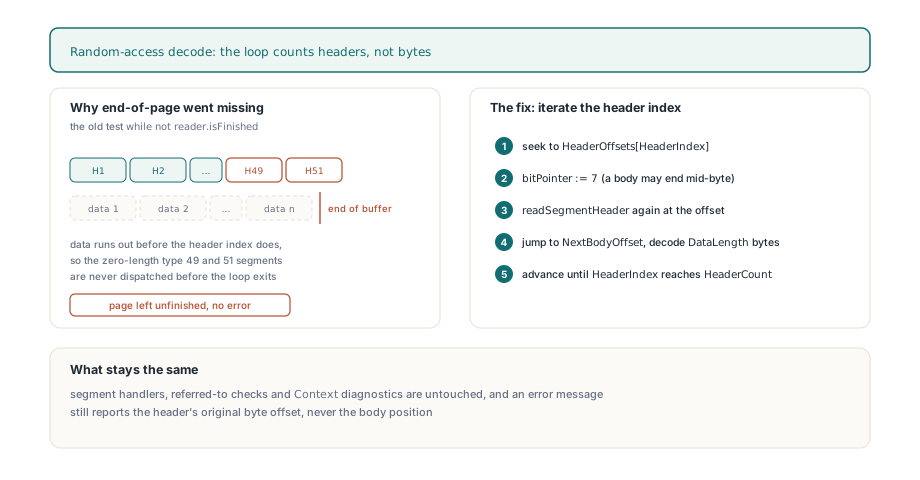
したがってランダムアクセスファイルでは、デコーダーはバイトではなくヘッダーを数えます。各ステップは、次の索引済みヘッダーへ戻り、バイト境界へ再整列し(算術符号化された本体はバイトの途中で終わることがあります)、ヘッダーをもう一度パースし、それから次の本体の始まりへ前へ跳び、宣言された長さぶん進みます。デコーダーが早く終わった本体は宣言された末尾へスキップされ、読みすぎた本体は拒否されます。そこから先は、セグメントはシーケンシャルファイルと同じハンドラーと参照検査を通ります。本体のデコード中に投げられるエラーは、JBIG2 segment N (type T) at byte B: ... の形でヘッダーの元の位置を運ぶため、LastError のオフセットは16進エディタで見つけられる場所を指します
Delphiでランダムアクセスの.jb2ファイルをロードする
アプリケーションコードは構成によって変わりません。TPLJBIG2Decoder.LoadFromByteArray がファイルヘッダーとレイアウトを検出し、拒否された入力では False を返して理由を LastError に入れ、デコードされたページを Width、Height、GetScanline で公開します。スキャンラインはピクセルごとに1バイトで、黒が1です
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // シーケンシャルもランダムアクセスも、スタンドアロンなら同じ呼び出し
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
どのレイアウトのファイルかを知りたいとき、たとえばロギングのためや、変換実行の前にコーパスを仕分けるためには、フラグバイトを自分で読んでください。ライブラリは検出した構成を公開しないので、必要なのは9バイトだけです。下のヘルパーは自分のコードに追加するためのもので、T.88 のヘッダー規則をそのまま言い直しただけです:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// 自前のヘルパー。PDFlibJBIG2 の一部ではない:T.88 のファイルヘッダーでバッファを分類する
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // 例:PDF から取り出した埋め込みストリームなど
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // ビット1が立っている:4バイトのページ数なし
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
バッチジョブ:パディングされたバッファと拒否されたファイル
末尾データの規則は、バッチコードがつまずきやすい場所です。他では開けるファイルがこの仕方で拒否されたら、ファイルより先にバッファを見てください。データベースの BLOB 列から取り出した .jb2、固定サイズのネットワーク読み取り、アラインメントパディングのあるコンテナ形式は、本当の終端の後に数バイトのゼロを載せて到着することがあります。シーケンシャルのファイルはこれを気にしません。同じパディングを持つランダムアクセスファイルは JBIG2 trailing random-access data で失敗し、数バイト短く切られたバッファも切り詰めとして失敗します。渡すのは正確にファイルのバイトであり、サイズはチャンクサイズや容量からではなく、ソースの実際の長さから取ってください
拒否されたファイルは後も残しません。LoadFromByteArray はデコードを始める前に Width、Height、スキャンラインをリセットするため、失敗した呼び出しは前のファイルのページではなくゼロの寸法を報告し、同じデコーダーインスタンスをそのまま次のファイルへ回せます:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // ここで Width と Height は 0。前のファイルのものは何も残らない
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // ファイルを責める前に、バイトの保存され方を確認する
      end;
  finally
    Decoder.Free;
  end;
end;
これを自分のパイプラインで確認するのに、珍しいサンプルファイルは要りません。シーケンシャルの .jb2 を、すべてのヘッダーとすべての圧縮バイトを保ったままランダムアクセスのレイアウトへ組み替え、end-of-page と end-of-file のヘッダーをヘッダーブロックの末尾へ移します。デコードされたピクセルは、ページ数フィールドの有無にかかわらず、シーケンシャルの原本と正確に一致しなければなりません。それから、切り詰めたプレフィックスすべて、重複したセグメント番号、余分な末尾バイト1つ、0xFFFFFFFF の長さを与えます。それぞれ False を返し、Width と Height はゼロのままであるべきです
デコーダーが返すものと、求めるもの
ここでのランダムアクセスは、ファイルレイアウトの属性です。TPLJBIG2Decoder は、ファイルがどの構成を使っていても最初のページのビットマップを返し、Width と Height はそのページを記述します。すべてのセグメントは自分のデータ長を宣言しなければなりません。T.88 はイミディエートジェネリックリージョンに 0xFFFFFFFF マーカーを許しますが、デコーダーはこのマーカーをどちらのレイアウトでも unknown or oversized segment length is not supported で拒否します。カスタム Huffman のプレフィックス長とテーブルエントリー数の上限も、シーケンシャルファイルと同じです
JBIG2 のデコードは、PDF 画像の抽出、再圧縮、JBIG2 エンコードまでをカバーするより長い画像経路の1段階です。そのパイプラインの残りとサポートされる画像形式は、PDF Library for Delphi 製品ページに解説があります