JBIG2のTablesセグメント(type 53)をバイト単位でダンプすると、最初の驚きはそこに無いものです。Huffmanコードそのものです。手元に来るのはフラグバイト1つ、境界2つ、そして小さな数字の羅列で、この数字がコード長です。エンコーダもデコーダも、実際のビットパターンをその長さからITU-T T.88 Annex B.3の手順で組み立て直します。少し違う順序で組み立てても、得られるのは依然として妥当なプレフィックスコードで、どのパターンもデコードでき、そしてどの値も間違ったパターンに結び付いて出てきます
HuffmanシンボルIDとエンコーダ供給のテーブルで符号化されたページでは、この食い違いはスキャン不良のように見えます。数ピクセルずれたグリフ、間違ったシンボルから組み立てられた文字、あるいは数セグメント先に幅が範囲外になるまで妥当に見える数値です。PDFファイルのJBIG2の大部分は算術符号化で、Huffman符号化のJBIG2の大部分は標準テーブルB.1からB.15にとどまります。自分のテーブルを運ぶファイルは希で、たいていテーブルパーサと、Huffman符号化のリファインメントと、非圧縮の集合ビットマップを一度に全部試してきます
Tablesセグメントが実際に運ぶもの
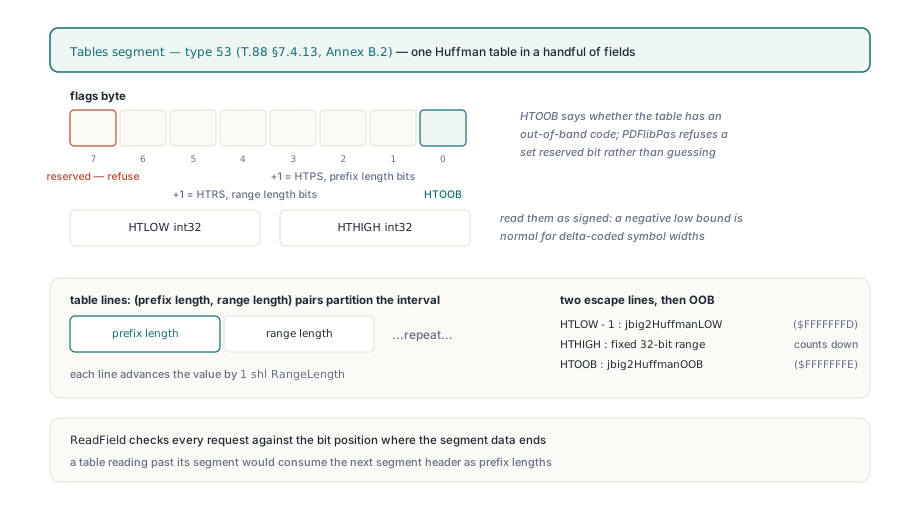
Tablesセグメントはちょうど1つのHuffmanテーブルを記述します。T.88 §7.4.13とAnnex B.2によれば、中身はフラグバイト1つ、符号付き32ビットのHTLOW、符号付き32ビットのHTHIGH、そしてHTLOWからHTHIGHまでの区間を張る(プレフィックス長、レンジ長)ペアの並びです。フラグのビット0はHTOOBで、テーブルが帯域外コードを持つかを示します。ビット1から3に1を足したものがHTPS、すべてのプレフィックス長フィールドの幅です。ビット4から6に1を足したものがHTRS、すべてのレンジ長フィールドの幅です。ビット7は予約です
境界で手書きパーサが最初につまずくことが多いです。HTLOWを符号なしで読むと、-2から始まるテーブル——delta符号化されたシンボルの幅と高さでは日常的です——が突然43億弱から始まると主張します。PDF Library for Delphiは両方の境界を符号付きで読み、HTLOWがHTHIGHより下でないテーブルやレンジ長が32を超えるテーブルを拒否し、読んだすべてのフィールドをセグメントが宣言したデータ終端のビットに対して検査します。最後の検査は聞こえ以上に重要です。セグメントを読み越えるテーブルは次のセグメントヘッダをプレフィックス長として消費し、完全なナンセンスへ解析されます。ビット7が立っていればreserved custom Huffman table flagで失敗します。当て推量より拒否を選びます。当て推量のテーブルは、原因を遡れない誤ったピクセルを作るだけです
通常の行の後にAnnex B.2のエスケープ行が来ます。下側レンジ行はHTLOWから1を引いた値から始まり32ビットのオフセットだけ下向きに数え、上側レンジ行はHTHIGHから32ビットのレンジ付きで始まり、帯域外行はHTOOBが立っているときにだけ存在します。これらの行は内蔵の標準テーブルが使うのと同じマーカーを運ぶので、カスタムテーブルもTable B.6も1つのデコードループを通ります。カスタムテーブルは最大65,536行を持てます
プレフィックスコードはなぜテーブル行の順序で割り当てなければならないのか
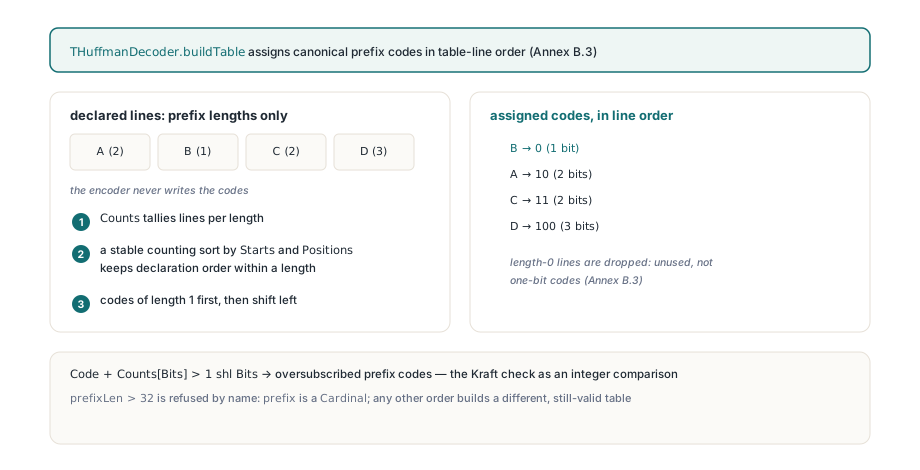
宣言順がビットパターンと値レンジを結び付ける唯一のものだからです。Annex B.3は各プレフィックス長を使う行数を数え、長さ1のコードから配り、左シフトで長さ2へ移り、以下同様に行います。同じ長さの中では、コードはセグメントに現れた順に行へ割り当てられます。小さなテーブルで具体的に見てみます。ファイル順にAからFと名付けた6行、プレフィックス長は次の通りです
| 行 | プレフィックス長 | コード(ファイル順を保持) | BとDを入れ替えたときのコード |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | 未使用 | 未使用 |
どちらの列も妥当なプレフィックスコードです。左の列だけがエンコーダの意図したものです。BとDが入れ替わると、パターン100はDの値レンジを生み出し、デコーダは間違った区間の数値のまま処理を続けます。行Fは長さ0で、B.3はこれを未使用と定義します。ここに1ビットのコードを与えると、その後の割り当てがすべてずれます
右の列を生み出す手軽な方法はプレフィックス長による汎用ソートです。DelphiのTArray.SortとTList<T>.Sortは安定ソートではないので、同じ長さはどんな順序でも返ってきます。自分のツールで正準コードを作るなら、長さごとにファイル順で1回ずつ行をなぞる方が確実です
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // Tablesセグメントから読んだ値
    Code: Cardinal;       // 下で割り当てる
  end;

// 自分のツール向けに書いたAnnex B.3の正準割り当て。
// 同じ長さはファイル順を保持し、長さ0はコードを得ない。
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Kraft検査:この長さが持てるより多いコード
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // 同順の決着はファイル順
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
上の6行を流し込むと、Aが00、Cが01、Bが100、Dが101、Eが110を受け取り、Fはコードを持たないままです。PDF Library for Delphiは同じ仕事を計数パスで行います。構造的に安定で、テーブルを32回なぞり直すことも避け、同じ2つのガードを適用します。過剰割り当ての長さはoversubscribed Huffman prefix codesで失敗します。素通しさせると1つのパターンが2つの行に一致しかねません。32ビットを超えるプレフィックスも名前付きで失敗します。T.88は紙の上では許しているのに、です。この天井が正しい取引きだと考えています。どのコードも1マシンワードに収まり、それ以上を要求するファイルは賢いというより壊れている可能性がずっと高いです
値も同じ注意を要します。下側レンジ行はHTLOWから1を引きさらに32ビット符号なしオフセットを引いた値としてデコードされ、32ビットのIntegerを中間に使うと、この引き算は普通に見える正の幅へ折り返せます。デコーダは64ビットで計算し、真の結果が収まらないときHuffman value exceeds signed integer rangeを上げます
セレクタ順と、互いを庇い合う2つの罠
テキストリージョンやシンボル辞書は自分のテーブルを名指ししません。2ビットのセレクタを運び、customに設定された各セレクタは、参照順に、参照先リストから次のTablesセグメントを取ります。T.88 §7.4.3.1.2はテキストリージョンのセレクタをFS、DS、DT、RDW、RDH、RDX、RDY、RSIZEの順に定め、§7.4.2.1.1はシンボル辞書のセレクタをDH、DW、BMSIZE、AGGINSTの順に定めます。値0と1は標準テーブルを選び、3はカスタムを選び、2は標準テーブルが2つしかないフィールドでは予約です。PDF Library for Delphiは予約されたセレクタ値を拒否し、セレクタが参照より多くのカスタムテーブルを欲しいときmissing custom Huffman table referenceで失敗します
自分でデコーダを書くなら、ここで2つの間違いは起こしやすく、しかも互いを隠します。1つ目はDelphi、またはDelphiモードのFPC(objfpcモードは重複識別子としてこのコードを拒否します)で噛み付きます。パラメータがフィールドと同じ名前を持つフラグsetterです。パラメータがフィールドを覆い隠し、Flags := Flagsは自分自身への代入になり、フィールドはゼロのままです。するとすべてのセレクタはゼロを読み、テキストリージョンはファイルが何を要求していようとFS、DS、DTに標準テーブルB.6、B.8、B.11を使い、カスタム経路は決して走りません
2つ目はシンボル辞書の中に座ります。Huffman辞書はシンボルを非圧縮の集合ビットマップとして保存できます(BMSIZEがゼロ)。各行は部分的なバイトで終わります。パディング値はそのバイトの有効ビット数であり、最下位の有効ビット位置だと読みたくなります
// 集合ビットマップの1行の最終バイト。ビットはMSBから読む。
// Padding := TotalWidth mod 8  -> このバイトの有効ビット数

// 誤り:Paddingをコピーすべき最下位ビットインデックスとして扱う
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// 正しい:最下位の有効ビットインデックスは 8 - Padding(Padding = 0なら0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixelは自分のデコーダでピクセルを書く何かの代わり
境界の幅を確かめてみます。63ピクセルの行はパディング7です。誤ったループは最終バイトの1ビットをコピーし、正しいループは7ビットコピーします。9ピクセルの行はパディング1です。誤ったループは7コピーし、正しいものは1コピーします。64ピクセルでは両方とも8ビット全部コピーするので、8の倍数はこれを露呈させません。幅7と9ピクセルの合成集合ビットマップがバイト境界の両側を釘付けにします。そして被害は旅します。リファインメントがこれらのシンボルを参照として使うからです
自分のデコーダに両方の罠があると、デバッグは悲惨になります。setterだけ直すと、カスタム経路がついに走り出し、そのまま壊れた集合ビットマップへ突っ込むので、ページはまだ間違って見えます。パディングだけ直しても、見た目は何も変わりません。カスタム経路がまだ届かないからです。どちらの変更も信用する前に合成入力で両方テストしてください。関連する細部を1つ。入力シンボルと新規シンボルの合計が1になるHuffmanシンボル辞書は、log2の式からシンボルコード長0を受け取ります。しかしHuffman変種はすべてのシンボルIDを少なくとも1ビットで書きます。PDF Library for DelphiはHuffmanモードではこの長さを1に引き上げます
Huffmanリファインメントはビットマップサイズをどこから読むのか
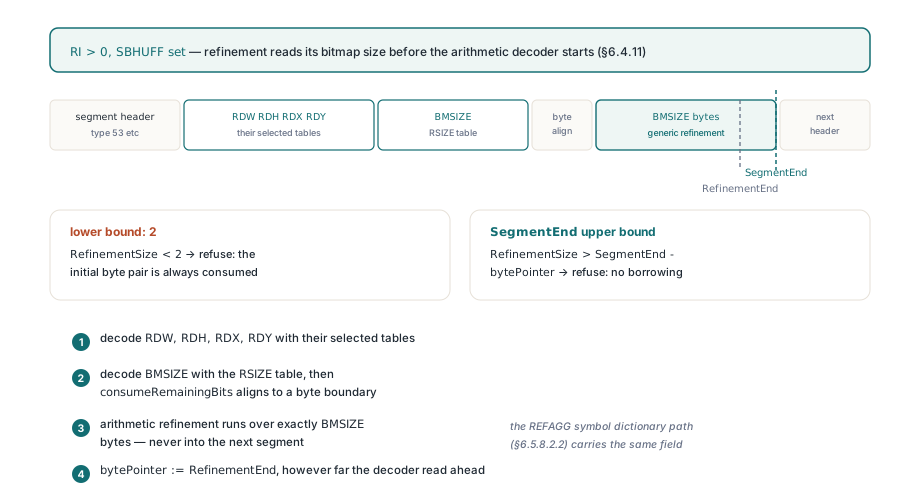
Huffmanモードにだけ存在するBMSIZEフィールドからで、算術リファインメントデータの前にデコードされます。テキストリージョンインスタンスがリファインメントを持ち(RIが非ゼロ)SBHUFFが立っているとき、T.88 §6.4.11はデコーダにRDW、RDH、RDX、RDYを選択されたテーブルで読ませ、次にBMSIZEをRSIZEテーブルで読ませ、次にバイト境界へスキップさせ、それからちょうどBMSIZEバイトに対して汎用リファインメントデコードを走らせます。算術モードのテキストリージョンにそんなフィールドはないので、両モードで1つのコード経路を共有するデコーダはこれを読み飛ばし、算術デコーダを早く起動し、すべてのシンボルをノイズに対してリファインします。REFAGG付きのシンボル辞書経路と単一のリファインメントインスタンス(§6.5.8.2.2)にも同じフィールドがあります
PDF Library for DelphiはBMSIZEを両側で打ち止めます。最小は2で、算術デコーダが必ず消費する最初のバイトペアです。最大は現在のセグメントの残りであって、故意にストリーム全体ではありません。次のセグメントからバイトを借りてようやく収まるBMSIZEは不正で、ストリーム長検査では算術デコーダが後続のヘッダに読み込んでしまえます。範囲外のサイズはinvalid refinement bitmap sizeで失敗します。その後Huffmanリーダは、算術デコーダがどれだけ先読みしていようと、フィールドからちょうどBMSIZEバイト先へ復帰します
宣言されたセグメント長が境界である
すべてのセグメントヘッダは後続のデータバイト数を述べており、デコーダはセグメントをその数に双方向で縛ります。終端を読み越えるのはエラーで、早く終わるのは正常で、次のヘッダは常にファイルが示した開始位置から読まれます。細かい規則が続きます。T.88 §7.2.7の不明データ長は、終端子を探してスキャンする代わりに最初から拒否します。参照先セグメントは現在より小さい番号を運び、既に存在していなければなりません。END_OF_PAGEとEND_OF_FILEはゼロデータバイトを宣言しなければなりません。Profilesセグメント(type 52)はちょうど4+4×識別子数でなければならず、その後スキップされるものの保持され、後続のセグメントはまだ参照でき、未知のプロファイル識別子はデコードを止めません
早く終わる典型例はMMRです。MMRデコーダは最終行の最後のピクセルを生み出した時点で終わりであり、T.88 §6.2.5.7がデータの終端に置くEOFB終端子より先に起こり得ます。今は次のヘッダにいると仮定するリーダは、余ったEOFBバイトをセグメント番号として解析し、数バイト先で、本当の原因から遠く離れて失敗します。宣言された終端へ跳べば疑問ごと消えます。同じ習慣は、PDF Library for Delphiが信頼できないPDF構造を解析するやり方全般を貫いています
DelphiからJBIG2画像ストリームをデコードする
デコーダはPDFlibJBIG2ユニットのTPLJBIG2Decoderとして住んでいます。LoadFromByteArrayは/JBIG2Decode画像の埋め込みJBIG2データを受け取り、任意で/JBIG2Globalsストリームのデータを受け取ります。カスタムテーブルと共有シンボル辞書はたいていここに住んでいます。どんな拒否でもFalseを返し、理由をLastErrorに残します。前の呼び出しの出力は毎回の呼び出しの冒頭でクリアされるので、失敗したデコードが古いピクセルを結果と誤認させるために残されることはありません
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes:JBIG2Decodeより手前のフィルタが
//   既に取り除かれた画像ストリームデータ
// GlobalBytes:/JBIG2Globalsストリームデータ、または空配列
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // 形式:'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // 1ピクセル1バイト、0か1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1はJBIG2では黒
    end;
  finally
    Decoder.Free;
  end;
end;黒ピクセル数は自分向けの検査であり、別のレンダラと比較するための安上がりな指紋です。セグメントレベルの失敗はセグメント番号、type、バイトオフセットを頭に付けて届くので、oversubscribed Huffman prefix codesの前の(type 53)がTablesセグメントをまっすぐ指します。2つのエラー経路を混ぜないでください。TPLJBIG2Decoder.LastErrorはこのデコーダの診断テキストであり、TPDFlib.LastErrorCodeはライブラリレベルAPIの数値コードです。ページ選択はストリームに従います。デコーダは最初に会ったページ情報セグメントのビットマップを返し、ページ関連付け0を探しに行きません。PDF埋め込みJBIG2は1ページを運び、エンコーダはたいていそれを1と番号付けるからです
こういうファイルでのレンダラ比較には謙虚さが要ります。独立したJBIG2デコーダは、Huffmanリファインメント付きのカスタムテーブルファイルでいつも一致するとは限らないからです。2つのデコーダの食い違いでは何も決まりません。決めるのはフォーマットフィールドです。セレクタがどのテーブルを選んだか、BMSIZEが何を宣言したか、各セグメントがどこで終わるかです
エンコードはJBIG2エンコーダバックエンドとそのリンク方法の記事で扱います。読み込み経路は他人のエンコーダが出力したものを何でも受け止める側であり、その規則は組み込みTIFFデコーダのBigTIFFとタイリング検査と共有しています。名前付きで拒否する、宣言された境界を越えてバイトを借りない、中間の演算を広く保つ。スキャンPDFのフォルダが他のツールキットをつまずかせ続けるなら、画像がカスタムテーブル付きのHuffman符号化JBIG2か確かめ、PDF Library for Delphi製品ページで述べたネイティブDelphiとC++Builderの読み込み経路で試してみてください