顧客コメントを正しくエスケープし、<b>urgent</b>が<b>urgent</b>としてHTMLテンプレートに入り、それをマークアップを2回パースするレンダラーに渡すと、PDFはurgentという語を太字で返してくることがあります。エスケープは正しかった。レンダラーがパスごとに1回ずつデコードしたのです。パースし、結果をHTMLとして書き戻し、またパースするというHTML-to-PDF経路はすべて、全体の旅の間で実体を正確に1回デコードしなければなりません
ヘルプデスク版のこの話はありふれています。チケットはPDFへエクスポートされ、顧客コメントは<p>の中に座り、誰かがコメントボックスに山括弧を打ち込みます。未知のタグ名はページからただ消えます。エスケープされたアンカーは、スタッフが信頼するドキュメントの中で、クリック可能なリンク注釈になります。ファイルは妥当でどこでも開きます。データと違うことを言っているだけです
エスケープ済みテキストがマークアップに戻る場所
エスケープ済みテキストがマークアップに変わるのは、2パスレンダラーがデコード済みのテキストを、再エスケープせずにHTMLへ書き戻す地点です。最初のパースがデコードしたものは何でも、2回目のパースにとって生きた構文になります
PDF Library for Delphi(PDFlibPas)のDrawHTMLTextとDrawHTMLTextBoxの2パスには、ちゃんとした理由があります。最初のパースは入力をタグと単語へ分割します。レンダラーは続いてスタイルシートのカスケードを解決します。<style>ブロックのルールを各タグに対して照合し、インラインのstyle属性とマージし、要素リスト全体を、各タグが最終スタイルを運ぶ1つの正規化HTML文字列として書き戻します。レイアウトパスがその文字列をパースします。PDFlibPas HTMLレンダリングのflexbox、CSS grid、脚注レイアウトで述べたセレクタマッチング、flexbox、grid、そのほかのCSSサポートは、すべてその中間ステップに依存しています
危険は単語がどう出てくるかに座ります。タグはソースの形から書き戻せますが、単語はデコード済みテキストとして保持されます。行ブレーカーが計測するのはそれだからです。<unsafe>から来た単語をそのまま正規化文字列へ付け足すと、<unsafe>が2回目のパースに要素として届きます。デコード1回の設計は、さらに3つの小さな漏れも塞ぐ必要があります
&がデコード集合にないと、R&Dはそのまま印字され、<という綴りをテキストとしてページに載せる道がまったくなくなります- 描画ステージがパース終了後に
をまた置換すると、リテラルの実体綴りがどたんばで消えます - 上流のHTML生産者、たとえばMarkdownコンバーターやデータセットエクスポーターが山括弧だけをエスケープすると、コードサンプルやセル値の中の実体綴りがマークアップへデコードされます
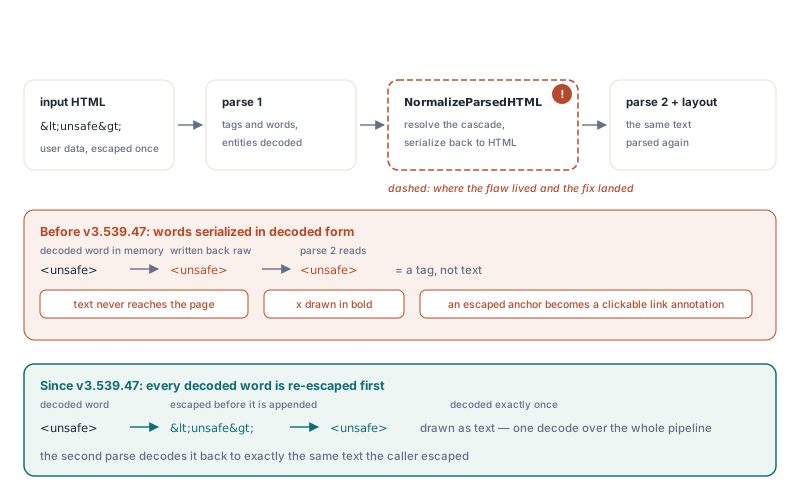
下の表は、いくつかの入力に対して何がページへ届くかを、素朴な2パスレンダラーとPDFlibPasのパイプラインで並べたものです
| レンダラーへ届く入力 | 素朴な2パスレンダラー | PDFlibPas |
|---|---|---|
<unsafe> | タグとしてパースされ、テキストはページへ届かない | <unsafe>がテキストとして描かれる |
<b>x</b> | xが太字で描かれる | <b>x</b>がテキストとして描かれる |
R&D | R&Dがそのまま印字される | R&D |
&lt; | &lt;がそのまま印字される | < |
を含むMarkdownコードスパン | ノーブレークスペース | がテキストとして描かれる |
データセットのセル値< | < | < |
PDF Library for Delphiは実体をどう正確に1回だけデコードするのか
PDF Library for Delphiは、3つの規則を一緒に守ることで各実体を正確に1回デコードします。パーサは&を最後にデコードする、描画ステージは何もデコードしない、デコード済み単語をHTMLへ戻すすべての場所は先にエスケープする。3つのうちどれか1つでも落とすと、上の表のどれかの行が素朴な列へひっくり返ります
何がデコードされるかから始めます。テキスト内容では、パーサは<、>、&、 を認識します。Aのような数値参照や"のような名前付き実体はリテラルテキストのままです。この短いリストが自分の入力をどうエスケープすべきかを決めます。この話はさらに下で再登場します
デコーダ内部の順序は、1つのパスの中でさえ重要です。&を先にデコードすると、入力&lt;は<になり、その直後の置換がそれを<へ変えます。2回のパースなしの二重デコードです。だから8ビット単語経路は<、>、 を先に、&を最後に置換し、作り出されたアンパサンドは2度と見られません。UTF-16単語経路は別の道で同じ結果に到達します。2バイト刻みの1回の左から右走査が各マッチをその場で書き換え、その先へ進みます
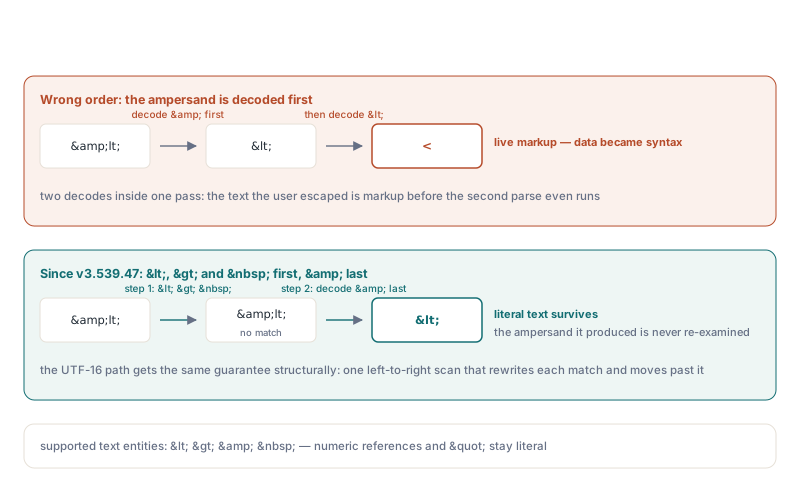
描画ステージには遅い 置換はありません。行ブレーカーへ届く単語は最終テキストであり、デコードはパーサの中だけに住んでいます
一番重いのは境界の規則です。レンダラーが正規化HTMLを書くとき、追加する前にすべてのデコード済み単語の中の&、<、>をエスケープし、2回目のパースがそれを同じ文字へデコードして戻します。両パスを通した正味効果は1回のデコードです。DrawHTMLTextBoxが返す継続文字列も同じ規則に従います。収まらなかった単語は残りへ入る前にエスケープされ、残りの残りは正規化HTMLからコピーされます。既にエスケープ済みです。すべてを収めるボックスは空文字列を返します
UTF-16BEのエスケープにバイト単位の置換が使えない理由
UTF-16BEのエスケープにバイトレベルの置換が使えないのは、アンパサンドの2バイトが無関係な2文字に跨れるからです。安全な作業単位は16ビットコードユニット全体だけです
レンダラーはUnicode単語をビッグエンディアンUTF-16としてバイト文字列にパックして保持します。上位バイトが先で、アンパサンドは00 26です。U+0100(マクロン付きラテン大文字A、バイト01 00)の後にU+2603(雪だるま、バイト26 03)を置いてみます。バッファは01 00 26 03と読め、2番目と3番目のバイトが00 26と綴ります。#0'&'のバイト検索は、どの文字も含んでいないアンパサンドを見つけ、2つのコードポイントのど真ん中へ&を接ぎ込み、その後のすべての文字を1バイトずらします
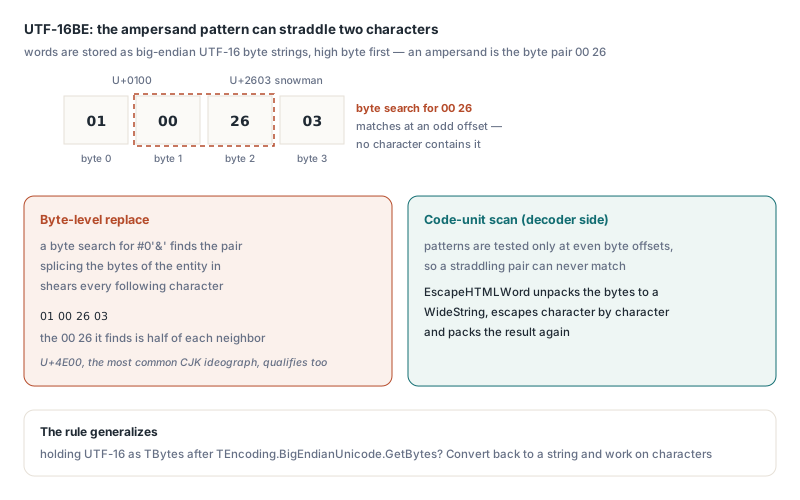
これは異国の隅ではありません。下位バイトがゼロの文字ならどれでも前半を供給でき、最もよく使うCJK漢字の1つU+4E00はまさにそういう文字です。山括弧も同じやり方で露出します。そういう文字の後にCJK Extension AのU+3C00からU+3EFFの文字が続くと、00 3Cと00 3Eが現れます。だからPDFlibPasはUnicode単語をWideStringへ展開し、1文字ずつエスケープし、結果を再パックすることでエスケープします。デコーダは対の理由で安全です。偶数オフセットでだけパターンを試すからです
自分のコードも同じ壁にぶつかれます。UTF-16テキストがTBytesに住むようになったら、たとえばTEncoding.BigEndianUnicode.GetBytesの後など、バイトパターンでの検索は正しい文字ペアを待つバグです。文字列へ戻して、文字で作業してください
Markdownコードとデータセットセル:アンパサンドが先
PDFlibPasの内側の2つのHTML生産者、Markdownコンバーターとデータセットエクスポーターは、山括弧の前にアンパサンドをエスケープするので、レンダラーの1回のデコードが元のテキストをバイト単位で復元します
MarkdownToHTMLでは、インラインコードスパンとfencedあるいはインデントされたコードブロックは&を&へ、<を<へ、>を>へ写します。スペースは になり、タブはその4つになり、インデントが保たれます。普通の散文は山括弧だけをエスケープします。散文に打ち込まれた生HTMLはタグを注入できませんが、意図的に&と書いた作者はそれでもアンパサンドを受け取ります。Markdown作者が期待する通りの挙動です。DrawMarkdownTextとDrawMarkdownTextBoxは同じ変換を走らせるので、コードブロックは打ち込まれた通りに現れます
uses
System.SysUtils, PDFlibrary;
procedure RenderCodeSample;
var
Lib: TPDFlib;
Md, Html: WideString;
begin
Md := 'Comparison helper:' + sLineBreak + sLineBreak +
'```' + sLineBreak +
'if (A < B) and (Flags <> 0) then' + sLineBreak +
' WriteLn(''<tag> & R&D'');' + sLineBreak +
'```';
Lib := TPDFlib.Create;
try
// HTMLを確認:コード内では'&'が'&'に、'<'が'<'になる
Html := Lib.MarkdownToHTML(Md);
Lib.SetOrigin(1); // 左上原点、Yは下向きに増える
Lib.SetMeasurementUnits(0); // ポイント
// ページはコードを打ち込まれた通りに示す。実体の綴り込み
Lib.DrawMarkdownText(50, 50, 495, Md);
Lib.SaveToFile('code-sample.pdf');
finally
Lib.Free;
end;
end;データセットエクスポーターは、魅力的な近道が住む場所です。レンダラーが&をデコードしないなら、アンパサンドのエスケープはアンパサンドを含むすべてのセルに&を印字するので、山括弧だけのエスケープのほうが友好的に見えます。最初に<を運ぶセルで崩れます。それが<としてページへ届くのです。レンダラーは&をデコードするので、PDFlibExportDataSetの背後のエクスポーターは&を先にエスケープし、R&D < & のような値はそのままPDFへ着地します。そのエクスポーターの残りは、DelphiでTDataSetをPDFレポートへエクスポートするで扱います
なぜ連鎖のどこかでなく先なのか。<を先にエスケープすると<を得ます。&を2番目にエスケープするとそれは&lt;になり、正しい1回のデコードはそれを<でなく<として表示します。逐次置換連鎖が機能するのは、エスケープ文字そのものが、それを導入するどのステップよりも先に扱われるときだけです
DrawHTMLTextBox向けに信頼できないテキストはどうエスケープすべきか
PDFlibPas向けに信頼できないテキスト内容をエスケープするには、&、次に<、次に>を、正確に1回ずつ置換し、信頼できないデータは属性値には入れません。下のヘルパーは自分で足すもので、素のRTLコードです
uses
System.SysUtils, PDFlibrary;
// 自作ヘルパー(ライブラリの一部ではない):信頼できないテキストを
// PDFlibPasのHTMLテキスト内容向けにエスケープする。'&'は先に置換しないと
// 作られたばかりの'<'の中のアンパサンドが
// 2度目にエスケープされてしまう
function EscapeHTMLText(const S: string): string;
begin
Result := StringReplace(S, '&', '&', [rfReplaceAll]);
Result := StringReplace(Result, '<', '<', [rfReplaceAll]);
Result := StringReplace(Result, '>', '>', [rfReplaceAll]);
end;
procedure RenderTicket(const CustomerComment: string);
var
Lib: TPDFlib;
Html: WideString;
begin
Lib := TPDFlib.Create;
try
Lib.SetOrigin(1);
Lib.SetMeasurementUnits(0);
Html := '<p><b>Customer comment</b></p>' +
'<p>' + EscapeHTMLText(CustomerComment) + '</p>';
Lib.DrawHTMLText(50, 50, 495, Html);
Lib.SaveToFile('ticket.pdf');
finally
Lib.Free;
end;
end;コメントTry <a href="https://example.com">this</a> & <b>を流し込むと、ページはそれらの文字を1対1で示します。2回デコードするレンダラーの下では、同じエスケープ済み入力が生きたリンク注釈になります。化粧の乱れからセキュリティ問題へのステップです。チケットのコメントは、自分のスタッフへ渡るPDFにクリック可能なURLを植えられてはいけません
ヘルパーが放置するものに注目してください。汎用のエスケーパーはさらに"を"へ、'を'へ変えます。ブラウザでは正しく、ここでは間違いです。PDFlibPasのテキストデコードは先に挙げた4つの実体しか知らないので、この2つは"と'としてそのまま印字されます。この用途にブラウザのエスケーパーを流用しないでください。引用符はテキスト内容では無害であり、属性値の中でのみ意味を持ち、レンダラーは属性の中の実体をまったくデコードしません。属性については、賢いエスケーパーより規則が欲しいところです。そこではどんなエスケープ方式も検査されないのですから。ユーザーの値をhref、src、styleに入れないこと。リンクターゲットが本当にユーザー入力から来るなら、スキームと文字の許可リストで自分で検証し、引用符や山括弧を含むものは拒否してください
シングルパスデコードから2つの習慣が直接従います
- 常に
&をエスケープする。飛ばすと、<を含むユーザーテキストが<として現れます。無害ですが、ユーザーが打ち込んだものではありません - エスケープは1箇所でだけ行う。2つのエスケーパーを通ったテキストは
<を目に見える綴り<としてレンダリングするので、データがHTML文字列に入る唯一の場所を見つけ、そこでエスケープしてください
LeftOverTextでのページ分割、エスケープを壊さずに
DrawHTMLTextBoxは収まらなかったHTMLを返します。通常はLeftOverTextと呼ばれるもので、その残りは次のボックスへ入るとき、リテラルの実体綴りとエスケープ済み山括弧をそのまま保ちます。受け取った通りそのまま返してください
const
  BoxLeft = 50;
  BoxTop = 50;
  BoxWidth = 495;    // ポイント単位のA4ページ向けサイズ
  BoxHeight = 740;
  MaxPages = 500;    // 自前の安全上限

procedure RenderLongHTML(Lib: TPDFlib; const Html: WideString);
var
  Rest: WideString;
  Pages: Integer;
begin
  Lib.SetOrigin(1);
  Lib.SetMeasurementUnits(0);
  Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Html);
  Pages := 1;
  while (Rest <> '') and (Pages < MaxPages) do
  begin
    Lib.NewPage;
    Inc(Pages);
    // 残りは既にエスケープ済みのHTML:決してエスケープもアンエスケープもしない
    Rest := Lib.DrawHTMLTextBox(BoxLeft, BoxTop, BoxWidth, BoxHeight, Rest);
  end;
  if Rest <> '' then
    raise Exception.CreateFmt('Content still left after %d pages', [MaxPages]);
end;残りは不透明なものとして扱ってください。各タグにスタイルが既に解決済みの正規化HTMLであり、自分のエスケーパーを通すとすべての<が&lt;になり、デコードすると次のボックスに生きたタグを渡します。新鮮なユーザーテキストをそこへ接ぎ込むのも同じ2つの失敗モードを持ちます。ページ上限は比較1回の代金です。ある要素が絶対にボックスに収まらないなら、上限なしループには自然な出口がありません
Markdownには独自の継続があります。DrawMarkdownTextBoxはマーカーコメントで始まる残りを返し、それがMarkdownのエントリーポイントに次の呼び出しで変換をスキップするよう伝えます。DrawMarkdownTextBoxかDrawMarkdownTextへそのまま返してください。LeftOverTextをDrawHTMLTextBoxへ返すのと同じやり方です。Markdownの残りはMarkdownのエントリーポイントに属するので、そちら側に保ち、DrawHTMLTextBoxの残りだけをHTMLの呼び出しへ回してください
このすべての背後の形状——パースし、同じ構文へ書き戻し、またパースする——はテンプレートエンジン、HTMLサニタイザー、MarkdownからHTMLからPDFへの連鎖にも現れます。そして失敗は2方向から来ます。再エンコードが足りないとデータが構文になります。エンコードが多すぎる、あるいはデコーダが2回走ると、実体の綴りが読者に見えたり、食べられたりします。1方向だけの継ぎ接ぎはもう片方を壊しがちです。だからPDFlibPasレンダラーは、&のデコード、それを最後にデコードすること、遅いデコードをしないこと、すべての境界での再エスケープを1つのパッケージとして扱います。エクスポート方向もDelphiからPDFをMarkdownとDOCXへ意味的にエクスポートするで同じ規則に従い、各リテラル文字はターゲット構文向けに正確に1回エスケープされます
HTMLとMarkdownの描画、データセットレポートエクスポーター、レイアウトエンジンの残りは、PDF Library for DelphiのネイティブPascalソースとして届きます。DelphiとFree Pascalの両方向けです。エディション、プラットフォームカバレッジ、トライアルダウンロードはPDF Library for Delphi製品ページに一覧があります