情報辞書が/Title (Annual Maintenance Report)と言い、XMPパケットにはdc:titleがまったくないファイルを考えてください。ビューアーは文句なしにタイトルを表示しますが、PDF/A検証ツールは、2つのメタデータコピーが食い違っているとしてファイルを拒否します。もう1つのファイルは同じくらい健康に見えるのに、XMPにpdfaid:partエントリがなく、検証ツールは数十個のエラーで答えます。普通のPDFとして判定し、主張されたパートの規則をすべて違反として報告するのです。欠けた1行から、すべてが来ています
この2つの問題は、必要な仕事の量がまったく違います。メタデータの一致化は、どのファイルにも走らせられる狭い修正です。任意のPDFをアーカイブ向けに変えることは、ターゲットのパートが禁じるものを剥ぎ取り、要求するものを追加し、主張を明示し、そして実際に出てきたバイトを検証することです。私たちは変換を、意図的にこの最後の工程を中心に組み立てました。Enterpriseエディション(TPDFlibEnterprise)に同梱されるConvertToPDFAは、GetPDFAConversionReportと一緒に、変換した文書をメモリへ保存し、そのバイトに対してPDF/A検査を走らせ、その検査が通ったときにだけ1を返します
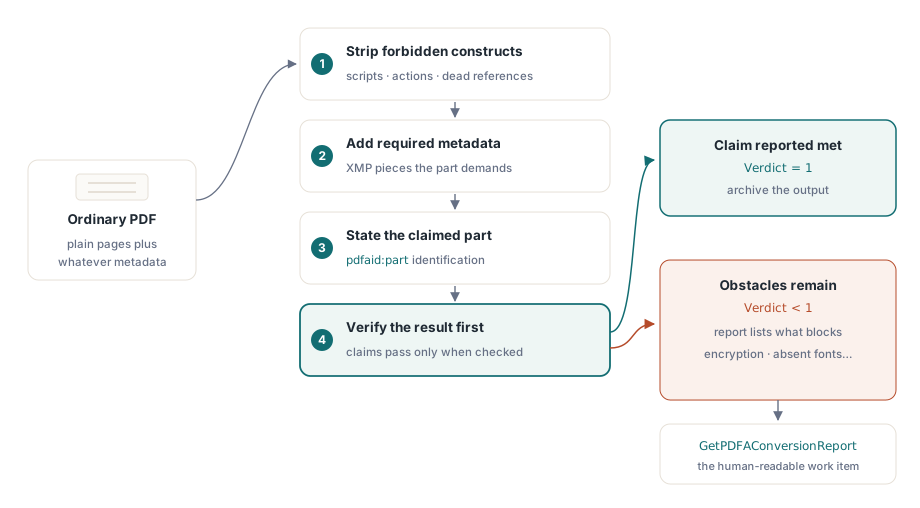
普通に開けるPDFがPDF/A検査で落ちるのはなぜか
両方の失敗はメタデータの規則から来ます。PDFはタイトル、作成者、プロデューサー、日付を文書情報辞書に記録し、PDF/Aは同じ事実をXMPメタデータパケットにも要求します。ISO 19005-1 §6.7.3は両者の等価性を求め、PDF/A-2とPDF/A-3もこの規則を保ちます。この規則で落ちるファイルの典型的なパターンは、情報辞書を埋めたのにXMP側を書かなかったプロデューサーです。検証ツールは片側でタイトルを見つけ、もう片側で何も見つけられません
欠けた識別はもっと静かです。pdfaid:partとpdfaid:conformanceのエントリがファイルをPDF/Aとして印付けるものであり、これらがなくてもファイルは完全に正しくあり得ます。最もよく見るケースは、アプリケーションが独自のXMPパケットを供給し、PDFライターが生成したものと置き換えるケースです。独自パケットはアプリケーション自身のフィールドを運び、pdfaidエントリを持たないため、エラーリストは本当の原因の近くすら指しません
RepairDocumentMetadataは両方のケースを処理し、変更したエントリ数を返します。すべてのエディションで利用でき、SetPDFAModeとSanitizeDocumentも同じです。修復はTitle、Author、Subject、Keywords、Creator、Producer、CreationDate、ModDateを歩きます。XMPだけが値を運ぶ場所では、情報辞書がそれから埋められ、すでに記録されたものが捨てられることはありません。両者が値を運び、食い違う場所では、情報辞書が勝ちます。これは、情報辞書のほうがプロデューサーが最もよく設定する側であり、作者の意図を記録している可能性が高いと判断したためです
あなたのXMPが正のコピーである場合(たとえば文書管理システムで手入れされたものです)、望む値をまずSetInformationで情報辞書へ押し込み、そのうえで修復を実行します。逆の順序では、手入れされたXMPのタイトルが、元のプロデューサーが書いたもので上書きされます
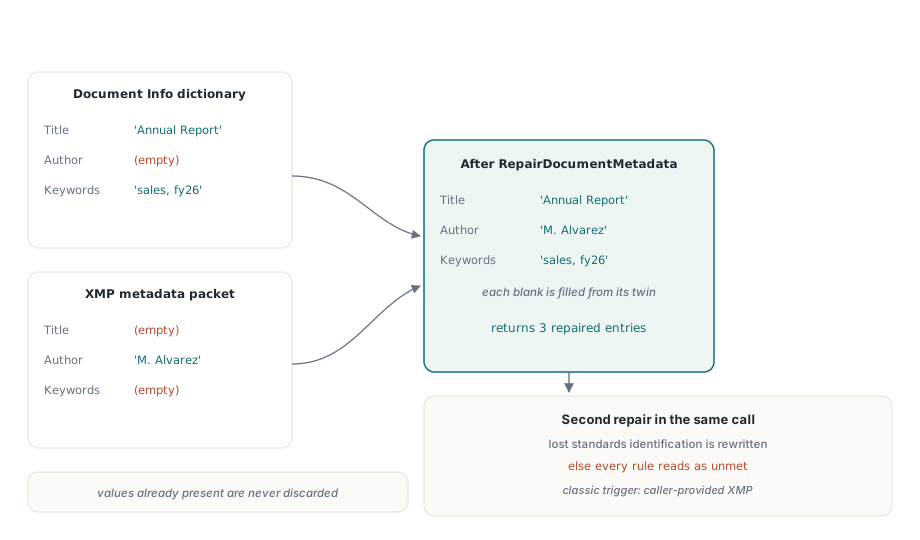
識別の修復には、あなたからの1つの情報が要ります。文書がどのパートを狙っているかを知っていることです。読み込んだばかりのファイルにはPDF/Aモードが設定されていないため、修復の前にSetPDFAModeを呼びます。モードが揃うと、RepairDocumentMetadataは一致するpdfaidエントリを書き、パート4のモードには2020年の年を付したpdfaid:revを追加し、dc:formatをapplication/pdfに設定します。検証ツールはこれも確認します
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // 手入れされたタイトルは先に情報辞書へ入れる。
    // 両半分が食い違うときに勝つのはこちらのコピーだからである
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b、下の表を参照
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
ターゲットのパートとモード番号を選ぶ
パートは、文書が何を運ばねばならないかから選び、番号はその後で引きます。SetPDFAModeとConvertToPDFAは1つの番号方式を共有しており、これはパート名が示唆する順序では走っていません
| モード | パートとレベル | 備考 |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4、タグ付き |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7、タグ付き |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | 任意の型の埋め込みファイルを許可 |
| 8 | PDF/A-2u | PDF 1.7、Unicodeテキストが必要 |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0。4eは3Dとリッチメディアを追加、4fは埋め込みファイルを許可 |
モード3はPDF/A-2b、モード4はPDF/A-2aです。この逆転は、1aから数え上げてaレベルが常に先頭に来ると仮定する人を捕まえます。PDF/A-2uは、パート3のモードの後、8に現れます
本当に帰結のある選択は添付ファイルについてです。パート1と2は埋め込みファイルを禁じるため、ConvertToPDFAはモード1から4と8ではそれらを取り除きます。Factur-XやZUGFeRDの請求書をモード3へ変換すると、構造化されたXML請求書が出力から消え、ファイルが存在した理由も一緒に消えます。添付を運ぶものは、モード5(PDF/A-3b)を狙ってください。これらの請求書形式が定義されているのがそのパートでもあります。PDF 2.0が必要ならモード11です。パート3やパート4のファイル内のすべての添付は、/AFRelationshipで文書との関係を明示しなければならず、PDF Library for Delphiはこれらのモードで保存する埋め込みファイルごとにそのエントリを書きます
パート4は自分自身を別のやり方で識別します。素のPDF/A-4には適合文字がなく、2つの拡張にはEかFを使い、パートが発行された年のpdfaid:revを要求します。ConvertToPDFAはモード9から11でファイルをPDF 2.0へ引き上げます。ISO 19005-4 §6.1.2がこのパートをPDF 2.0の上に組み立てているためで、検査はそのようなファイルを1.7ではなくPDF 2.0に対して判定します
ConvertToPDFAがファイルの中で変えるもの
ConvertToPDFAは固定された修復の順序を実行し、それぞれをプレーンテキストのレポートに記し、結果をメモリへ保存してそのバイトを検証します。失敗した検査は0を返し、1から11の外のモードも同様に、レポートが書かれる前に返ります。この順序を知っておく価値はあります。各ステップは、出力が失うか得るかするものだからです:
- パスワードの未知な暗号化文書は、
blocked:の1行とともに即座に変換を止めます。中身は読めず、修復どころではありません - 文書レベルのJavaScriptと、それを実行するオープンアクションは削除されます。すべての追加アクションエントリと、どのパートも許さないアクション型、Launch、Sound、Movie、ResetForm、ImportData、Hide、SetOCGState、Rendition、Transも一緒です。GoToとURIのリンクは残るため、ナビゲーションは動き続けます
- 埋め込みファイルは、それを禁じるパートでは上記のとおり取り除かれます
- 隠されている注釈や、非表示固定の注釈は削除されます。PDF/Aは注釈の可視性と印刷可能性を要求しますが、それらを表に出すとページの見た目が変わるため、削除を選びました
- フォームフィールドの外観は、
/NeedAppearancesフラグをクリアする前に再生成されるため、記入済みの値は見え続けます - 使われているのに埋め込まれていないフォントは、マシンにインストールされたフォントから埋め込まれます
- もう誰からも参照されないオブジェクトは落とされ、ファイルに出力インテントがなければsRGBのそれが追加されます
- 最後に、パートとレベルがXMPで明示され、バイトが検査されます
サーバーでは、フォントの工程が変換を滞らせる最も多い原因です。変換ホストのどこにも存在しないフォントを使う文書は、ファイルの内側からは修復できず、レポートがその旨を告げます。変換マシンには、文書が実際に使うフォントをインストールしてください。この工程単体は、既存PDFへの欠落フォント埋め込みの解説が扱います
バッチジョブは失敗した変換をどう扱うべきか
戻り値はゲートとして、レポートは作業チケットとして扱ってください。1を返したファイルはアーカイブし、残りはレポートを添えて人へ回します。入力より見た目がきれいだからという理由で、失敗した変換の出力をアーカイブに保存してはいけません。そのファイルは今や、検査が確認を拒んだPDF/Aの主張を運んでおり、検証工程が存在するのはまさにこの状況を防ぐためです
GetPDFAConversionReportのレポートは、動詞で始まる1行につき1アクションです。removed:、regenerated:、repaired:、embedded:、added:、stated:、さらに走行を止めたものがあればblocked:、そして締めのresult:行です。判定の背後にある検査は最初の失敗で止まるため、ファイルが落ちたとき、変換は検査をフルで再度実行し、レポートはすべての問題を一度に示します。プレフィックスでの振り分けは数行で済みます
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b、添付ファイルを保持する
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // 元のファイルは触れない。一緒に旅するのはレポートだけ
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;blocked:の行は、たいてい修正がPDFの外側にあることを意味します。パスワード、別のソースファイル、あるいは文書を生成したものの再実行です。フル変換の後の素の検証問題は、意味を運ぶため単純に削除できないコンテンツであることが多く、人が決めなければならないのはこういうケースです
ファイルがすでに担うPDF/Aマークを読む
変換の前に、文書が自分自身についてすでに何と主張しているかを確認してください。スキャナー、オフィススイート、他のPDFツールから届くファイルは、しばしばすでにPDF/Aマークを担っています。妥当なPDF/A-3ファイルをパート2へ再変換するのは、何の得もなく添付ファイルを失うことです
罠は、XMPが同じプロパティを2通りの書き方で許していることです。パートを子要素として書くプロデューサー、<pdfaid:part>2</pdfaid:part>。rdf:Descriptionの属性として書くプロデューサー、pdfaid:part="2"。どちらも普通の妥当なXMPです。片方の形式だけを探す検出器は、もう片方のファミリーのプロデューサーのファイルをマークなしと判定します。こう作られたチェッカーは、最終的に妥当なPDF/A-2ファイルをパート1に対して判定し、マークなしでPDFバージョンが高すぎると報告します。真実の正反対です。PDF Library for Delphiの検証ツールは両方の形式を読みます。自分でマークを覗き見するなら、同じことをしてください:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // 要素形式
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // 属性形式、二重引用符
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // 属性形式、一重引用符
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
空の結果は、どちらの形式でもマークがないことを意味します。数字はプロデューサーが意図したパートを教え、変換するかどうかを決める前に、あなたのターゲットと比較すべき番号はその数字です
ファイルがアーカイブに入る前のスクリプトのサニタイズ
アーカイブ変換とセキュリティサニタイズは、たいてい一緒に走ります。セキュリティポリシーが除去したいコンテンツと、PDF/Aが禁じるコンテンツの重なりが大きいからです。SanitizeDocumentはSANITIZE_*フラグのビットマスクを受け取り、適用した除去の数を返します。ConvertToPDFA自身は、最初のステップとしてSANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTIONでこれを呼びます
検証ツールにとって効く細部が1つあります。文書レベルのスクリプトは、カタログの/Names辞書の下の/JavaScript名前ツリーに住んでおり、最後のスクリプトが削除されると、空になったツリーは一緒に削除されます。空のツリーでも、文書がスクリプトを持つと告げ続けるため、中身を数えずにキー自体へ反応するチェッカーもあります
サニタイズしたのがどのツールであれ、保存されたファイルはメモリ内の状態を信用せず、新しい読み込みで検証してください。開き直すのは安上がりです:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;アーカイブパイプラインの隣接する工程については、PDF/AとPDF/UAのプレフライト、本物の墨消しとコンテンツ除去、そしてFactur-X向けPDF/A-3 XMP拡張スキーマのガイドを参照してください。最後のものは、アーカイブされた文書が構造化請求データも運ぶときに、メタデータ側を引き受けます
ここで示した変換、メタデータ修復、検証はすべて、外部のコンバーターやコマンドラインの検証ツールを仲介せず、自分のDelphi、C++Builder、Lazarusプロセスの内側で走ります。PDF/Aのパート、エディション、ターゲットプラットフォームはPDF Library for Delphiの製品ページに一覧があります