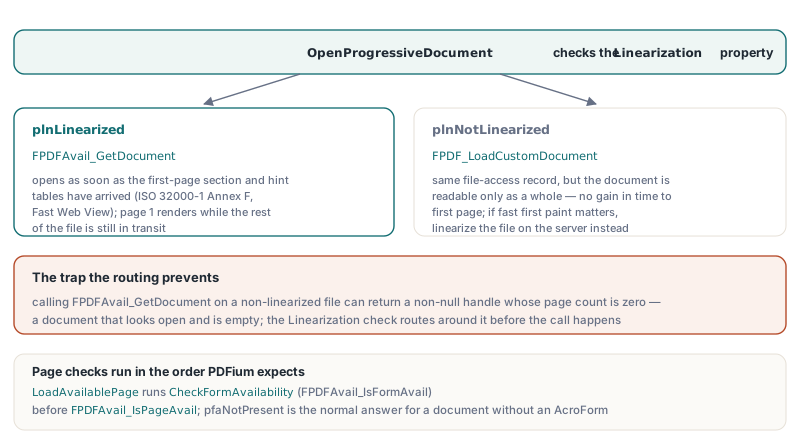
Un handle di documento non nullo con conteggio pagine zero è ciò che FPDFAvail_GetDocument può restituire quando viene chiamato su un PDF mai linearizzato, persino dopo che FPDFAvail_IsDocAvail ha riportato PDF_DATA_AVAIL. L'handle sembra aperto, nessuno si lamenta, e il viewer mostra un documento vuoto. L'API di disponibilità di PDFium legge il layout linearizzato dell'Allegato F di ISO 32000-1; ogni altro file deve essere completo e aperto attraverso l'ordinario percorso custom-document. Quella decisione di instradamento è metà di ciò che comporta aprire un PDF durante il download. L'altra metà è l'utente che chiude la scheda a un quarto del file e riapre lo stesso collegamento un attimo dopo
Il ciclo di disponibilità dietro TPdfProgressiveDocument
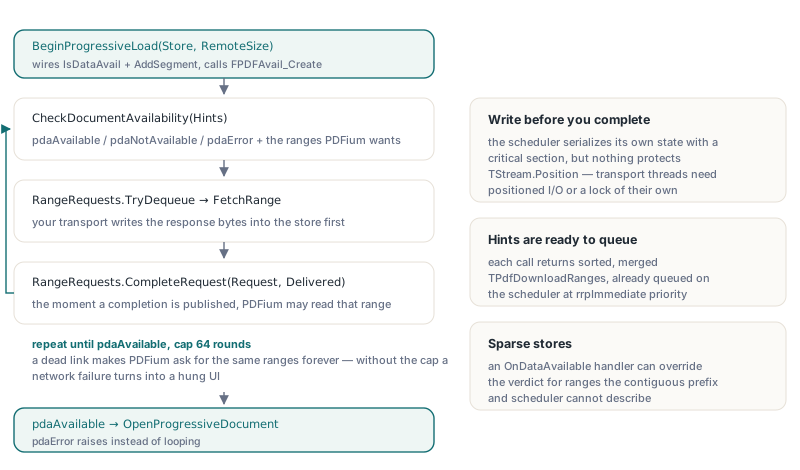
Nel PDFium Component l'intera sessione vive in TPdfProgressiveDocument, una sottoclasse di TPdf che tiene vivo un provider di disponibilità PDFium mentre uno stream ad accesso casuale si riempie. BeginProgressiveLoad(AStream, AFileSize, AOwnsStream, AInitialAvailableByteCount) prende lo stream di supporto e la dimensione logica del file remoto (il Content-Length, non la lunghezza corrente del vostro store locale), collega un callback IsDataAvail e un callback AddSegment, e chiama FPDFAvail_Create. Una volta che OpenProgressiveDocument riesce, l'oggetto si comporta come qualsiasi altro TPdf attivo: pagine, testo, rendering e salvataggio funzionano tutti attraverso i membri abituali
Ogni passo di parse è una domanda al vostro codice. Quando PDFium vuole un range, il componente risponde sì se il range giace dentro il prefisso contiguo descritto da AvailableByteCount, o dentro un range già completato attraverso lo scheduler RangeRequests. Un handler OnDataAvailable ha poi l'ultima parola, ed è così che una cache sparsa risponde per range che nessuno dei due può descrivere. CheckDocumentAvailability restituisce uno dei tre valori TPdfDataAvailability (pdaAvailable, pdaNotAvailable, pdaError) e consegna i range di byte che PDFium ha chiesto come array TPdfDownloadRanges ordinato e fuso. Quei range sono già in coda sul scheduler a priorità rrpImmediate quando li vedete, quindi l'array di hint serve per il log e la visualizzazione dell'avanzamento; la coda di lavoro è RangeRequests
// FetchRange è il vostro trasporto (HTTP Range GET, socket, lettura blob):
// scrive Size byte a Offset dentro Store e restituisce quanti sono arrivati
function FetchRange(Store: TStream; Offset, Size: UInt64): UInt64; forward;

procedure OpenWhileDownloading(Pdf: TPdfProgressiveDocument; Store: TStream;
  RemoteSize: UInt64);
const
  MaxRounds = 64;
var
  Hints: TPdfDownloadRanges;
  State: TPdfDataAvailability;
  Request: TPdfRangeRequest;
  Round: Integer;
begin
  Pdf.BeginProgressiveLoad(Store, RemoteSize, False);
  State := pdaNotAvailable;
  for Round := 1 to MaxRounds do
  begin
    State := Pdf.CheckDocumentAvailability(Hints);
    if State <> pdaNotAvailable then
      Break;
    // Gli hint sono già in coda; scrivete prima i byte, poi completate
    while Pdf.RangeRequests.TryDequeue(Request) do
      Pdf.RangeRequests.CompleteRequest(Request,
        FetchRange(Store, Request.Offset, Request.Size));
  end;
  if State <> pdaAvailable then
    raise EPdfError.Create('The document could not be discovered');
  Pdf.OpenProgressiveDocument;
end;
Due dettagli di quel ciclo portano peso. Il tetto dei round esiste perché un collegamento morto fa chiedere a CheckDocumentAvailability gli stessi range a ogni chiamata, e un ciclo illimitato trasforma un fallimento di rete in una UI appesa. L'ordine conta perché lo scheduler serializza il proprio stato con una sezione critica ma non fa nulla per TStream.Position sullo store di supporto. Un thread di trasporto deve scrivere i byte di risposta nello stream prima di chiamare CompleteRequest, dato che PDFium può leggere il range nell'istante in cui il completamento viene pubblicato. Scrittori concorrenti hanno bisogno di I/O posizionata o di un lock proprio
Perché AvailableByteCount rifiuta di andare indietro?
AvailableByteCount cresce solo. Assegnare un valore minore solleva EPdfError con "Available byte count cannot move backwards", perché una volta che il callback di disponibilità ha detto a PDFium che un range esiste, il parser può aver già letto e messo in cache oggetti da lì. Toglierli dopo lascerebbe PDFium con oggetti la cui sorgente le risposte di disponibilità ora negano. Lo stesso setter rifiuta valori maggiori di LogicalFileSize e solleva "No progressive load is active" fuori da una sessione
Quell'ultimo controllo decide dove appartengono i byte che già tenete. Se una visita precedente ha lasciato i primi 300 KB del file in una cache, passate quel conteggio come AInitialAvailableByteCount; il componente lo registra prima che FPDFAvail_Create giri, così il primo sguardo di PDFium all'header lo vede già. Con un conteggio iniziale di zero, Linearization legge plnUnknown finché PDFium non ha visto l'header; è lo stato di partenza normale
Alzare il prefisso annulla anche lavoro. Qualsiasi richiesta in volo che si sovrappone ai byte appena annunciati ora è ridondante, quindi lo scheduler la butta e fa scattare OnCancelRequest per lei; un CompleteRequest tardivo per quella richiesta restituisce False. Uno store che si riempie fuori ordine non dovrebbe cercare di esprimersi attraverso il prefisso. Completate i range attraverso lo scheduler, o rispondete per range in OnDataAvailable. Un'eccezione sollevata dentro quell'handler non può attraversare il confine del callback C, quindi il componente la intercetta e riporta il range come mancante, e PDFium semplicemente richiede al controllo successivo
Quando può aprirsi davvero un PDF scaricato a metà?
Solo un PDF linearizzato si apre prima che l'intero file sia arrivato. OpenProgressiveDocument controlla la proprietà Linearization (plnUnknown, plnNotLinearized, plnLinearized) e sceglie il loader. Un file linearizzato si apre attraverso FPDFAvail_GetDocument appena la sezione della prima pagina e le tabelle di hint sono presenti. Un file non linearizzato passa per FPDF_LoadCustomDocument sullo stesso record di accesso al file, e per tale file PDFium riporta il documento come disponibile solo quando c'è ogni byte. Quell'instradamento è ciò che tiene fuori dal vostro viewer l'handle a zero pagine del paragrafo d'apertura
Quindi il file sul server decide quanto veloce appare la prima pagina. Se il tempo al primo paint conta e controllate il lato publishing, linearizzate i file lì. TPdf.SaveAsLinearized scrive il layout dell'Allegato F dal componente stesso, e il percorso guidato Fast Web View e tabelle di hint copre cosa contiene quel layout. Per i file che non controllate, un PDF non linearizzato si carica comunque attraverso lo stesso ciclo; raggiunge solo pdaAvailable al 100 percento invece che presto
LoadAvailablePage prende un numero di pagina a base 1 e mantiene l'ordine che PDFium si aspetta. Prima del controllo della prima pagina esegue CheckFormAvailability, che avvolge FPDFAvail_IsFormAvail, e solo dopo chiama FPDFAvail_IsPageAvail. Un risultato pfaNotPresent è la risposta normale per un documento senza AcroForm e non blocca nulla. Quando la pagina è pronta, LoadAvailablePage la rende pagina attiva, così un viewer può renderizzare la pagina 1 di un opuscolo linearizzato mentre le pagine successive sono ancora in transito. L'attesa della pagina ha la stessa forma del primo listato: chiamate LoadAvailablePage, drenate RangeRequests su pdaNotAvailable, fermatevi su pdaAvailable o pdaError, e tenete un tetto di round. FirstAvailablePageNumber riporta la pagina che il dizionario di linearizzazione designa come prima, già convertita dall'indice a base zero di PDFium. Per un file non linearizzato ogni pagina riporta pdaAvailable subito, perché il documento poteva aprirsi solo una volta completato il file
Retry, letture corte e priorità nello scheduler dei range
L'API FPDFAvail_* in sé non sa nulla di reti. Dice quali byte il parser serve adesso e richiede di nuovo più tardi; non esiste nozione di richiesta, retry o cancel. TPdfRangeRequestScheduler fornisce quelle, e quattro delle sue regole plasmano come scrivete il trasporto
- Una risposta corta è trattata come avanzamento.
CompleteRequest(Request, BytesReceived)con meno byte di quelli richiesti pubblica il prefisso e mette in coda il resto. La risposta corta conta anche come tentativo fallito, quindi il resto resta comunque vincolato daMaxRetryCounte viene abbandonato quando si esaurisce; zero byte è un semplice tentativo fallito MaxRetryCountfa default a 2, quindi un range riceve tre tentativi in totale.FailRequestrestituisceTruequando ha rimesso in coda il range eFalseuna volta che il range è abbandonato;Statistics.AbandonedRequestCounttiene il conto di quanti hanno mollatoMaxRequestSizespezza i range grandi in chunk al momento del dequeue, eMergeGappermette a due range in attesa di fondersi attraverso una piccola lacuna sconosciuta, ma mai attraverso byte già completati o in volo- Gli hint da
CheckDocumentAvailabilityeLoadAvailablePagearrivano arrpImmediate. Gli hint del modulo da una chiamata diretta aCheckFormAvailabilityarrivano arrpNormal; quandoLoadAvailablePageesegue quel controllo da sé e i dati del modulo mancano, gli hint vengono messi in coda arrpImmediate.TryDequeueserve sempre prima la priorità più alta e l'offset più basso dentro una priorità
La regola di priorità si ripaga quando fate prefetch. Mettete in coda l'intero file a rrpBackground subito dopo l'apertura del documento, e lo scheduler sottrae tutto ciò che è già completato o in volo, così solo i byte mancanti vanno sul filo. Quando l'utente poi salta alla pagina 40 e l'hint di quella pagina si sovrappone a un chunk in background già in scaricamento, lo scheduler ritira la richiesta in background, fa scattare OnCancelRequest per lei, rimette le code non sovrapposte a priorità background senza addebitare un retry, e mette in coda la sovrapposizione come lavoro immediato fresco. Il salto vince la connessione. Senza di ciò, la richiesta di pagina aspetterebbe dietro un chunk da 256 KB di cui non gli importa niente
procedure TDownloadForm.QueueRestOfFile;
var
  Whole: TPdfDownloadRanges;
begin
  FPdf.RangeRequests.MaxRequestSize := 256 * 1024;  // la dimensione del chunk decide voi
  SetLength(Whole, 1);
  Whole[0].Offset := 0;
  Whole[0].Size := FPdf.LogicalFileSize;
  FPdf.RangeRequests.EnqueueHints(Whole, rrpBackground);
end;

// Chiamata su un worker thread quando una risposta HTTP Range finisce.
// WriteAt è la vostra scrittura posizionata nello store di supporto
procedure TDownloadForm.RangeFinished(const Request: TPdfRangeRequest;
  const Body: TBytes; Succeeded: Boolean);
begin
  if Succeeded and (Length(Body) > 0) then
  begin
    WriteAt(FStore, Request.Offset, Body);              // prima i byte
    FPdf.RangeRequests.CompleteRequest(Request, Length(Body));
  end
  else if not FPdf.RangeRequests.FailRequest(Request) then
    TThread.Queue(nil, ShowRangeGaveUp);  // abbandonata, o di una sessione cancellata
end;
Sia CompleteRequest sia FailRequest sono sicure da chiamare dal worker thread; lo scheduler prende il proprio lock. Una richiesta superata o appartenente a una sessione cancellata torna come False senza toccare niente, così il worker non ha bisogno di sapere perché il suo range sia diventato stantio
Che cosa rilascia CancelProgressiveLoad, e in che ordine?
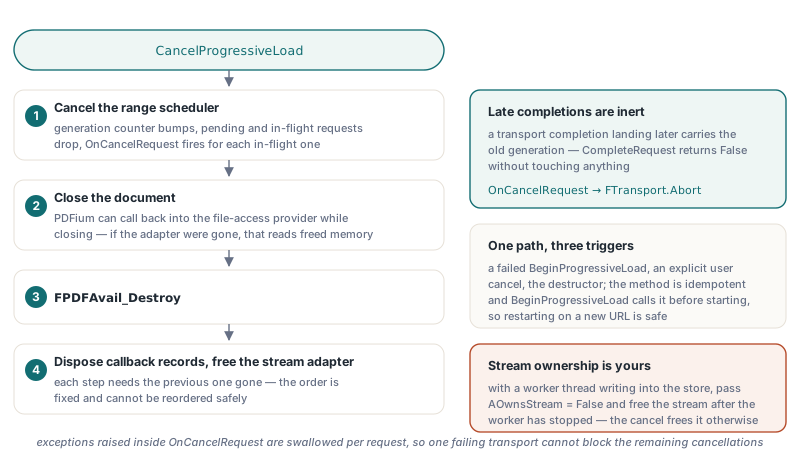
CancelProgressiveLoad smonta una sessione in quattro passi, sempre nello stesso ordine: cancella lo scheduler dei range, chiude il documento, distrugge l'handle di disponibilità con FPDFAvail_Destroy, poi rilascia i record dei callback e l'adattatore di stream. Cancellare prima lo scheduler fa avanzare il suo contatore di generazione, butta ogni richiesta in attesa e in volo, e fa scattare OnCancelRequest per ognuna in volo. Un completamento di trasporto che atterra dopo porta la vecchia generazione, e CompleteRequest restituisce False. Il documento si chiude prima che l'handle di disponibilità e l'adattatore di stream vadano via perché PDFium può ancora leggere attraverso il provider di accesso al file mentre chiude un documento
procedure TDownloadForm.FormCreate(Sender: TObject);
begin
  FPdf := TPdfProgressiveDocument.Create(nil);
  // Lo scheduler vive quanto FPdf, quindi collegatelo una volta sola
  FPdf.RangeRequests.OnCancelRequest := RangeCancelled;
end;

procedure TDownloadForm.RangeCancelled(Sender: TObject; RequestId: UInt64;
  Attempt: Cardinal);
begin
  FTransport.Abort(RequestId);   // codice vostro: chiudete quel socket o richiesta
end;

procedure TDownloadForm.CancelButtonClick(Sender: TObject);
begin
  FPdf.CancelProgressiveLoad;
  // ProgressiveLoading = False, Active = False, AvailableByteCount = 0
end;
Il metodo è idempotente e serve come unico percorso di pulizia per tre situazioni: una BeginProgressiveLoad che fallisce a metà della costruzione, un cancel esplicito dell'utente, e il distruttore. Anche BeginProgressiveLoad lo chiama, quindi riavviare lo stesso oggetto su un nuovo URL va bene finché la sessione precedente non è mai arrivata ad aprire. Una volta che OpenProgressiveDocument è riuscito l'oggetto è attivo, e BeginProgressiveLoad solleva il solito errore "Cannot perform this operation on an active"; chiamate prima CancelProgressiveLoad. OnCancelRequest è inoltre l'unico posto dove i vostri socket vengono chiusi, visto che lo scheduler non ha idea di cosa sia un socket. Le eccezioni sollevate dentro di lui vengono inghiottite per richiesta, quindi un abort che fallisce non può bloccare gli altri
Chi scrive lo store decide chi lo possiede. Con un worker thread che scrive nello stream di supporto, passate AOwnsStream = False e liberate voi lo stream dopo che il worker si è fermato. Consegnare la proprietà significa che il cancel libera lo stream mentre una scrittura già in corso può essere ancora in viaggio. Tenete la proprietà ogni volta che un thread diverso dal chiamante tocca lo store; AOwnsStream = True sta bene solo a un trasporto completamente sincrono come il primo listato
Funzioni che aspettano l'intero file
Alcune funzioni hanno bisogno dei byte del file originale, non del documento analizzato, e rifiutano seccamente una sorgente progressiva incompleta. ReadXmpPacket solleva "PDF/A metadata is unavailable until progressive loading completes". ValidatePades restituisce un risultato il cui SourceStatus è pvssIncomplete, e ValidatePdfMac riporta unsupported con un messaggio che chiede la sorgente completa. Anche BeginIncrementalSave fallisce, perché un incremental update deve accodarsi ai byte esatti che sono stati caricati
Il test di completezza dietro a tutti è AvailableByteCount che raggiunge LogicalFileSize. Un trasporto che consegna tutto attraverso lo scheduler può quindi tenere ogni byte ed essere comunque avvisato che la sorgente è incompleta, perché il prefisso contiguo non si è mai mosso. Pubblicate il prefisso una volta che lo scheduler conferma la copertura completa:
procedure TDownloadForm.CheckSignaturesWhenComplete;
var
  Report: TPadesValidationResult;
begin
  if FPdf.RangeRequests.IsRangeAvailable(0, FPdf.LogicalFileSize) then
    FPdf.AvailableByteCount := FPdf.LogicalFileSize;
  Report := FPdf.ValidatePades;
  if Report.SourceStatus = pvssIncomplete then
    LabelStatus.Caption := 'Signatures are checked when the download finishes'
  else
    ShowSignatureReport(Report);   // la vostra UI
end;
Un solo limite di dimensione si applica prima che qualsiasi cosa cominci. Su Windows FPDF_FILEACCESS conserva la lunghezza del file in un campo a 32 bit, quindi BeginProgressiveLoad rifiuta una dimensione logica sopra 4 GiB con un EPdfError anziché lasciare che PDFium analizzi una lunghezza troncata
Per caricare su richiesta un file locale completo attraverso un adattatore di stream, vedere streaming di PDF grandi su domanda con PDFium; per un PDF che sta dentro un buffer più grande, vedere il byte range loading per PDF incorporati. Fermare un render lento di una pagina già arrivata è un meccanismo diverso, coperto in il rendering di pagine progressivo cancellabile. TPdfProgressiveDocument, il suo scheduler dei range e SaveAsLinearized fanno parte del PDFium Component per Delphi e C++Builder