Con il controllo di overflow spento, 2000000000 + 2000000000 vale -294.967.296 quando entrambi gli operandi sono Integer Delphi. Quel numero smette di essere curiosità nel momento in cui un parser di container legge un offset e una lunghezza dall'header di un record e li somma per vedere se un PDF incorporato sta dentro il buffer. La somma va in wrap verso il negativo, il confronto con Length(Data) passa, e la riga successiva prende l'indirizzo di un byte circa due gigabyte oltre la fine dell'array. Caricare un PDF dal mezzo di un buffer più grande richiede un range check che non somma mai, e una risposta chiara su chi possiede i byte una volta che il documento è aperto
Questo articolo copre i documenti che sono già in RAM, seduti a un offset noto dentro qualcos'altro. I documenti troppo grandi da tenere in memoria sono un problema diverso, gestito tirando blocchi da disco a richiesta come descritto in streaming di PDF grandi on demand con PDFium VCL. L'ultima sezione traccia la linea
Un PDF incorporato a un offset noto
Uno store di posta tiene corpi dei messaggi e allegati in un unico record. Un contenitore di archivio concatena un manifest, qualche immagine e un PDF. Un protocollo di rete custom incornicia un documento dietro a un header con prefisso di lunghezza. Supponiamo che il record sia da 40 MB, il PDF parta al byte 1.182.336 e corra per 312 KB. Il codice abituale chiama Copy(Data, Index, Count) per tagliare una fetta, poi consegna quella fetta a un loader che la copia di nuovo nel proprio buffer. Contando il contenitore, gli stessi 312 KB ora esistono tre volte, e una scansione della casella di posta lo ripete per ogni messaggio
PDFium Component indirizza la finestra direttamente. TPdf dichiara LoadDocument(const Data: TBytes; Index, Count: Integer; Buffered: Boolean = True), dove Index è una posizione di byte a base zero e Count una lunghezza in byte. Il metodo valida entrambi i numeri, calcola un singolo puntatore, e inoltra all'overload a puntatore LoadDocument(Data: Pointer; Size: NativeUInt; Buffered: Boolean), che apre il documento tramite FPDF_LoadMemDocument64. La forma a intero array LoadDocument(const Data: TBytes; Buffered: Boolean) è una chiamata di una riga alla forma per byte range con 0 e Length(Data), quindi ogni caricamento di TBytes passa per la stessa validazione
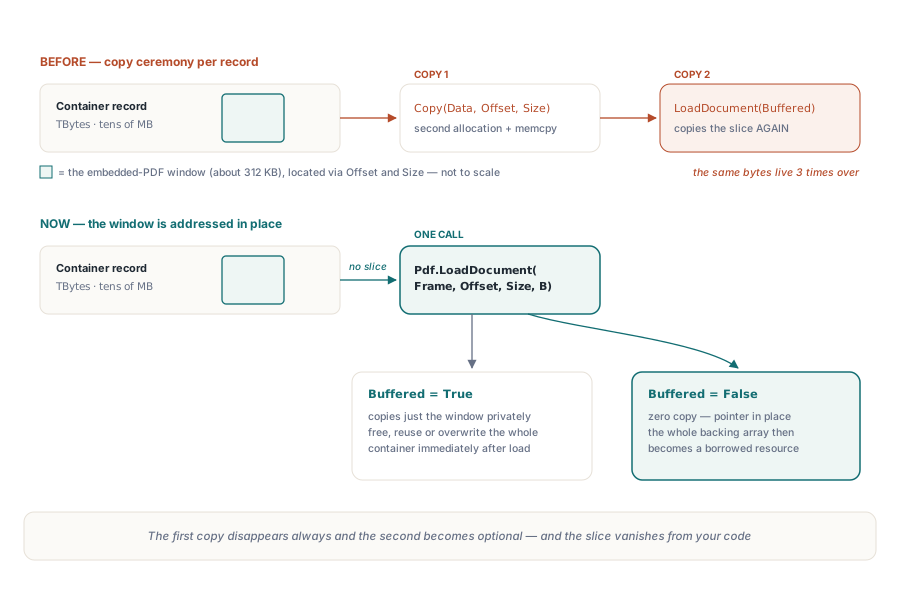
In codice, la fetta semplicemente sparisce. LocateEmbeddedPdf sta per il vostro parser di container
uses
  System.SysUtils, System.IOUtils, PDFium;

procedure PreviewEmbedded(const RecordFile: string);
var
  Frame: TBytes;           // intero record contenitore, decine di megabyte
  Offset, Size: Integer;
  Pdf: TPdf;
begin
  Frame := TFile.ReadAllBytes(RecordFile);
  LocateEmbeddedPdf(Frame, Offset, Size);   // il vostro parser, non fa parte del componente

  Pdf := TPdf.Create(nil);
  try
    // Niente Copy(Frame, Offset, Size): la finestra è indirizzata sul posto
    Pdf.LoadDocument(Frame, Offset, Size);  // Buffered vale True per default
    Frame := nil;  // va bene qui: è stata copiata solo la finestra del PDF
    Writeln('Pages: ', Pdf.PageCount);
  finally
    Pdf.Free;      // chiude il documento
  end;
end;
Quando il globale EnableV8Engine è ancora False e la libreria PDFium non è stata ancora caricata, i loader da memoria scandagliano i byte in ingresso in cerca di marker XFA e accendono EnableV8Engine se ne trovano, così viene caricata la DLL con V8. Con la chiamata per byte range quella scansione vede solo la finestra. Un manifest o un secondo documento altrove nello stesso record non può attivarla
Perché Index più Count va in overflow nel controllo dei limiti?
Perché Index e Count sono entrambi Integer a 32 bit con segno, e sommare due grandi positivi non produce in modo affidabile un grande positivo. Dove offset e lunghezza vengono da un header di file, un attaccante o un record corrotto controlla entrambi. La stessa trappola aspetta nel vostro parser di container, che calcola quei numeri per primo
// Un helper per il vostro parser di container (suggerito, non fa parte del componente)
function IsValidWindow(const Data: TBytes; Index, Count: Integer): Boolean;
begin
  // SBAGLIATO: Index + Count viene valutato come Integer e può andare in wrap negativo
  //   Result := (Index >= 0) and (Index + Count <= Length(Data));

  // GIUSTO: rifiuta i segni, vincola Index da solo, poi confronta Count
  // con il resto; l'unica aritmetica è una sottrazione che non può andare in wrap
  Result := (Index >= 0) and (Count >= 0) and
            (Index <= Length(Data)) and
            (Count <= Length(Data) - Index);
end;
Ripercorrete il caso che fallisce. Con Index = 2000000000 e Count = 2000000000, la somma vera è quattro miliardi, ma l'aritmetica con segno a 32 bit la memorizza come -294.967.296. Quel valore sta comodamente sotto qualunque Length(Data), quindi il controllo sbagliato passa e @Data[Index] punta ben fuori dall'array, con una lunghezza di due gigabyte appiccicata. Un crash è l'esito buono. Quello cattivo è PDFium che parsa qualunque memoria di processo capiti a trovarsi lì
L'ordine corretto non somma mai. I valori negativi vengono rifiutati prima che qualsiasi cosa venga indicizzata. Index viene poi vincolato contro Length(Data) da solo, il che garantisce che Length(Data) - Index sia un Integer non negativo, e solo allora Count viene confrontato con quel resto. Delphi valuta and con logica short-circuit per default ({$B-}), quindi ogni termine successivo gira solo quando i precedenti tengono. Non appoggiatevi a {$Q+} come rete di sicurezza: le build di rilascio navigano di regola con il controllo di overflow spento, e con esso acceso avete solo scambiato un buco di memory safety per un EIntOverflow che sfuga dal mezzo di una routine di validazione
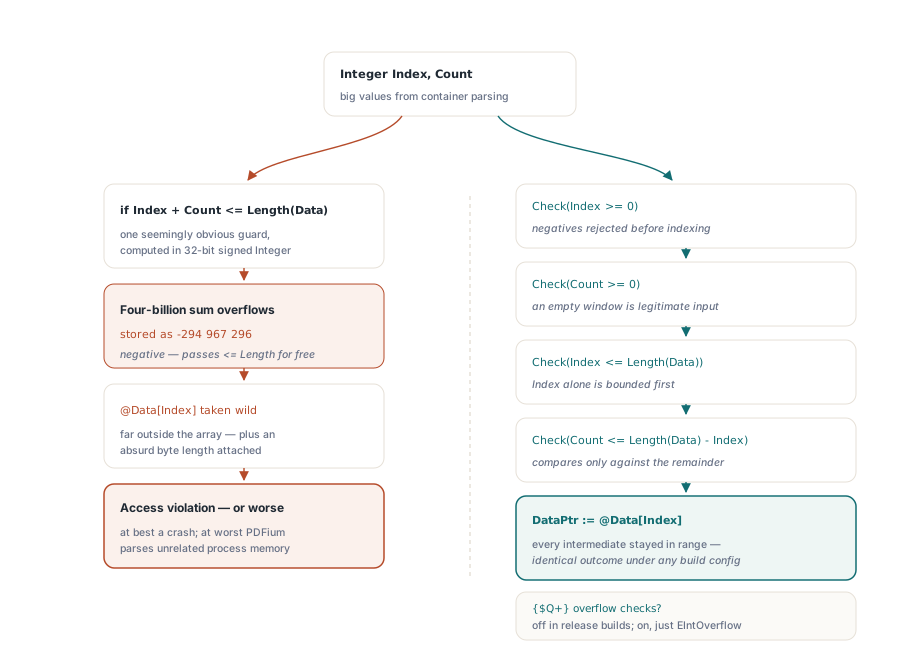
Il LoadDocument per byte range esegue gli stessi quattro test nello stesso ordine e solleva EPdfError con un messaggio che nomina la regola fallita: "PDF byte range index cannot be negative", "PDF byte range count cannot be negative", "PDF byte range index exceeds data length" e "PDF byte range exceeds data length". Potete riprodurre ognuno con un array di quattro byte. Index = 5, Count = 0 fa scattare il terzo messaggio, Index = 2, Count = 3 il quarto, e dopo ogni rifiuto Pdf.Active resta False. Lo stesso trattamento delle lunghezze non fidate attraverso il confine nativo è trattato più in generale in hardening dell'ABI PDFium VCL e memory safety in Delphi
Una finestra a lunghezza zero resta una chiamata legale
Una finestra vuota passa un puntatore nil, perché @Data[Index] non è un'espressione legale per ogni Index che la validazione accetta. Index = Length(Data) con Count = 0 è una finestra vuota ben formata alla coda del buffer, e un TBytes vuoto dà Index = 0 su un array che non ha nessun elemento zero. Prendere l'indirizzo in entrambi i casi legge oltre la fine o dereferenzia un array dinamico nil, e col range checking acceso Delphi solleva ERangeError prima ancora che il loader giri
Quindi l'overload per byte range si ramifica: Count = 0 produce nil, qualunque altro conteggio produce @Data[Index]. L'overload a puntatore accetta nil solo insieme a una dimensione di zero, PDFium poi declina di aprire un buffer vuoto, e la chiamata finisce in un ordinario EPdfError che porta il testo last-error di PDFium, o "Cannot load PDF document" quando PDFium non ne riporta alcuno. Un header che dichiara un allegato di zero byte riceve la stessa eccezione catturabile di qualsiasi altro input cattivo. Rifiutarlo nel vostro parser, col numero di record nel messaggio, resta comunque più leggibile in un log di supporto
Buffered decide chi possiede i byte
Buffered è l'unico parametro qui le cui conseguenze sopravvivono alla chiamata. Con Buffered = True, il componente copia la finestra selezionata, e solo la finestra, nel proprio buffer prima di caricare. Nell'esempio da 40 MB vengono copiati 312 KB e il contenitore resta in pace. Una volta che LoadDocument è tornato, potete liberare, riusare o sovrascrivere il contenitore subito
Con Buffered = False, @Data[Index] va dritto a FPDF_LoadMemDocument64, e PDFium continua a leggere attraverso quel puntatore finché il documento è aperto. L'intero TBytes di appoggio diventa preso in prestito. Deve restare vivo e non modificato finché non impostate Active := False o non liberate il TPdf. Conta l'intero array, non solo la finestra: un array dinamico Delphi è reference counted come un blocco unico, quindi far cadere l'ultimo riferimento dove sia nel vostro codice libera la memoria che PDFium sta ancora leggendo. SetLength è altrettanto fatale. Una riallocazione può spostare il blocco
Due dettagli Delphi rendono l'errore più facile di quanto sembri. Gli array dinamici non hanno copy-on-write, a differenza delle stringhe, quindi Other := FFrame; Other[0] := 0; scrive proprio nei byte che PDFium sta parsando. E un buffer di ricezione che il vostro codice di rete riusa per il frame successivo viene sovrascritto sotto al documento aperto. Passare dritto il risultato di una funzione, come in Pdf.LoadDocument(ReadRecord(Id), Offset, Size, False), lascia l'array tenuto solo da un temporaneo nascosto che muore con la routine chiamante, mentre il documento continua a vivere
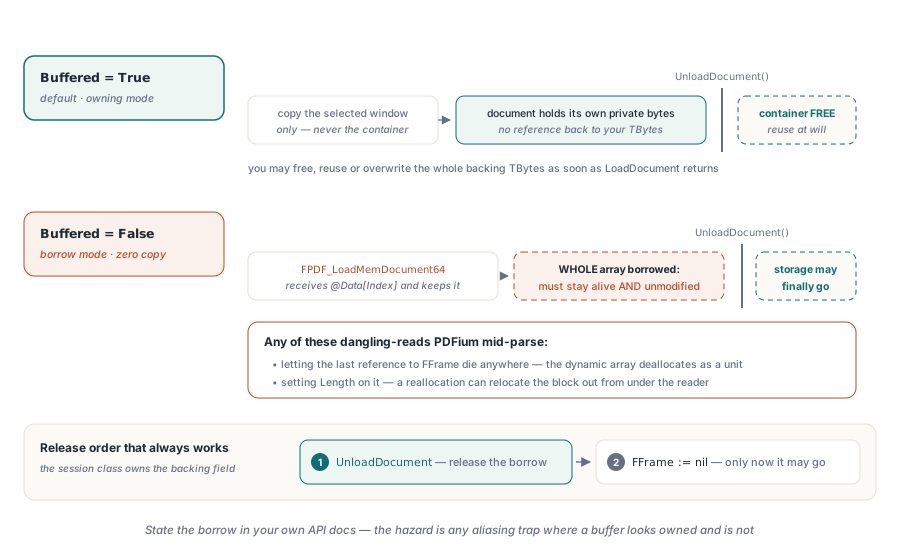
Tenete Buffered = True per qualsiasi cosa attraversi un thread, stia dietro a un buffer riutilizzabile, o sopravviva alla routine che l'ha caricato. Il costo extra è una copia della dimensione del PDF, e compra la libertà di buttare un record da 40 MB nel momento in cui la chiamata ritorna. Il prestito si guadagna il posto solo quando il contenitore è già un campo di lunga vita che tenete comunque per tutta la sessione, come un viewer che tiene aperto un record di archivio mentre l'utente sfoglia l'allegato. In quel caso, rendete la proprietà esplicita in una sola classe
type
  TFrameSession = class
  private
    FFrame: TBytes;   // possiede lo storage di appoggio finché FPdf ha un documento aperto
    FPdf: TPdf;
  public
    constructor Create(const AFrame: TBytes);
    destructor Destroy; override;
    procedure OpenEmbedded(Offset, Size: Integer);
  end;

constructor TFrameSession.Create(const AFrame: TBytes);
begin
  inherited Create;
  FFrame := AFrame;   // condivide l'array; nessun altro può scriverci ora
  FPdf := TPdf.Create(nil);
end;

procedure TFrameSession.OpenEmbedded(Offset, Size: Integer);
begin
  FPdf.Active := False;                            // chiudi prima ogni finestra precedente
  FPdf.LoadDocument(FFrame, Offset, Size, False);  // FFrame deve sopravvivere a questo documento
end;

destructor TFrameSession.Destroy;
begin
  FPdf.Active := False;  // 1. rilascia il prestito
  FPdf.Free;
  FFrame := nil;         // 2. solo ora può andarsene lo storage
  inherited;
end;
Il costruttore condivide l'array del chiamante invece di copiarlo, quindi il chiamante deve smettere di scriverci. Se non potete prometterlo, passate Copy(AFrame) al costruttore e tornate a una copia, fatta una volta per sessione invece che una volta per caricamento
Controllare che la finestra parta da %PDF-
Una finestra sbagliata di qualche byte è il fallimento sottile, perché il documento può comunque aprirsi. ISO 32000-1 §7.5.4 definisce ogni voce della cross-reference come un offset di byte dall'inizio del file, e §7.5.2 mette l'header %PDF- all'inizio. Quando il vostro parser conta male un prefisso e la finestra comincia otto byte prima, quegli offset sono sbagliati di otto byte. PDFium cerca l'header entro i primi 1024 byte e compensa il junk iniziale; una finestra che parte tardi o finisce presto può spingerlo a ricostruire la cross-reference table dai marker di oggetto che trova. In entrambi i casi il conteggio pagine sembra giusto. L'offset nel vostro parser è comunque sbagliato, e il prossimo lettore di quel record potrebbe essere meno indulgente
L'overload LoadDocument(const Data: TBytes; Index, Count: Integer; const Options: TPdfLoadOptions; out Report: TPdfLoadReport; Buffered: Boolean = True) rende ciò visibile. Report.HeaderOffset è dove %PDF- è stato trovato entro i primi 1024 byte della finestra, o -1 quando non è stato trovato. Report.UsedRecovery è True quando PDFium non ha accettato la cross-reference table come valida. Tutti gli offset nel report contano dal primo byte della finestra, non dal contenitore. Un Count troppo corto taglia via il %%EOF finale, e TPdfLoadOptions.Default(plmStrict) accende RequireFinalEndOfFileMarker, quindi la modalità rigorosa rifiuta quella finestra in blocco
var
  Options: TPdfLoadOptions;
  Report: TPdfLoadReport;
begin
  Options := TPdfLoadOptions.Default;   // plmCompatible
  Pdf.LoadDocument(Frame, Offset, Size, Options, Report, True);

  // LogWarning è la vostra routine di logging
  if Report.HeaderOffset > 0 then
    LogWarning(Format('Window starts %d bytes before %%PDF-, check Offset',
      [Report.HeaderOffset]))
  else if Report.HeaderOffset < 0 then
    LogWarning('No %PDF- header in the first 1024 bytes of the window');

  if Report.UsedRecovery then
    LogWarning('Cross-reference table was rebuilt, check Offset and Size');
end;
L'audit dietro quei campi ha un costo che conta per i caricamenti presi in prestito. Quando la finestra sta entro Options.AuditByteLimit (256 MB per default), l'audit legge una copia temporanea della finestra, quindi Buffered = False combinato con un report non è più copy-free durante il caricamento. Impostare AuditByteLimit a 0 salta l'audit e la copia, e lascia HeaderOffset a -1. Usate la forma con audit mentre sviluppate il parser di container e contro nuove sorgenti di record; passate all'overload semplice una volta che gli offset sono fidati. Il resto del report è trattato in catturare i fallimenti di caricamento PDF con un load report PDFium
Quando un byte range è lo strumento sbagliato
L'overload per byte range presuppone che l'intero contenitore sia già in memoria, e poiché Count è un Integer, una finestra non può superare MaxInt byte. Un archivio da 6 GB su disco, o un socket che non potete riavvolgere, non entra in quella forma, e leggere tutto in TBytes solo per indirizzare una finestra dentro sconfigge lo scopo. Per quei casi LoadCustomDocument(AStream: TStream; AOwnsStream: Boolean) lascia che PDFium tiri blocchi da uno stream seekable a richiesta. Un piccolo discendente TStream vostro che aggiunge l'offset di partenza del PDF a ogni Seek presenta il documento incorporato come se iniziasse alla posizione zero, come mostra l'articolo sullo streaming on demand
L'altro disallineamento è contenuto che non è ancora un PDF semplice. Se i byte incorporati sono compressi, cifrati dal contenitore, o avvolti in un'altra codifica, una copia trasformata è inevitabile, e caricare quel nuovo array con il default Buffered = True è la risposta diretta. Il byte range ripaga in una sola forma: byte PDF contigui e non modificati, già residenti, a un offset che il vostro parser ha validato senza sommare
La chiamata per byte range siede accanto al caricamento da file, stream, puntatore grezzo e on demand nello stesso componente TPdf. La pagina del prodotto PDFium Component elenca le versioni Delphi e C++Builder supportate, le opzioni di licenza e il resto dell'API di caricamento