Un batch di scansioni può essere nient'altro che un JPEG per pagina, senza font, senza annotazioni e senza segnalibri, e fallire comunque come PDF/raster. ISO 23504-1 chiede più al file delle sole pagine raster-only: deve identificarsi con un commento %PDF-raster-1.0 nell'area del trailer, portare metadati XMP e un /ID nel trailer, e tenere il proprio catalogo e dizionario Info su brevi liste permesse. Controllare un batch di acquisizione richiede quindi due letture diverse, una sui byte grezzi e una su ciò che ogni pagina disegna davvero
Due letture dello stesso file
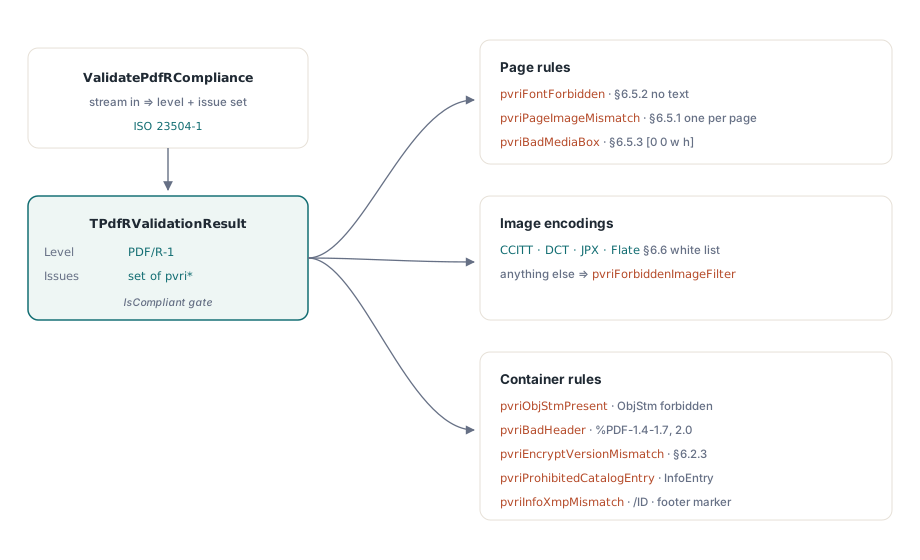
La validazione PDF/R e SaveAsPdfR viaggiano con le edizioni Small Business ed Enterprise di PDFium Component, che divide la validazione lungo quella linea. ValidatePdfRCompliance nell'unità FPdfPdfr legge uno stream e controlla le regole a livello di byte: versione dell'header, marker raster, object stream, voci di catalogo e Info, XMP, /ID del trailer, origini della MediaBox, risorse font, nomi di filtri vietati e se il numero di oggetti immagine corrisponde al numero di pagine. ValidatePdfRPageFacts controlla una pagina alla volta a partire da un record TPdfRPageFacts: quanti oggetti testo, path, form e shading disegna la pagina, dove siede la singola strip image, la sua dimensione in pixel, profondità di bit, spazio colore e catena di filtri
Entrambe le letture riferiscono attraverso un'unica enumerazione, TPdfRValidationIssue, e i punti di ingresso combinati le fondono in un solo TPdfRValidationResult. Il suo campo Conformance diventa prc1 solo quando il marker raster viene trovato, e IsCompliant restituisce True solo quando il livello è prc1 e l'insieme di problemi è vuoto. Un file perfetto in ogni altro rispetto ma privo del marker riferisce prcNone, il che sorprende la gente la prima volta che ci passa una scansione pulita
La domanda è da dove vengano i fatti di pagina. TPdf.ValidatePdfR li raccoglie dal documento caricato, ma prima serializza quel documento in uno store temporaneo ed esegue i controlli byte sulla copia ri-salvata, così i veredetti su marker e catalogo descrivono un salvataggio fresco, che può differire dal file su disco. ValidatePdfRasterSource in FPdfBusinessWorkflows prende un solo snapshot dello stream di input ed esegue entrambe le letture contro di lui. Per un file che sta per entrare in un archivio è la chiamata da usare: il veredetto si riferisce allora ai byte che vengono archiviati
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // il budget predefinito è 64 MiB
  Options.Validation.MinimumResolutionDpi := 200; // il nostro contratto di acquisizione
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues tiene i problemi a livello di byte più ogni problema di pagina
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues dice quali pagine riscansionare
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Tenete il veredetto leggibile dalle macchine accanto al file archiviato
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Due predefiniti in TPdfRasterSourceValidationOptions contano per i batch di scansioni. MaxInputBytes è 64 MiB e MaxPages è 1000; un lungo batch di scansioni a colori può superare il budget di byte, e il controllo finisce allora con stato prssBudgetExceeded e Complete False. MemoryLimitBytes è 8 MiB, oltre il quale lo snapshot trabocca in TemporaryDirectory e il report imposta SnapshotSpilled. Report.IsCompliant richiede anche Complete, quindi un controllo fermato a metà non viene mai letto come un passaggio
Perché un layer di testo OCR fallisce PDF/R?
Perché una pagina raster disegna l'immagine scansionata e nient'altro. Un layer OCR invisibile è un'aggiunta normale in un flusso PDF/A, e mette nel file due cose che PDF/R esclude: una risorsa font, riferita dalla lettura byte come pvriFontForbidden, e oggetti testo sulla pagina, riferiti dalla lettura di pagina come pvriNonRasterPageContent. Lo stesso problema di pagina scatta per path vettoriali, shading e form XObjects, così un numero di pagina timbrato o un bordo disegnato fallisce allo stesso modo del testo nascosto
La relazione pagina-immagine è severa anche lei. Ogni pagina deve portare esattamente una strip image; pvriPageImageMismatch scatta su una pagina senza immagine e su una pagina la cui scansione è stata scritta come due immagini affiancate. Sul lato byte il conteggio è preso su ogni oggetto il cui /Subtype è /Image, quindi ogni oggetto immagine extra, una soft mask attaccata alla strip per esempio, spinge il totale oltre il numero di pagine
La geometria riceve due controlli. pvriBadMediaBox riferisce una MediaBox che non inizia a [0 0 ...]; la lettura byte ispeziona gli array numerici inline. La lettura di pagina confronta poi i bordi disegnati della strip con la MediaBox e riferisce pvriStripGeometryInvalid quando un bordo è fuori di più di GeometryTolerancePoints, 0.5 punto per predefinito. Un driver di scanner che lascia un margine bianco ridimensionando l'immagine al 98% della pagina fallisce qui, anche se la pagina sembra a posto sullo schermo. Impostare RequireFullPageStrip a False spegne il test di copertura per i file interni dove un margine è accettabile
Quali codifiche di immagine passano
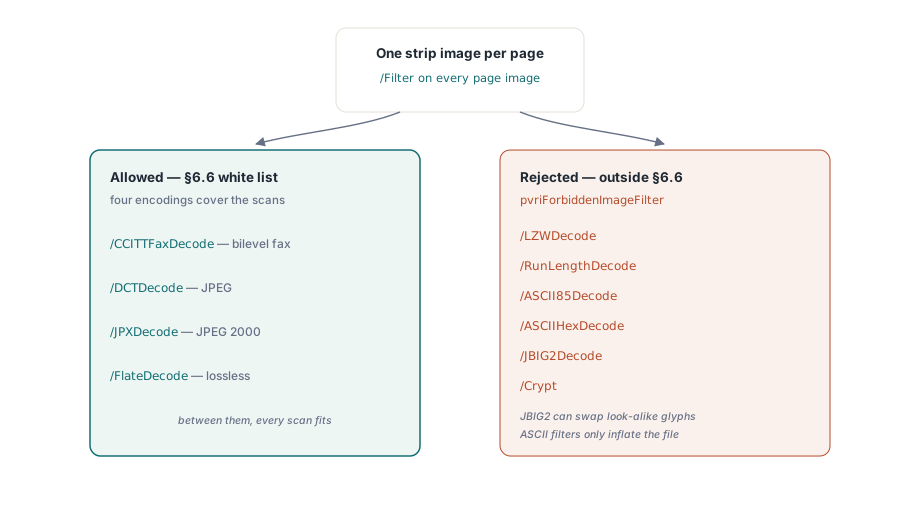
Il validatore accetta quattro filtri di strip: /CCITTFaxDecode, /DCTDecode, /JPXDecode e /FlateDecode. La lettura byte segnala gli altri filtri standard per nome come pvriForbiddenImageFilter: /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode e /Crypt
JBIG2 è il rifiuto che le squadre di acquisizione beccano per prime. È permesso in PDF/A e comprime le pagine bilevel molto bene, così un profilo di acquisizione costruito per PDF/A può già emetterlo. La sua modalità lossy di pattern matching è anche nota per sostituire un glifo scansionato con uno simile, un problema documentato con le cifre nei moduli scansionati, e un archivio raster esiste proprio perché ciò che era su carta sia ciò che è nel file. Ricodificare quelle pagine come CCITT Group 4 le tiene bilevel e lossless
La lettura di pagina fa un passo in più e guarda la catena di filtri insieme alla profondità di bit e allo spazio colore dell'immagine, riferendo le discrepanze come pvriImageCompressionParametersInvalid:
- Una catena di più di un filtro viene rifiutata, così un'immagine Flate avvolta in ASCII85 fallisce due volte, una sul lato byte e una qui
/CCITTFaxDecodedeve stare su una strip DeviceGray a 1 bit/DCTDecodedeve stare su una strip a 8 o 24 bit in DeviceGray o DeviceRGB/FlateDecodeè accettato sulle strip a 1 bit; una pagina Flate a 24 bit fallisce questo controllo/JPXDecodeè accettato a 1, 8 o 24 bit per pixel
Indipendentemente dal filtro, una strip il cui spazio colore non è né DeviceGray né DeviceRGB riceve pvriImageColorInvalid. Una scansione basata su ICC o CMYK va quindi convertita prima di essere incartata, e il posto più economico per farlo è il profilo dello scanner, prima che venga scritto qualsiasi PDF
Come viene calcolata la risoluzione della strip
Quando l'immagine porta la propria risoluzione, la lettura di pagina la usa. Quando non la porta, la risoluzione effettiva è derivata da pixel e dimensione di pagina: larghezza in pixel per 72 diviso larghezza MediaBox in punti, e lo stesso per l'altezza. Supponete che uno scanner scriva una strip di 2550 per 3300 pixel su una pagina US Letter da 612 per 792 punti. Viene esattamente 300 dpi in entrambe le direzioni. La stessa pagina a 600 per 776 pixel viene circa 70.6 dpi in orizzontale, sotto il minimo predefinito di 72, così la pagina riceve pvriImageResolutionInvalid
L'intervallo predefinito in TPdfRValidationOptions è da 72 a 2400 dpi. Quei limiti beccano solo le pagine evidentemente rotte. Un contratto di acquisizione di solito promette un minimo specifico, spesso 200 o 300 dpi, e quel valore appartiene a MinimumResolutionDpi: una pagina a 150 dpi passa l'intervallo predefinito, ed è esattamente la pagina che quel contratto era scritto per escludere. Impostare uno dei due limiti a 0 spegne quel lato del controllo
ValidatePdfRPageFacts è pubblico, quindi le stesse regole possono girare prima che esista qualsiasi PDF, direttamente da ciò che lo scanner riferisce su ogni immagine:
uses
  FPdfPdfr;

// Costruisce i fatti di pagina dall'output dello scanner; questo helper è vostro, non fa parte della libreria
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // la strip copre tutta la pagina
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi lasciato a 0: derivato
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // JPEG a colori 300 dpi su Letter: insieme vuoto
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // Stessa pagina compressa con Flate a 24 bit:
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Catalogo, dizionario Info e XMP
Oltre ai richiesti /Type e /Pages, ISO 23504-1 permette solo Version, ViewerPreferences, PageLayout, PageMode, AcroForm e Metadata nel catalogo. Il validatore controlla il catalogo contro le 21 chiavi standard fuori da quell'insieme e solleva pvriProhibitedCatalogEntry quando compare una qualsiasi, fra cui Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties e OutputIntents. L'ultima conta in pratica: un file PDF/A porta sempre un output intent, così un solo file non può soddisfare entrambi i profili
Il dizionario Info può tenere Creator, Producer, CreationDate e ModDate; Title, Author, Subject, Keywords e Trapped sollevano pvriProhibitedInfoEntry. Un catalogo senza stream /Metadata riceve pvriMissingXmpMetadata. Quando lo stream c'è ma il suo XMP non ha una qualsiasi fra xmp:CreateDate, xmp:ModifyDate e xmp:MetadataDate, il riscontro è pvriMetadataInvalid. pvriInfoXmpMismatch confronta Producer con pdf:Producer e Creator con xmp:CreatorTool. Le date sono escluse da quel confronto perché le due codifiche differiscono legittimamente, e i valori Info memorizzati come stringhe esadecimali vengono saltati. Un tipico innesco è uno strumento successivo che riscrive il Producer dell'Info senza toccare l'XMP
Le restanti regole di contenitore sono brevi. L'header deve essere %PDF-1.4 fino a %PDF-1.7 o %PDF-2.0 (pvriBadHeader), qualunque stream /Type /ObjStm solleva pvriObjStmPresent, e un file cifrato deve usare un header %PDF-2.0 (pvriEncryptVersionMismatch). Con RequireEncryptedPdf20Profile lasciato attivo, il dizionario di cifratura deve anche dichiarare /V 5 o 6 con /R 5 o successivo, altrimenti il file riceve pvriEncryptedPdf20ProfileInvalid
Scrivere i marker
TPdfRSaveOptions porta Creator, Producer, CreationDate, ModDate, DocumentId e InstanceId, e non ha campo per Title, Author, Subject o Keywords perché il profilo li vieta. StripInfoOptionalEntries e StripCatalogOptionalEntries valgono entrambe True per predefinito e rimuovono le voci escluse dalla sorgente; impostatene una a False e le voci restano, al prezzo della conformità. TPdf.SaveAsPdfR riempie i campi opzione vuoti dai metadati e dagli identificatori di file del documento caricato, rimuove la sicurezza, poi scrive il marker, i dizionari potati, il pacchetto XMP e il /ID del trailer
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, date e ID vengono dalla sorgente
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Controllate i byte che sono stati scritti, non il documento in memoria
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
L'incartamento cambia solo metadati e identificazione. Una pagina sorgente che disegna testo vettoriale, o che non porta strip image, esce da SaveAsPdfR con lo stesso contenuto di pagina e fallisce gli stessi controlli di pagina. Il contenuto di pagina viene lasciato stare di proposito, perché ri-renderizzare in silenzio una scansione cambierebbe proprio i pixel che l'archivio deve conservare. Eseguire CheckDeliveredScan dal primo listato su OutFile dà il veredetto completo, letture di pagina incluse
Dove si incastra PDF/R in una pipeline di acquisizione
PDF/R conviene ai deliverable dove la scansione stessa è la registrazione e la fedeltà è tutto il contratto: imaging probatorio, acquisizione di assegni e rimesse, archivi di disegni da uno scanner di grande formato. Appena un documento ha bisogno di testo ricercabile, tagging, allegati o segnalibri appartiene al PDF/A, perché ognuna di quelle funzioni atterra sulle liste escluse qui sopra
Tante squadre tengono entrambi. Un originale PDF/R viene scritto una volta e non cambia mai, e un derivato PDF/A con un layer OCR serve il reperimento. I validatori sono indipendenti, così un solo lavoro batch può controllare ogni file contro il profilo che dichiara. Il lato archivistico è trattato in conformità d'archivio PDF/A e validazione preflight PDF/A, e l'output di stampa in validazione di documenti PDF/X pronti per la stampa
I controlli PDF/R mostrati qui fanno parte delle edizioni Small Business ed Enterprise di PDFium Component per Delphi, C++Builder e Lazarus, accanto ai validatori per PDF/A, PDF/X, PDF/E e PDF/UA; edizioni e versioni IDE supportate sono sulla pagina prodotto PDFium Component