Un gate di ingestione archivio ha respinto un lotto di file "PDF/A-2b" che si aprivano senza problemi in ogni visualizzatore sulla scrivania. Il fornitore sosteneva che fossero conformi. Non lo erano: ciascuno conteneva un'azione JavaScript nascosta nel catalogo, il tipo di dettaglio che un'occhiata superficiale non nota mai e che un validatore PDF/A completo come veraPDF segnala all'istante. Il problema è che nessuno voleva aggiungere una toolchain Java a un servizio batch in Delphi solo per rispondere a una domanda sì-o-no per file. Questo è il vuoto ValidatePdfACompliance in PDFium Component colma, ed è utile capire come arrivi a un verdetto senza mai analizzare per intero uno stream di contenuto
Perché PDFium da solo non può rispondere a questa domanda
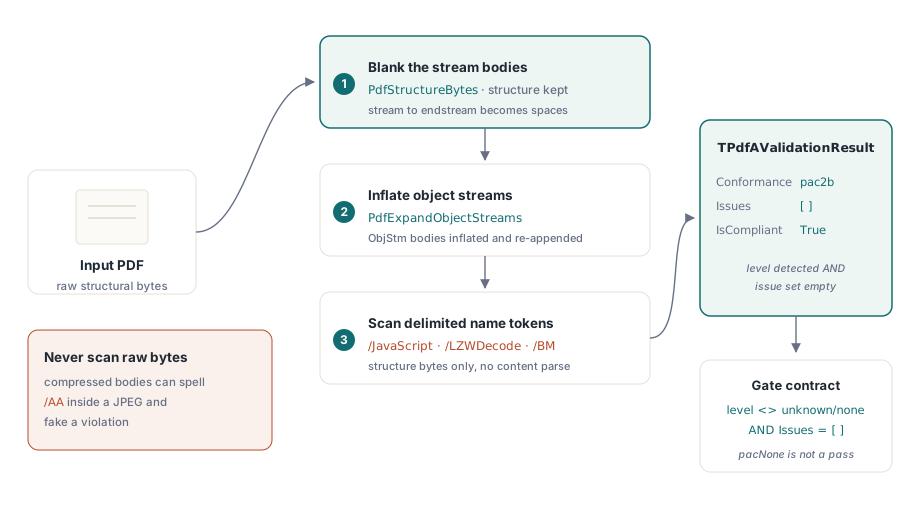
La prima cosa da chiarire è che il componente incluso pdfium.dll non ha alcuna capacità PDF/A. Non esiste ConvertToPDFA, nessun writer OutputIntent, nessuna API XMP nella superficie pubblica. Tutta la parte PDF/A di questa libreria, sia in scrittura sia in verifica, vive in puro Pascal in FPdfPdfa.pas e funziona tramite parsing a livello di byte e aggiornamenti incrementali. Quindi, quando chiami il validatore, non stai interrogando in alcun modo il renderer di Chromium. Stai eseguendo uno scanner di token Pascal sui byte strutturali del file
L'API pubblica è volutamente essenziale. Una funzione legge uno stream dalla posizione 0 e restituisce un record:
function ValidatePdfACompliance(Source: TStream): TPdfAValidationResult;

type
  TPdfAValidationResult = record
    Conformance: TPdfAConformance;        // pacUnknown, pacNone, pac1b, pac2u, ...
    Issues: TPdfAValidationIssues;        // un set di TPdfAValidationIssue
    function IsCompliant: Boolean;        // True solo quando il livello <> unknown/none
  end;                                    // E Issues è vuoto
IsCompliant codifica la regola che conta in un gate: un file supera il controllo solo quando è stato rilevato un vero livello di conformità e l'insieme dei problemi è vuoto. Un parsing riuscito ma senza alcun marker pdfaid risolve in pacNone, che esplicitamente non è un pass. È lo stesso punto che il CLI del report preflight batch comunica dall'esterno: un elenco vuoto di risultati su un file non riconosciuto non è un certificato di buona salute
Eliminare i corpi degli stream prima di qualsiasi scansione di token
Ecco il dettaglio di implementazione più importante, e quello più facile da sbagliare se scrivi uno scanner tuo. Il rilevatore trova le violazioni cercando token di nome delimitati, cose come /JavaScript, /LZWDecode, /BM. Se scansioni i byte grezzi del file, i corpi binari degli stream incorporati, le immagini compresse, i profili ICC, i programmi di font, conterranno casualmente sequenze di byte che sembrano proprio quei token. Segnalerai /AA o /3D come "trovato" solo perché tre byte dentro un JPEG per caso lo avevano composto. Questa è una fabbrica di falsi positivi
La correzione è PdfStructureBytes: percorre il file e azzera i byte tra ogni stream e endstream keyword per spazi, lasciando intatta la struttura del dizionario. Solo dopo parte la scansione. Ogni controllo dei token di nome nel validatore opera su questa copia ripulita. Se porti via un solo concetto da questo articolo, porta via quello. La stessa disciplina è replicata nel validatore PDF/UA, che mantiene una propria copia della routine perché i due standard evolvono indipendentemente
I 29 problemi e cosa significa ciascuno
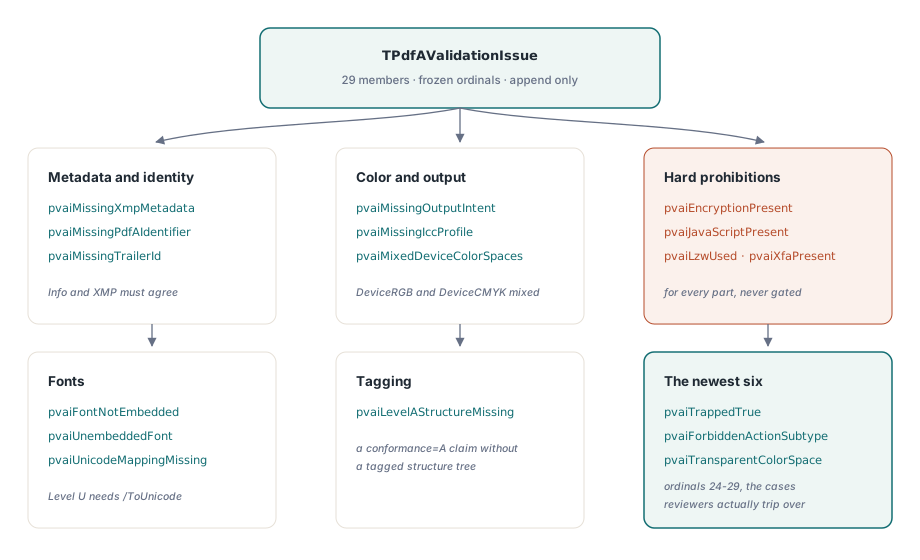
TPdfAValidationIssue è un contratto documentato. Gli ordinali sono congelati perché i chiamanti, le demo e il livello di report dipendono tutti da loro, quindi i nuovi riscontri vengono solo aggiunti in coda. Alla v1.63.0 i membri sono 29. Si dividono in alcune famiglie:
- Metadati e identità:
pvaiMissingXmpMetadata,pvaiMissingPdfAIdentifier,pvaiMissingTrailerId(ISO 19005-1 6.1.3),pvaiMissingXmpDates - Colore e output:
pvaiMissingOutputIntent,pvaiMissingIccProfile, epvaiMixedDeviceColorSpacesquando compaiono sia DeviceRGB sia DeviceCMYK (6.2.3.3) - Divieti assoluti per ogni parte:
pvaiEncryptionPresent(un/Encryptdizionario è vietato in modo assoluto),pvaiJavaScriptPresent,pvaiForbiddenAction,pvaiAdditionalActions,pvaiLzwUsed,pvaiXfaPresent,pvaiNeedAppearancesTrue,pvaiForbiddenAnnotation - Font:
pvaiFontNotEmbeddede il più rigorosopvaiUnembeddedFont, piùpvaiUnicodeMappingMissingper una dichiarazione Level U senza/ToUnicode - Marcatura:
pvaiLevelAStructureMissingquando una dichiarazione conformance=A non ha una struttura taggata
I sei membri più recenti, aggiunti agli ordinali da 24 a 29, coprono i casi sottili in cui i revisori inciampano davvero: pvaiTrappedTrue (un /Trapped /True nel dizionario Info, un "falso amico" perché il valore deve essere False o Unknown), pvaiForbiddenActionSubtype (Sound o Movie usati come azione, non solo come annotazione), pvaiTransparentColorSpace (una modalità di fusione non Normal o un /CA//ca diverso da 1.0), pvaiAnnotationDictViolation, pvaiUnembeddedFont, e pvaiMixedDeviceColorSpaces
Filtro consapevole della parte: A-1 è rigoroso, A-2 e A-3 allentano
PDF/A non è un solo regolamento. Tre cose che PDF/A-1 vieta sono esplicitamente consentite da PDF/A-2 in poi: la trasparenza (un /Transparency gruppo o una /SMask attiva, 6.4), contenuto opzionale (/OCProperties, 6.1.13), e file incorporati (/EmbeddedFiles o /EF, 6.1.11). Un validatore ingenuo che segnali tutte e tre per ogni file respingerà in massa documenti PDF/A-2 perfettamente validi
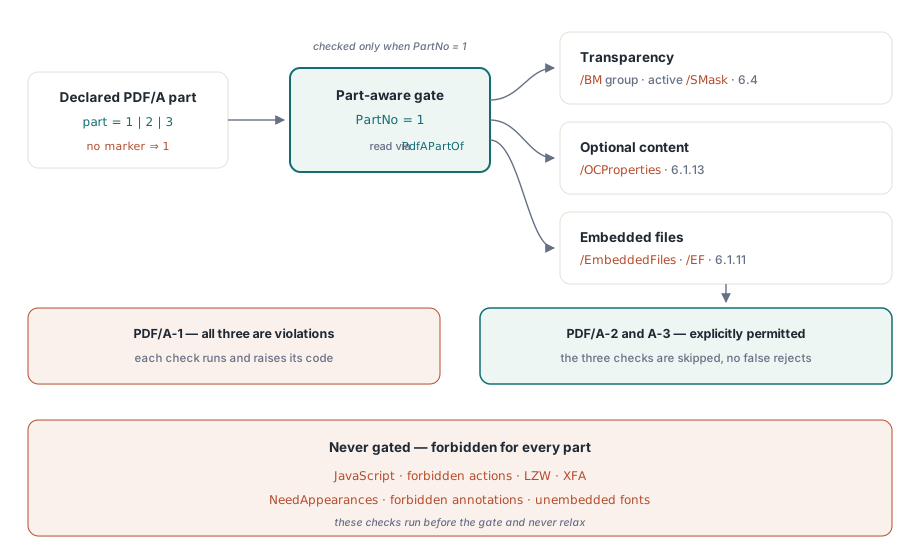
Quindi il validatore legge il numero di parte dal marker pdfaid tramite PdfAPartOf e li attiva solo quando PartNo = 1. I controlli sulla modalità di fusione e sull'alpha delle annotazioni per i nuovi problemi di trasparenza sono anch'essi solo per la parte 1:
if PartNo = 1 then
begin
  if PdfHasName(Struct, '/BM') then
    if not PdfHasBMNormal(Struct) then          // only /Normal or /Compatible allowed
      Include(Result.Issues, pvaiTransparentColorSpace);
  if PdfHasCaNotOne(Struct, '/CA') or PdfHasCaNotOne(Struct, '/ca') then
    Include(Result.Issues, pvaiTransparentColorSpace);
end;
Un default prudente merita una menzione: quando non c'è alcun marker pdfaid, la parte viene trattata come 1, la più restrittiva. Il ragionamento è che un file non identificato dovrebbe essere sottoposto alle regole più strette anziché essere lasciato passare. JavaScript, azioni proibite, LZW, XFA, NeedAppearances, annotazioni vietate e font non incorporati restano proibiti per ogni parte, quindi quei controlli non stanno mai dietro il gate
Espandere gli object stream così nulla resta nascosto
PDF 1.5 ha introdotto il cross-reference stream e l'object stream (/Type /ObjStm), e creano un punto cieco per un byte scanner ingenuo. Un catalogo, un OutputIntent, un dizionario di azione, qualsiasi cosa che non sia essa stessa uno stream, può essere compresso con Flate dentro un ObjStm. Scansiona la struttura grezza e non ne vedrai nulla, poi segnalerai un file pulito che pulito non è
PdfExpandObjectStreams colma questa lacuna. Prima che parta qualsiasi controllo, il validatore esegue Data := PdfExpandObjectStreams(Data). La routine trova ogni ObjStm, legge il suo /N e /First header per ricavare i numeri e gli offset degli oggetti contenuti, decomprime il corpo con PdfInflate (la zlib del RTL, System.ZLib su Delphi e zstream su FPC), e aggiunge ciascun oggetto contenuto come un normale N 0 obj ... endobj alla fine di una copia dei byte. I controlli sui token esistenti trovano poi quegli oggetti senza alcuna modifica alla loro logica
Due vincoli rendono tutto questo pulito anziché fragile. Gli oggetti stream, il Metadata, il profilo ICC e i programmi dei font non possono vivere in un object stream, solo i dizionari non stream possono farlo, quindi l'espansione gestisce sempre e solo dizionari e gli oggetti aggiunti non portano alcuna keyword stream a disturbare il passaggio di eliminazione dei corpi degli stream. E poiché il contenuto aggiunto finisce dopo %%EOF, la ricerca inversa da startxref individua ancora il trailer originale. Il trailer dello xref stream è gestito a parte, leggendo Root, Size e ID direttamente dal dizionario xref stream in chiaro, un argomento approfondito nel pezzo complementare su la convalida degli object stream e dei cross-reference stream; l'espansione degli object stream aggiunge il passaggio di inflate sopra quello
A cosa serve un controllo a livello di byte
Questo è uno strumento di preflight, non un validatore certificato. L'incorporamento dei font è un'euristica di conteggio, e il conteggio ovvio è quello sbagliato. PdfCountName('/FontDescriptor') vede due token /FontDescriptor per font, una referenza dal dizionario del font e una /Type nell'oggetto descriptor stesso, quindi il conteggio è 2N contro N programmi incorporati e il test è sempre vero. PdfCountDescriptorRefs conta solo la forma di riferimento /FontDescriptor N G R, una per font, e segnala pvaiUnembeddedFont solo quando i programmi incorporati sono davvero meno:
K := PdfCountDescriptorRefs(Struct);                 // uno per ogni dizionario di font
Emb := PdfCountName(Struct, '/FontFile')
     + PdfCountName(Struct, '/FontFile2')
     + PdfCountName(Struct, '/FontFile3');
if (K > 0) and (Emb < K) then
  Include(Result.Issues, pvaiUnembeddedFont);
È un segnale basato su conteggio, non un audit per font, quindi conferma i reperti sui font con un validatore completo, incluse le risorse standard-14 di default come /Helv che un /DR AcroForm espanso espone e che veraPDF accetta perché non vengono mai usate per renderizzare. I controlli a livello di operatore dei content stream (6.2.10) richiedono il parsing completo del contenuto e stanno fuori da una scansione di byte. Tratta il validatore come un primo gate veloce e senza dipendenze che intercetta le violazioni che l'iniezione di marcatori non può sistemare, e riserva un validatore completo alla certificazione finale
Questa è la metà di verifica della storia. Il lato di scrittura complementare, dove SaveAsPdfA inietta l'XMP, OutputIntent e il profilo ICC sRGB e degrada onestamente una richiesta Level A che non ha una struttura taggata, si basa sulla stessa meccanica a livello di byte. Entrambe le metà sono incluse in PDFium Component for Delphi, un singolo pacchetto VCL sopra un'implementazione PDF/A in puro Pascal senza runtime esterni da installare