Un dizionario Info che porta /ModDate (D:20260827093659+08'00') e un pacchetto XMP che porta xmp:ModifyDate come 2026-08-27T01:36:59Z descrivono lo stesso secondo, e un validatore PDF/A ha ogni motivo per accettare quella coppia. Copiate però la stringa Subject del documento in dc:subject, e il pacchetto fallisce anche quando il testo coincide carattere per carattere. ISO 19005-1 §6.7.3 chiede valori equivalenti, tenuti in proprietà XMP specifiche, in forme RDF specifiche
Il bug report che di solito apre questo argomento sembra innocuo. Un sistema di gestione documentale timbra un /ModDate fresco nel dizionario Info a ogni salvataggio incrementale e lascia tranquillo il pacchetto XMP. Mesi dopo un audit di archivio segnala migliaia di file. Entrambe le date ci sono; hanno smesso di concordare alla prima modifica, e un controllo che guarda solo all'esistenza della proprietà non l'ha mai visto. Le modifiche al titolo fatte attraverso una API solo-Info falliscono allo stesso modo, e così una stringa Author come Finance; Controlling che qualche tool ha spezzata in due voci dc:creator
Che cosa ISO 19005-1 richiede a Info e XMP
La Tabella 1 di ISO 19005-1 abbina otto chiavi Info a proprietà XMP, e §6.7.3 dice che una volta presente una chiave Info, la proprietà XMP mappata deve portare un valore equivalente. Una chiave assente non esige nulla. PDF/A-2 e PDF/A-3 mantengono lo stesso requisito di equivalenza per le stesse otto chiavi. PDF/A-4 va nell'altra direzione e restringe il dizionario Info stesso: può comparire solo accanto a un /PieceInfo del catalogo e quindi non tenere altro che ModDate, cosa che TPdf.ValidatePdfA riporta tramite pvaiPdfA4InfoWithoutPieceInfo e pvaiPdfA4InfoInvalid
In PDFium Component il confronto vive in ComparePdfAInfoAndXmp in FPdfPdfa.pas. Cerca ogni proprietà per URI di namespace, quindi un pacchetto che lega http://purl.org/dc/elements/1.1/ a un prefisso insolito viene letto esattamente come uno che usa dc. Le forme mappate sono:
- Title →
dc:titlee Subject →dc:description: un'alternativa linguisticardf:Alt, confrontata solo con la sua vocex-default; il tag di lingua viene confrontato case-insensitive, e un Alt senzax-defaultconta come assente - Author →
dc:creator: unrdf:Seqcon esattamente una voce di testo che tiene l'intera stringa Info, così una lista di autori separata da punto e virgola resta una voce unica - Keywords →
pdf:Keywordse Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/): proprietà di testo semplice - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/): proprietà di testo semplice
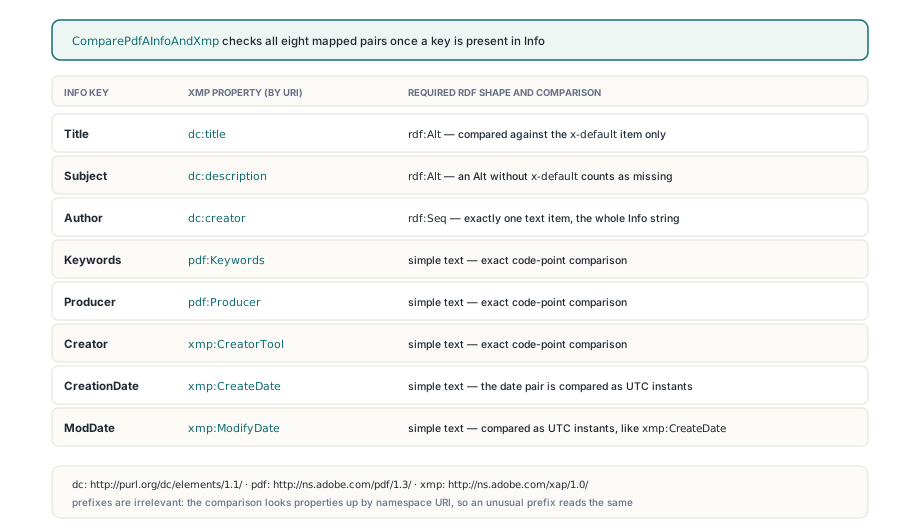
La riga di Subject è dove i template costruiti a mano vanno più spesso in errore. Il dc:subject di Dublin Core è un bag non ordinato di parole chiave, e il nome invita a scaricarci dentro lo Subject dell'Info. Il confronto cerca dc:description, non trova nulla, e riporta Subject come pamsXmpMissing mentre il testo "giusto" sta a una proprietà di distanza. Tre righe nelle forme corrette assomigliano a questa:
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Perché una stringa corretta fallisce comunque il confronto?
Una stringa corretta fallisce quando sta nel contenitore sbagliato o differisce per un singolo code point. I valori di testo vengono confrontati come sequenze esatte di code point Unicode, senza trim, case folding o normalizzazione. Uno spazio finale è una mancata corrispondenza. Lo è anche una é precomposta da un lato contro una e decomposta più accento combinato dall'altro, anche se le due di solito si renderizzano identiche sullo schermo
Gli errori di forma hanno uno stato loro. Una dc:title scritta come testo semplice, una dc:creator dichiarata come rdf:Bag, o una Seq di dc:creator con due voci producono tutti pamsXmpTypeMismatch invece di pamsValueMismatch, così un report può distinguere "il tool ha scelto la struttura RDF sbagliata" da "il tool ha scritto testo diverso". I due problemi di solito vengono da punti diversi di una pipeline, e sistemare quello sbagliato spreca un pomeriggio
Il lato Info viene sempre dalla decodifica di PDFium delle stringhe PDFDocEncoding e UTF-16BE tramite FPDF_GetMetaText, lo stesso percorso che usa TPdf.GetMetadata, quindi una stringa con un byte-order mark o una sequenza ottale escapata viene letta come la legge il motore. Il lato XMP è pulito solo quanto i byte che l'hanno prodotto. Un pacchetto assemblato con la code page sbagliata può portare mojibake che nessun confronto perdona, ed è per questo che le trappole di codepage che corrompono i metadati XMP sotto Free Pascal stanno nella stessa checklist
Quando una data PDF e una data XMP sono uguali?
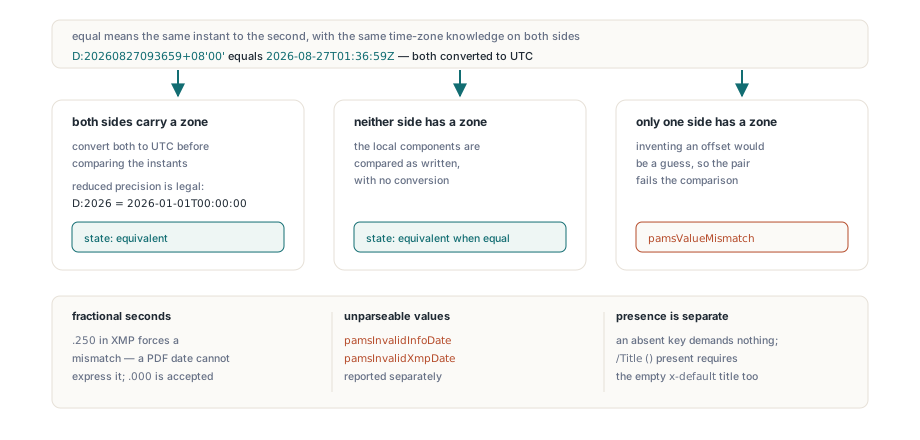
Una data PDF e una data XMP sono uguali quando descrivono lo stesso istante al secondo con la stessa conoscenza del fuso da entrambi i lati. Entrambi i parser accettano la precisione ridotta legale, così D:2026 e 2026 significano entrambi 1 gennaio 2026 a mezzanotte. Quando entrambi i valori portano un fuso, ognuno viene prima convertito in UTC: D:20260827093659+08'00' è uguale a 2026-08-27T01:36:59Z. Quando nessuno dei due porta un fuso, le componenti locali vengono confrontate come scritte
Quando solo un lato ha un fuso, il risultato è pamsValueMismatch. Inventarsi un offset per il valore senza fuso sarebbe un'ipotesi, e un'ipotesi che per caso coincide col fuso del server passerebbe su una macchina e fallirebbe su un'altra. Un secondo frazionario diverso da zero come .250 in XMP forza comunque la mancata corrispondenza, perché una data PDF non ha modo di esprimerlo; .000 è accettato. I valori che non si analizzano per niente vengono riportati come pamsInvalidInfoDate o pamsInvalidXmpDate
I due grammatiche delle date non sono intercambiabili, e i parser tengono ciascun lato alla propria. Sul lato PDF, gli apostrofi attorno ai minuti dell'offset sono opzionali e la Z è accettata. Sul lato XMP l'offset vuole i due punti: 2026-08-27T09:36:59+08:00 si analizza, mentre +0800 è pamsInvalidXmpDate. L'ora XMP vuole anche almeno ore e minuti appena appare una T, e gli offset oltre 14 ore vengono rifiutati da entrambi i lati. Lo spazio bianco circostante viene trimmato prima di analizzare una data, una cortesia che i campi di testo non ricevono
La presenza ha una regola propria. TPdfAMetadataValues.Present è un set riempito percorrendo il dizionario /Info del trailer attivo, e tiene separato "chiave assente" da "chiave presente con stringa vuota". Una chiave assente dà pamsNotRequired. /Title () è presente, quindi il pacchetto deve portare anche un titolo x-default vuoto
Leggere il report per campo prima di toccare il file
TPdf.InspectPdfAMetadata restituisce un TPdfAMetadataReport con una TPdfAMetadataComparison per campo. Ogni voce tiene il valore Info, il valore XMP e un TPdfAMetadataState, così un fallimento può essere spiegato campo per campo. MismatchFields raccoglie il set di campi falliti, HasXmpPacket dice se un pacchetto è stato trovato, e XmpParseError porta il messaggio del parser quando un pacchetto esiste ma non si può leggere. In quest'ultimo caso ogni campo presente riporta pamsXmpMissing, perché dal pacchetto non si è letto nulla
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
TPdf.ValidatePdfA piega lo stesso confronto nel suo insieme di issue. La scansione a livello byte, descritta in validazione preflight PDF/A con PDFium Component, riporta pvaiMissingXmpDates quando il pacchetto manca di entrambe le proprietà data e pvaiInfoXmpDateMismatch quando Info porta CreationDate o ModDate ma il pacchetto non ha una proprietà data corrispondente. Sopra questo, ValidatePdfA esegue il confronto completo dei valori e aggiunge pvaiInfoXmpValueMismatch ogni volta che un pacchetto esiste ma è in disaccordo con Info, pacchetto illeggibile incluso. Un documento senza pacchetto viene riportato solo come pvaiMissingXmpMetadata, così un difetto non compare mai due volte. La funzione ValidatePdfACompliance a livello stream esegue la sola scansione byte
function MetadataGateOk(Pdf: TPdf): Boolean;
var
  Res: TPdfAValidationResult;
begin
  Res := Pdf.ValidatePdfA;
  if pvaiMissingXmpMetadata in Res.Issues then
    Writeln('No usable XMP packet: rebuild the file with SaveAsPdfA');
  if pvaiInfoXmpDateMismatch in Res.Issues then
    Writeln('Info has a date property the XMP packet lacks entirely');
  if pvaiInfoXmpValueMismatch in Res.Issues then
    Writeln('Mapped values disagree: run InspectPdfAMetadata for details');
  Result := Res.IsCompliant;
end;
Che cosa riscrive NormalizePdfAMetadata, e dove si ferma
TPdf.NormalizePdfAMetadata tratta il dizionario Info come fonte di verità e riscrive solo le proprietà XMP il cui campo è finito in MismatchFields. Title e Subject vanno nella voce x-default mentre le altre alternative linguistiche restano intatte. Author diventa un rdf:Seq a una voce. Una data Info con fuso viene scritta come data XMP UTC canonica con suffisso Z, e una senza fuso conserva le sue componenti locali. Namespace sconosciuti, proprietà non correlate e proprietà XMP per chiavi Info assenti vengono lasciati in pace, e un binding di prefisso esistente viene riutilizzato quando una proprietà viene riscritta
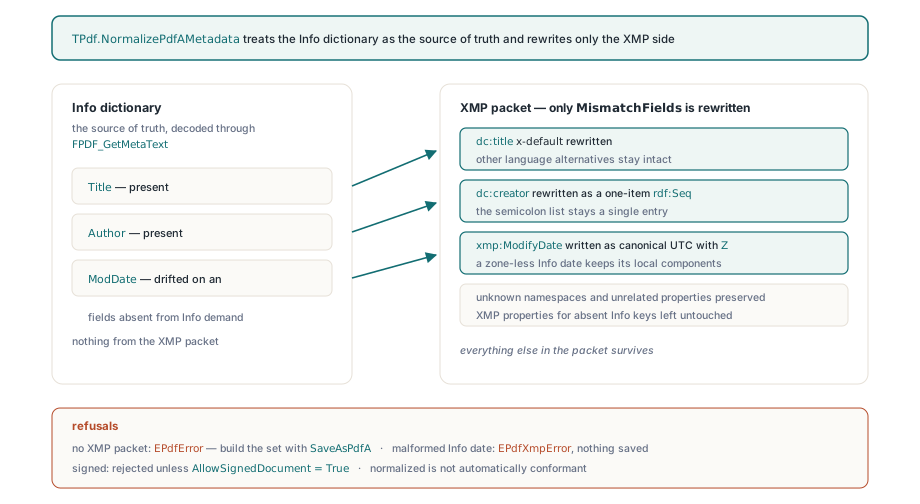
Rendere Info autorevole ha un costo che si vede sui file veri. Una Seq di dc:creator che elenca "Finance" e "Controlling" come due persone viene sostituita da una voce sola che legge Finance; Controlling, e una dc:title conservata nel contenitore sbagliato viene ricostruita come un Alt fresco che tiene solo x-default, così ciò che il vecchio contenitore teneva è andato. Questa perdita è accettabile qui. La Tabella 1 consente esattamente una voce di creator, la stringa Info tiene già la lista completa in un pezzo solo, e il pacchetto originale resta nel file sorgente se qualcuno ha bisogno della lista più ricca
I rifiuti sono deliberati. Senza pacchetto XMP il metodo solleva EPdfError: costruire un set completo di identificazione e metadati PDF/A è compito di SaveAsPdfA, coperto in creare file PDF/A di archiviazione con PDFium Component. Un pacchetto illeggibile o una data Info malformata solleva EPdfXmpError prima che nulla venga scritto, perché una data sbagliata di aspetto plausibile in XMP è peggio di nessun output. I documenti firmati sollevano EPdfError a meno che il caller passi AllowSignedDocument = True; l'output è un salvataggio completo con i nuovi metadati accodati come aggiornamento incrementale, quindi i byte firmati non vengono riportati identici
Quel percorso di salvataggio ha un'altra conseguenza. NormalizePdfAMetadata scrive un nuovo file anche quando ogni campo già coincide, visto che sincronizzare nulla finisce comunque in un salvataggio. Chiamate prima InspectPdfAMetadata e saltate i file equivalenti; un job notturno che riscrive migliaia di archivi invariati non compra nulla salvo nuovi timestamp dei file. L'overload su file scrive tramite un file temporaneo e sostituisce il target atomicamente. Il file sorgente resta aperto finché il documento è caricato, quindi date all'output un percorso diverso
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // già coerente, lasciate stare il file
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // data Info malformata o pacchetto illeggibile
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
      on E: EPdfError do         // input firmato senza AllowSignedDocument
        raise Exception.CreateFmt('Skipped %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
L'equivalenza è una clausola di ISO 19005-1. Un file normalizzato deve comunque passare font, colore, trasparenza e ogni altro controllo PDF/A, quindi ValidatePdfA resta il portone prima che un documento parta verso l'archiviazione a lungo termine
Confrontare un pacchetto senza documento caricato
ComparePdfAInfoAndXmp e SynchronizePdfAInfoToXmp sono funzioni semplici in FPdfPdfa che lavorano su un TPdfXmpPacket senza PDF aperto, il che conviene ai test unitari e alle pipeline che riempiono l'XMP da un template prima che il documento esista. SynchronizePdfAInfoToXmp restituisce il set di campi che ha riscritto e solleva EPdfXmpError se riceve un pacchetto nil
La trappola unica è Present. Un record inizializzato con Default(TPdfAMetadataValues) ha un set vuoto, ogni campo riporta quindi pamsNotRequired, e il confronto passa qualunque cosa vi abbiate messo nei valori. I campi stringa del record portano i valori; solo Present decide quali di loro lo standard esiga davvero
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present decide quali campi sono obbligatori; i valori da soli vengono ignorati
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // un xmp:ModifyDate in disaccordo diventa 2026-08-27T01:36:59Z,
    // un dc:creator in disaccordo diventa un rdf:Seq a una voce
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Fare girare lo stesso template per ComparePdfAInfoAndXmp dopo dovrebbe restituire un MismatchFields vuoto, il che è un'asserzione a buon mercato per un passo di build che rigenera i template
Gli archivi che altri sistemi continuano a modificare derivano un campo alla volta, e il report per campo mostra quale si è mosso. InspectPdfAMetadata, NormalizePdfAMetadata e il resto degli strumenti di validazione e conversione PDF/A fanno parte di PDFium Component for Delphi e C++Builder