Un archivio fatture può renderizzare pulito, stampare, incorporare ogni font e portare un output intent valido, e un validatore PDF/A lo rifiuterà comunque perché un dizionario risorse tiene 4.096 voci. Il tetto è 4.095. PDF/A eredita una piccola tabella di limiti di implementazione dal PDF Reference, e un file di un'unità sopra uno qualsiasi di essi fallisce la conformità anche se nessun viewer si lamenta
L'altro fallimento che atterra nello stesso secchio "ma sembra a posto" è un font TrueType simbolico che porta una voce /Encoding. Checkbox, codici a barre e dingbat vengono fuori giusti a schermo, e il validatore segnala comunque il dizionario del font. Entrambi i problemi vivono nel grafo degli oggetti piuttosto che in qualcosa che una persona può vedere sulla pagina, quindi valgono un controllo meccanico prima che un file entri in un archivio
I numeri che PDF/A eredita, e dove sta il confine
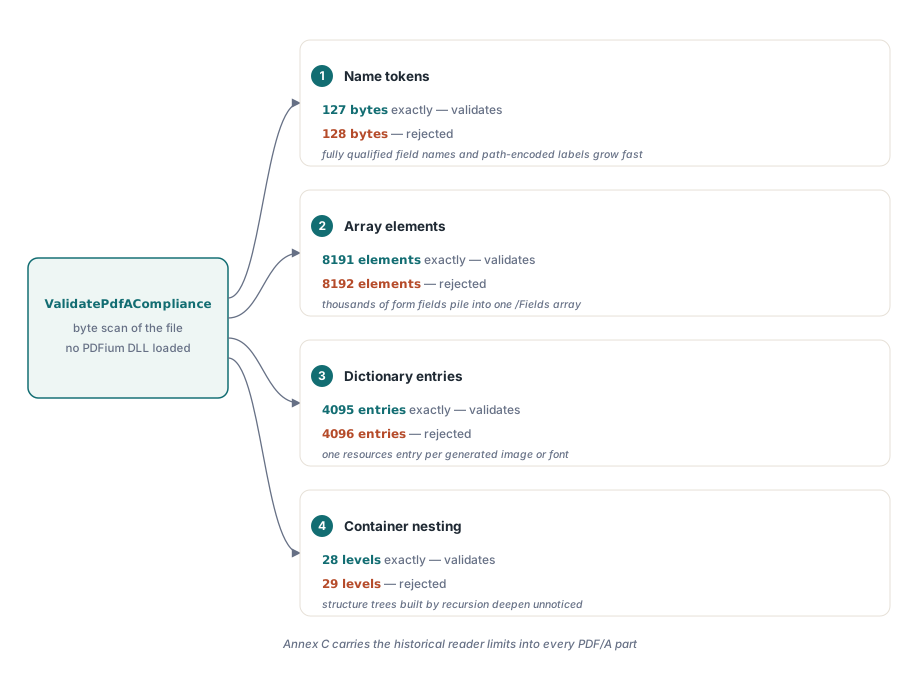
PDFium Component controlla quattro limiti di contenitore su ogni validazione PDF/A: un token di nome può essere lungo al massimo 127 byte, un array può tenere al massimo 8.191 elementi, un dizionario può tenere al massimo 4.095 voci, e array e dizionari possono annidarsi al massimo 28 livelli. Tutti e quattro i confini sono inclusivi. Un nome di 127 byte passa e un nome di 128 byte fallisce; un array di esattamente 8.191 elementi passa e un elemento in più lo fa fallire
I limiti di nome, array e dizionario vengono dall'epoca in cui si richiedeva a un reader conforme di gestire strutture solo fino a quelle dimensioni. Un viewer desktop attuale può aprire un array molto più grande senza lamentarsi, ma un file di archivio dovrebbe aprirsi in reader che nessuno ha ancora testato, inclusi quelli vecchi che un sistema di records potrebbe ancora far girare. Ecco perché PDF/A conserva i tetti storici invece di allentarli
Inclusivo contro esclusivo è dove i controlli fatti a mano di solito sbagliano. Un test scritto come Count >= 8191 invece che Count > 8191 rifiuta file conformi, e un validatore che rifiuta file conformi tende comunque a essere creduto, quindi il generatore viene "sistemato" per un problema che non ha mai avuto. La funzione ValidatePdfACompliance nell'unità FPdfPdfa conta rigorosamente oltre il limite, e legge direttamente i byte del file, quindi il controllo gira senza caricare la DLL di PDFium
uses
  System.Classes, FPdfPdfa;

procedure CheckContainerLimits(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Res: TPdfAValidationResult;
begin
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfACompliance(Src);   // scansione di byte, DLL PDFium non necessaria
    if pvaiNameOverLimit in Res.Issues then
      Log.Add('A name token is longer than 127 bytes');
    if pvaiArrayOverLimit in Res.Issues then
      Log.Add('An array holds more than 8191 elements');
    if pvaiDictOverLimit in Res.Issues then
      Log.Add('A dictionary holds more than 4095 entries');
    if pvaiNestingOverLimit in Res.Issues then
      Log.Add('Arrays and dictionaries nest deeper than 28 levels');
    if Res.IsCompliant then
      Log.Add('No PDF/A findings');
  finally
    Src.Free;
  end;
end;
I quattro flag sono membri del set Issues su TPdfAValidationResult, accanto a ogni altro riscontro PDF/A, e IsCompliant restituisce True solo quando è stata trovata un'identificazione PDF/A e il set è vuoto. Un file che non porta affatto identificazione PDF/A viene controllato contro il rigido set di regole PDF/A-1, quindi i limiti di contenitore si applicano anche a esso
Quali generatori incappano in questi limiti?
Quasi sempre quelli che costruiscono struttura in un loop. Un modulo con parecchie migliaia di campi produce un array AcroForm /Fields, o un array /Annots di pagina, che supera le 8.191 voci. Un motore di report che registra una risorsa font o immagine per oggetto generato, e non riusa mai una voce esistente, fa crescere un sottodizionario /Resources oltre le 4.095 chiavi. Un documento taggato il cui albero di struttura è prodotto ricorrendo su un modello dati annidato può passare i 28 livelli senza che nessuno guardi
I nomi lunghi hanno un'origine diversa: dati compressi in token di nome. Un colorante separation nominato come un riferimento cliente, un gruppo optional-content nominato come un percorso file, un'etichetta di campo assemblata da sei livelli di gerarchia. I nomi non costano nulla da generare, e 127 byte finiscono presto quando entra in gioco un'etichetta UTF-8 con caratteri accentati, perché ognuno di quei caratteri occupa due o tre byte. I 127 byte vengono contati dopo l'introduttore /, fino al prossimo delimitatore o spazio
Il rimedio è strutturale ogni volta. Spezzate l'array, spezzate il dizionario, appiattite la ricorsione, accorciate il nome. Iniettare marcatori PDF/A nel file non può aiutare con nessuno di questi riscontri, dato che il problema è la forma del grafo di oggetti e i metadati XMP non dicono nulla al riguardo
Come la scansione conta elementi e voci
La regola di conteggio conta quando cercate di riprodurre un riscontro in un editor esadecimale. Un array o dizionario annidato conta come un elemento del suo genitore, che è come il limite è enunciato: un array di 10 elementi di array da 1.000 elementi va bene, perché nessun singolo array supera 8.191. Dentro un dizionario si contano solo le chiavi, quindi un valore che capita di essere un nome non gonfia il totale delle voci. Le stringhe esadecimali come <FEFF0041> vengono saltate come token singoli, così le loro parentesi angolari non vengono mai scambiate per annidamento di dizionario
La scansione copre la struttura di oggetti dell'intero file, inclusi gli oggetti memorizzati dentro compressed object stream, che vengono espansi prima del conteggio. I corpi degli stream stessi, come contenuto di pagina e dati immagine, vengono azzerati prima, così una sequenza di byte binari che capita di contenere un / o un [ non può innescare un falso riscontro di nome o array
C'è un limite numerico adiacente che la stessa validazione riporta sotto il proprio flag. Quando il file dichiara PDF/A-2 o una parte successiva, pvaiIntegerImplementationLimit viene alzato per ogni token intero fuori dall'intervallo signed a 32 bit, cioè fuori da -2.147.483.648 a 2.147.483.647. I generatori che scrivono offset di byte o contatori grandi come interi semplici sono la fonte usuale
Perché un font TrueType simbolico deve lasciare cadere /Encoding?
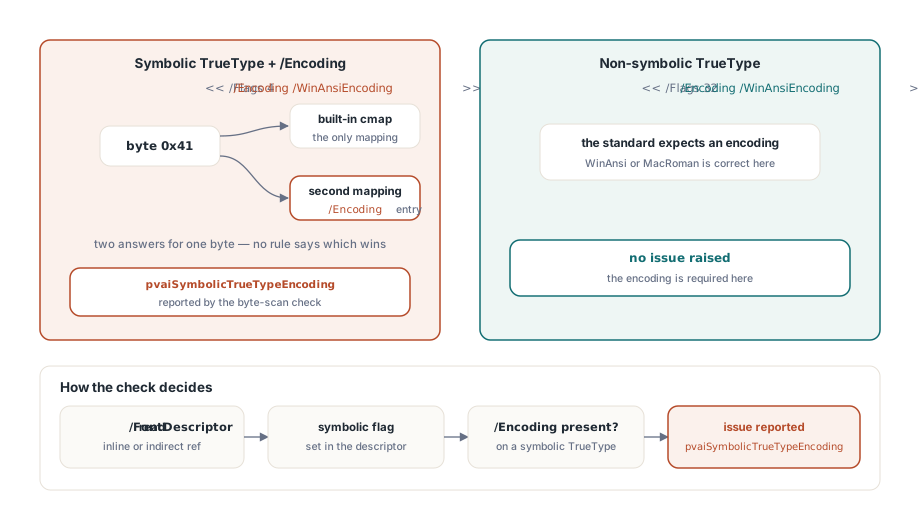
ISO 19005-1 §6.3.7 ammette solo il cmap integrato del programma font come mappatura caratteri per un font TrueType simbolico. Un font simbolico mappa i codici ai glifi a modo suo; è ciò che dichiara il flag Symbolic. Aggiungete una voce /Encoding e il file ora dà due risposte alla domanda "quale glifo seleziona il byte 0x41", senza nulla nel file che dica quale vince. I reader risolvono il conflitto diversamente, e la stessa checkbox può venire fuori come spunta in un viewer e come lettera A in un altro
ValidatePdfACompliance trova ogni dizionario font con /Subtype /TrueType, controlla se ha una chiave /Encoding, e poi legge il bit 3 (valore 4) della voce /Flags nel font descriptor. Il descrittore viene seguito sia che sia scritto inline sia che sia referenziato come oggetto indiretto. Un font TrueType non simbolico che conserva /WinAnsiEncoding o /MacRomanEncoding non viene segnalato da questo controllo, perché per i font non simbolici PDF/A si aspetta esattamente quella codifica
// Res arriva da ValidatePdfACompliance come nel primo esempio
if pvaiSymbolicTrueTypeEncoding in Res.Issues then
  Log.Add('A symbolic TrueType font carries /Encoding; PDF/A admits only ' +
    'the font''s built-in cmap (ISO 19005-1 6.3.7)');

// Una regola font vicina con trigger diverso: un font TrueType NON simbolico
// il cui dizionario Encoding porta /Differences
if pvaiTrueTypeDifferencesForbidden in Res.Issues then
  Log.Add('A non-symbolic TrueType Encoding dictionary carries /Differences');
I font che inciampano in questa regola sono prevedibili: Symbol, Wingdings, font di codici a barre, font di icone. Compaiono nei documenti aziendali come checkbox, stelle di valutazione e codici a barre, e un passo di subsetting che tratta ogni font TrueType allo stesso modo scrive una codifica anche per loro. Sono anche i font che nessuno guarda quando un validatore dice "problema font", perché i font del testo principale vengono controllati prima
L'errore opposto compare anch'esso in natura: un producer imposta il flag Symbolic su un font di testo ordinario che in realtà è codificato WinAnsi. Il controllo PDF/A segue la clausola come scritta e riporta quel font, e qui la riparazione appartiene al descrittore: correggete il flag nel descrittore invece di cancellare la codifica. Togliere /Encoding a un font di testo etichettato male lascerebbe il testo dipendente da qualunque cmap il subset contenga, che è un file peggiore di quello di partenza. Guardate il set di glifi del font prima di scegliere quale metà della contraddizione rimuovere
Leggere i riscontri in un report di preflight
L'unità del report di preflight viaggia con l'edizione Enterprise, mentre ValidatePdfACompliance è in ogni edizione. Il report nell'unità FPdfPreflightReport ordina i quattro limiti di contenitore nella categoria Structure e il problema di codifica TrueType simbolico nella categoria Content. Quella ripartizione è deliberata. I riscontri di struttura di solito tornano a chi mantiene il generatore, mentre quelli di contenuto di solito vanno a chi ha fornito font e template, e un report che li mescola manda entrambi a inseguire problemi che non sono loro
Ogni problema porta il suo nome enum come Code e una raccomandazione che nomina il rimedio in termini concreti, per esempio "Split dictionaries so none carries more than 4095 entries". Notate che la categoria Structure tiene anche altri due riscontri, una struttura taggata mancante su una richiesta Level A e cross-reference o object stream PDF 1.5 in un file PDF/A-1, quindi filtrate per codice quando volete solo i quattro limiti
uses
  System.SysUtils, System.Classes, PDFium, FPdfPreflightReport;

procedure ReportStructureFindings(const FileName: string; Log: TStrings);
var
  Pdf: TPdf;
  Report: TPdfPreflightReport;
  Issues: TPdfPreflightIssues;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;          // questo percorso carica la DLL di PDFium
    if not Pdf.Active then
      Exit;
    Report := BuildPdfPreflightReport(Pdf, [ppsPdfA]);
    Issues := Report.FilterByCategory('Structure').FlattenIssues;
    for I := 0 to High(Issues) do
      Log.Add(Issues[I].Code + ': ' + Issues[I].Recommendation);
    Report.SaveJsonToFile(ChangeFileExt(FileName, '.preflight.json'));
  finally
    Pdf.Free;
  end;
end;
I due percorsi rispondono a domande leggermente diverse. BuildPdfPreflightReport passa per TPdf.ValidatePdfA, che salva il documento aperto su una copia temporanea, esegue la stessa scansione di byte su quella copia e poi aggiunge controlli che vogliono il motore PDFium, come i font usati su una pagina ma non incorporati. ValidatePdfACompliance giudica i byte esatti su disco. Per i limiti di implementazione, il percorso byte sul file originale è quello da fidare: riporta sul file che state per archiviare, e gira in un passaggio di build o in un servizio bloccato dove una DLL nativa non può essere deployata. Usate il percorso report quando volete anche i controlli a livello di motore e l'output JSON, SARIF o JUnit per una pipeline
Dove andare da qui
Eseguire questi controlli su una cartella, decidere quali riscontri bloccano una release e trasformare il risultato in un report che la gente leggerà sono trattati nella guida di validazione preflight PDF/A in Delphi e nella CLI del report preflight in batch. Quale parte PDF/A e livello di conformità puntare in primo luogo è il soggetto delle note su conformità d'archivio PDF/A; quella scelta decide, tra le altre cose, se il limite sugli interi si applica
I validatori mostrati qui viaggiano con PDFium Component per Delphi, C++Builder e Lazarus, accanto a rendering, riempimento di moduli ed editing sopra il motore PDFium. La pagina del prodotto PDFium Component elenca gli standard di conformità supportati, le edizioni e le versioni dei compilatori