La versione 3.117.0 di PDFium Component collega una tabella che si spezza su un confine di pagina quando o entrambi i frammenti toccano i bordi della pagina, oppure nessun testo di corpo sta sotto il primo frammento e sopra il secondo, ignorando intestazioni e piè di pagina correnti. ExtractDocumentTables applica quel test basato sul contenuto in alternativa al vecchio test sui margini di pagina, rifiuta un frammento della pagina successiva la cui prima riga è un'unica cella di didascalia a larghezza piena, e conserva come parte della sua catena di continuazione una singola riga che sborda sulla pagina seguente
L'articolo sul rilevamento e l'estrazione delle tabelle presentava la continuazione come quattro gate rigorosi e trattava "tocca il bordo della pagina" come uno di essi. Quella descrizione era accurata per la release che copriva, ed era anche sbagliata per la maggior parte delle tabelle che le persone danno davvero in pasto al componente. Questo articolo è la correzione: quali documenti il test sui margini non sa gestire, che cosa lo ha sostituito e i due casi limite che la correzione si è tirata dietro
Perché il test sui margini di pagina fallisce sugli export di Word?
Il test sui margini di pagina fallisce perché un word processor smette di disporre le righe al margine inferiore, non al bordo del foglio. Con il valore di default di ContinuationMargin, 36 punti, la regola originale richiedeva che il bordo inferiore del frammento precedente stesse entro 36 punti dal fondo della pagina e che il bordo superiore del frammento successivo stesse entro 36 punti dalla cima. Un documento esportato da Word con i suoi margini di default da un pollice mette l'ultima riga almeno 72 punti sopra il fondo della pagina, e anche di più se c'è un piè di pagina, quindi la condizione non si verificava mai. Ogni tabella lunga in un documento del genere tornava come frammenti indipendenti con ContinuationGroup a zero, e il chiamante era di nuovo a cucire a mano. Il test ha ancora senso per ciò attorno a cui era stato progettato: report generati da motori di impaginazione che riempiono una pagina fino a un box di contenuto fisso e iniziano la pagina successiva a filo dalla cima. Non è una regola sbagliata, è una regola incompleta, ed è per questo che la versione 3.117.0 l'ha tenuta e ha aggiunto un secondo percorso invece di sostituirla
Che cosa controlla invece il test basato sul contenuto?
Il test basato sul contenuto controlla se qualcosa di diverso dalla tabella occupa lo spazio tra i due frammenti, usando i box delle parole di ogni pagina invece della geometria della pagina. Mentre ExtractDocumentTables percorre il documento registra, per pagina, il bordo inferiore più basso di qualsiasi parola la cui cima stia sopra la fascia del piè di pagina e il bordo superiore più alto di qualsiasi parola il cui fondo stia sotto la fascia dell'intestazione. Entrambe le fasce sono profonde ContinuationMargin punti, quindi la stessa opzione fa ora doppio servizio come tolleranza sul bordo pagina e come altezza delle zone di intestazione e piè di pagina correnti. Una coppia di frammenti passa quando il bordo inferiore del primo sta al livello o sotto il testo di corpo più basso della sua pagina e il bordo superiore del secondo sta al livello o sopra il testo di corpo più alto della pagina successiva, ciascuno entro AlignmentTolerance. In parole povere: la tabella era l'ultima cosa a pagina N e la prima a pagina N+1, e un numero di pagina o un titolo del documento nella fascia del margine non contano. Questa esclusione non è arbitraria. ISO 32000-1 §14.8.2.2 classifica intestazioni e piè di pagina correnti come artefatti di paginazione, contenuto che esiste per via dell'interruzione di pagina e non nonostante essa, e la stessa idea che permette a un reader con tag di saltarli è quella che permette a una tabella di proseguire oltre. L'articolo sul marked content spiega come i file con tag dichiarino quegli artefatti in modo esplicito; qui la classificazione viene dedotta dalla posizione, perché la maggior parte delle tabelle esportate non porta alcun tag
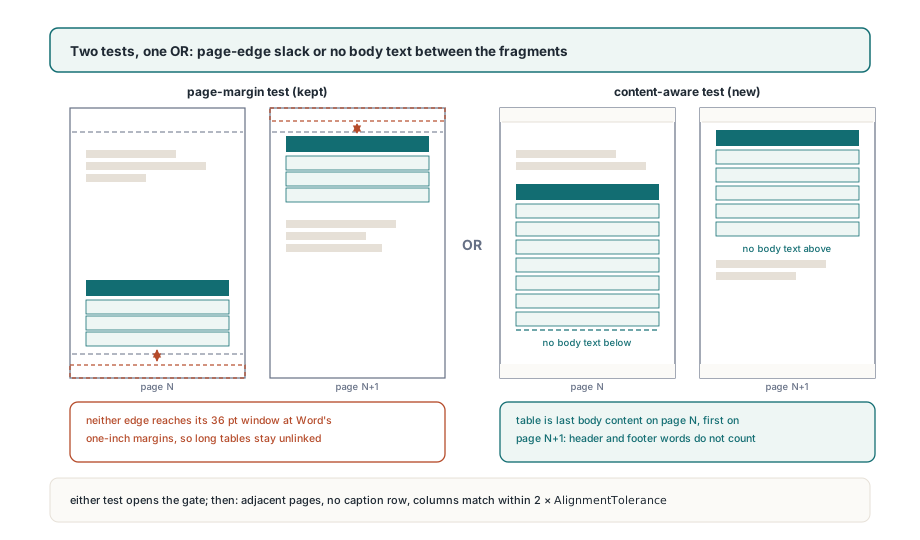
I due test si combinano in OR. Un report di un motore di impaginazione le cui tabelle arrivano al bordo del foglio passa il primo; un export di Word le cui tabelle si fermano al margine passa il secondo; un documento che fa entrambe le cose passa due volte. Solo dopo che uno dei due riesce girano i cancelli restanti, e girano in un ordine fisso: i numeri di pagina devono essere adiacenti, il frammento successivo non deve aprirsi con una riga di didascalia, e i confini di colonna devono corrispondere entro il doppio di AlignmentTolerance, che con i valori di default è 6 punti. L'enumerazione è TPdfTableContinuation con i valori ptcNone, ptcStart, ptcMiddle e ptcEnd. Un frammento marcato ptcEnd che poi si collega a un'ulteriore pagina viene promosso a ptcMiddle, così una tabella su tre pagine si legge start, middle, end in ordine di pagina. I numeri di gruppo partono da 1 e 0 significa non collegato, e ToJson emette le stesse informazioni nei membri continuation e continuationGroup, che è la forma da preferire se è un servizio a valle a fare la cucitura
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // default; mostrato per chiarezza
    Options.ContinuationMargin := 54;        // piè di pagina su due righe, profondo ~50 pt

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
Come fa una riga di didascalia a impedire che due tabelle si fondano?
Un frammento della pagina successiva la cui prima riga è un'unica cella che copre tutte le colonne viene trattato come una nuova tabella, mai come il resto della precedente. Questa regola esiste perché il test basato sul contenuto, da solo, collega con troppa avidità. Il caso che l'ha messa in luce era un modulo in stile verbale: una tabella finisce vicino al fondo di pagina 1, una seconda tabella con larghezze di colonna identiche inizia vicino alla cima di pagina 2, tra le due non c'è altro che il piè di pagina, e le colonne coincidono al punto giusto. Con il test sui margini le due non si incontravano mai perché nessuna toccava un bordo; con il test sul contenuto si sono collegate subito, e un modulo a sezioni è diventato un'unica griglia incoerente. Ciò che le separa si vede nella struttura delle celle. La seconda tabella si apre con una didascalia di sezione come "RECIPIENT INFORMATION" disposta come un'unica cella unita a tutta larghezza, e una continuazione autentica non lo fa mai, perché la didascalia appartiene alla tabella già iniziata sulla pagina precedente. TableStartsWithCaptionRow codifica esattamente questo: il frammento ha almeno due colonne e contiene una cella con RowIndex = 0, ColumnIndex = 0 e ColumnSpan = ColumnCount. Il controllo gira solo sul frammento successivo, quindi una tabella la cui riga di didascalia sta sulla sua prima pagina resta intatta; la didascalia è a pagina N, e solo il frammento di pagina N+1 viene ispezionato
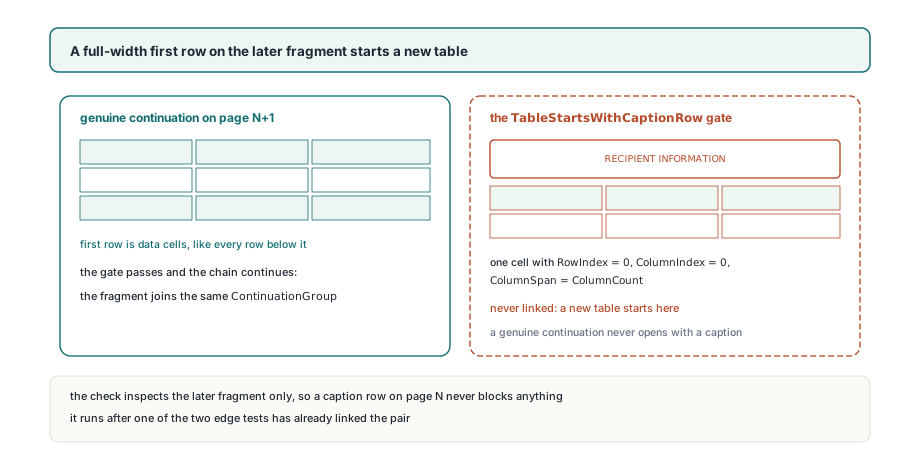
Il confronto di colonne che segue, TablesHaveMatchingColumns, è più severo di "stesso numero di colonne". Ricostruisce le posizioni dei confini di ogni frammento dai rettangoli delle celle, interpola i confini che le celle unite nascondono e rifiuta la coppia quando un confine qualsiasi deriva più della tolleranza. Due tabelle a quattro colonne con proporzioni diverse restano quindi separate anche quando tutto il resto combacia
Che cosa succede a una singola riga che sborda sulla pagina successiva?
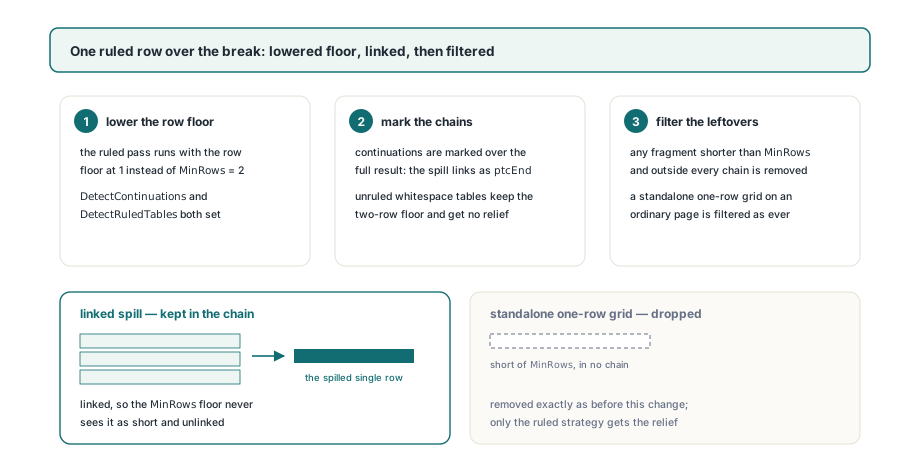
Una griglia con righe la cui ultima riga passa sulla pagina seguente viene ora rilevata e collegata, purché finisca in una catena di continuazione; da sola viene scartata. Il valore di default di MinRows, 2, esiste per evitare che un paio di linee sparse venga segnalato come tabella, ma un'ultima riga spinta oltre l'interruzione è una riga vera che una soglia fissa di 2 faceva sparire in silenzio, e il resto della tabella sembrava completo quando non lo era. La scansione a livello di documento la gestisce in tre passi. Quando DetectContinuations e DetectRuledTables sono entrambi attivi, il passaggio per pagina esegue il rilevatore di griglie con la soglia sulle righe abbassata temporaneamente a 1, ed è per questo che ExtractTables ora accetta MinRows pari a 1 per le griglie mentre il rilevamento su spaziature mantiene una soglia interna di 2. Le continuazioni vengono marcate sull'intero risultato. Poi ogni tabella più corta del MinRows del chiamante e che non fa parte di alcuna catena viene rimossa. Il frammento di una sola riga sopravvive solo perché è stato collegato, e una griglia di una riga nel mezzo di una pagina per il resto ordinaria viene filtrata esattamente come prima
// Ricostruisci ogni catena come un unico CSV, scartando le righe di
// intestazione ripetute sui frammenti di continuazione
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // intestazione ripetuta dal word processor
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
Due dettagli in quella routine sono voluti. La riga sbordata non viene mai eliminata, perché la guardia su RowCount la conserva, e un word processor che ripete la riga di intestazione su ogni pagina produce un frammento la cui prima riga è di nuovo l'intestazione, quindi eliminare la riga zero sui frammenti middle ed end è giusto per quel caso e sbagliato per un generatore che non ripete le intestazioni. Prova su un documento prima di scatenare la routine su un'intera cartella
Dove le regole si fermano ancora
Il test basato sul contenuto vale solo quanto il livello di testo che legge. Su una pagina scansionata senza alcun testo, gli estremi del testo di corpo registrati ricadono sui limiti della pagina, la condizione "niente in mezzo" è soddisfatta a vuoto, e restano solo i cancelli della riga di didascalia e delle colonne; una griglia su una pagina del genere viene comunque trovata come scheletro vuoto, quindi la catena può collegarsi correttamente, ma del testo circostante non è stato verificato nulla. Aggiungi prima un livello di testo se la cosa conta. I piè di pagina resi come immagini invece che come testo sono invisibili alla logica delle fasce e innocui per lo stesso motivo
Le fasce sono un solo numero. Un piè di pagina più profondo di ContinuationMargin lascia le sue righe inferiori dentro la zona del corpo, il che fa sembrare il frammento precedente seguito da testo e blocca il collegamento; alza l'opzione alla profondità reale della fascia, come fa il primo esempio. Alzala troppo e un breve paragrafo di chiusura vicino al fondo della pagina scivola nella fascia e viene ignorato, il che collega una tabella a qualunque cosa la segua. La regola della didascalia ha un guasto speculare: un generatore che scrive un banner unito "continued" come prima riga di ogni frammento di continuazione si vedrà rifiutare quei frammenti come nuove tabelle, e l'unico rimedio oggi è cucire da soli tramite ContinuationGroup senza allentare nulla, perché la regola non ha un interruttore
Le tabelle rilevate su spaziature non ottengono alcun sollievo per la riga singola. La strategia sulle spaziature ha bisogno di due righe allineate per vedere una tabella, quindi una tabella senza righe che sborda di una riga viene ancora segnalata più corta di quella riga. Quando ti capita, i box delle parole dietro i blocchi di testo strutturato e l'ordine di lettura ti danno le posizioni grezze per recuperarla. Sul set di campioni che ha guidato questo lavoro, tredici export da word processor e browser, i cinque documenti con vere tabelle multipagina si sono tutti collegati in catene singole e il modulo in stile verbale che prima si fondeva è rimasto separato, che è l'asticella con cui la release è stata misurata, non una promessa su ogni impaginazione
La marcatura delle continuazioni, la regola della didascalia e il passaggio per la riga singola vivono tutti nel percorso a livello di documento condiviso dalle build Delphi, C++Builder e Lazarus; l'API completa di estrazione delle tabelle è descritta nella pagina di PDFium Component per Delphi