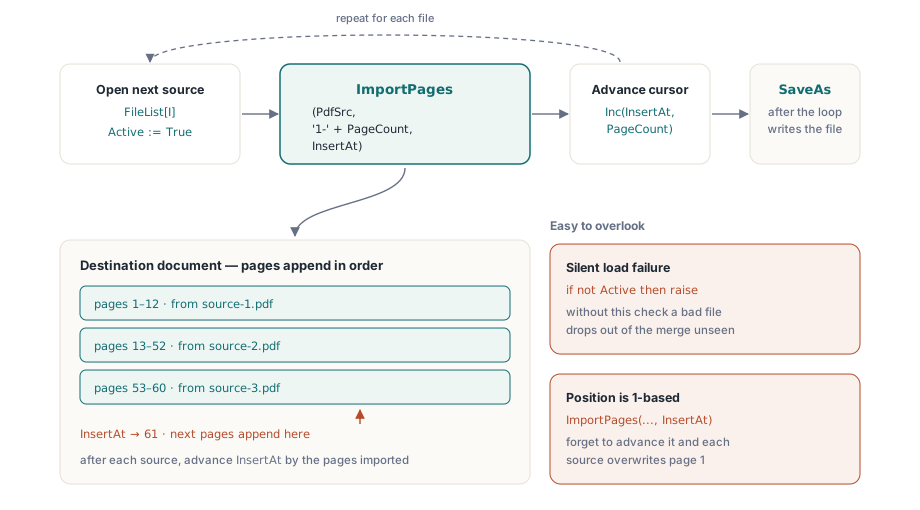
PDFium Component espone la fusione dei PDF attraverso un unico metodo: ImportPages. Lo schema è sempre lo stesso: create un documento di destinazione vuoto, aprite ogni file sorgente, chiamate ImportPages per copiarne le pagine, chiudete la sorgente e ripetete. Quando il ciclo termina, SaveAs scrive il risultato su disco. Non esiste una modalità di fusione speciale, nessuna configurazione da attivare. La complessità vive nei casi limite, e ce ne sono alcuni che mordono senza preavviso
Il ciclo principale
Vi bastano due istanze di TPdf. Una contiene il documento di destinazione, creato vuoto con CreateDocument. L'altra apre a turno ogni file sorgente. Di seguito una procedura che prende un elenco di percorsi di file e scrive l'output unito in un unico percorso:
procedure MergeFiles(const FileList: TStrings; const OutputPath: string);
var
  PdfDest, PdfSrc: TPdf;
  InsertAt, I: Integer;
begin
  PdfDest := TPdf.Create(nil);
  PdfSrc  := TPdf.Create(nil);
  try
    PdfDest.CreateDocument;
    InsertAt := 1;  // ImportPages usa una posizione di destinazione in base 1

    for I := 0 to FileList.Count - 1 do
    begin
      PdfSrc.FileName := FileList[I];
      PdfSrc.Active   := True;

      if not PdfSrc.Active then
        raise Exception.CreateFmt('Cannot open: %s', [FileList[I]]);

      PdfDest.ImportPages(
        PdfSrc,
        '1-' + IntToStr(PdfSrc.PageCount),  // intervallo dell'intero documento
        InsertAt);

      Inc(InsertAt, PdfSrc.PageCount);
      PdfSrc.Active := False;
    end;

    PdfDest.SaveAs(OutputPath);
  finally
    PdfSrc.Free;
    PdfDest.Free;
  end;
end;
Due cose in quel codice sono facili da trascurare a una prima lettura. La prima è il modo in cui PDFium segnala i fallimenti di caricamento. Active := True non solleva mai un'eccezione: se il file manca, è danneggiato o è protetto da password, PDFium intercetta l'errore internamente e lascia Active a False. Senza il controllo esplicito alla riga 10, un file difettoso uscirebbe silenziosamente dalla fusione senza alcuna traccia nell'output. Il PDF finale avrebbe meno pagine del previsto e non sapreste quale file sia il colpevole
La seconda è il contatore InsertAt. Il terzo argomento di ImportPages è la posizione in base 1 nella destinazione in cui atterra la prima pagina importata. Partire da 1 mette il primo documento sorgente all'inizio di un file altrimenti vuoto. Dopo ogni sorgente il contatore avanza di PdfSrc.PageCount, così il gruppo di pagine successivo si accoda all'ultimo. Dimenticate di incrementarlo e ogni sorgente successiva sovrascrive le pagine alla posizione 1, lasciandovi l'ultimo documento dell'elenco e nient'altro
Intervalli di pagine selettivi
Non siete obbligati a prendere ogni pagina da una sorgente. La stringa di intervallo passata come secondo argomento segue un semplice formato a virgole e trattini: "1-3" prende le pagine da 1 a 3, "2,4,6" sceglie tre pagine specifiche e "1-" significa dalla pagina 1 alla fine del documento. Gli intervalli possono essere combinati in una sola stringa, quindi "1-3,5,7-" salta le pagine 4 e 6. Qui conta una sottigliezza: i numeri si riferiscono sempre alle pagine del documento sorgente, a partire da 1, indipendentemente da dove quelle pagine finiscano nella destinazione. Se volete le pagine da 40 a 50 di un catalogo di 200 pagine, la stringa di intervallo è "40-50", non una posizione relativa a ciò che è già nella destinazione
// Estrae la copertina e un riepilogo esecutivo di tre pagine da un lungo report
PdfSrc.FileName := 'annual-report.pdf';
PdfSrc.Active   := True;
if PdfSrc.Active then
begin
  // La pagina 1 è la copertina; le pagine 3-5 sono il riepilogo
  PdfDest.ImportPages(PdfSrc, '1,3-5', InsertAt);
  Inc(InsertAt, 4);  // 1 copertina + 3 pagine di riepilogo = 4 pagine aggiunte
  PdfSrc.Active := False;
end;
Quando calcolate l'incremento di InsertAt, contate le pagine che avete effettivamente importato, non il numero di pagine della sorgente. Se passate '1,3-5' avete importato 4 pagine, quindi avanzate di 4. Avanzare di PdfSrc.PageCount lascerebbe un vuoto di posizioni libere nella destinazione e collocherebbe il documento sorgente successivo più avanti nel file di quanto previsto
Cosa ImportPages conserva e cosa no
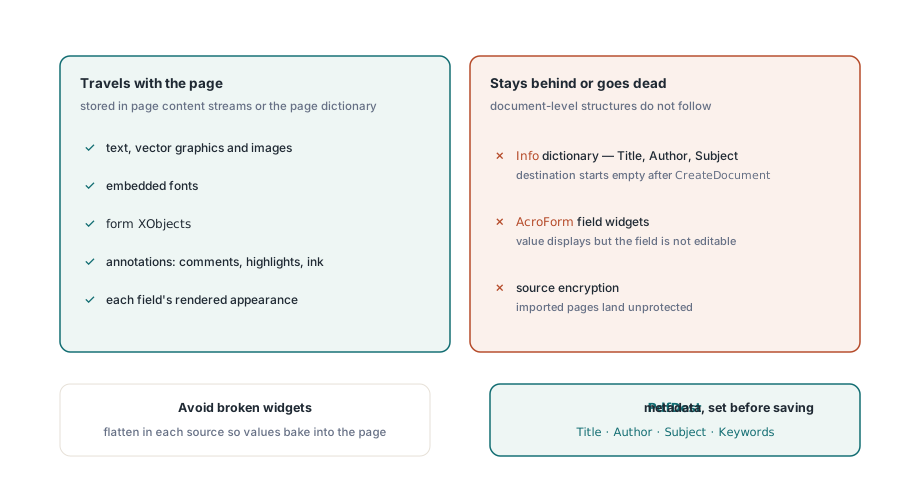
Le pagine copiate da ImportPages portano con sé intatto il contenuto visibile. Testo, grafica vettoriale, immagini raster, font incorporati e form XObject vengono trasferiti tutti come parte dei content stream di pagina. Anche le annotazioni a livello di pagina, inclusi commenti, evidenziazioni e tratti a mano libera, passano, perché sono memorizzate nel dizionario di pagina anziché a livello di documento
I metadati a livello di documento sono un altro discorso. Le stringhe di titolo, autore, oggetto e parole chiave nel dizionario Info della sorgente restano indietro. Il documento di destinazione parte con metadati vuoti dopo CreateDocument, quindi se l'output unito ha bisogno di quei campi popolati dovete assegnarli direttamente a PdfDest prima di chiamare SaveAs. Le proprietà Title, Author, Subject, Keywords e Creator su TPdf accettano stringhe semplici e scrivono nel dizionario Info al salvataggio
I campi modulo interattivi sono più complicati. Le definizioni dei campi AcroForm risiedono in un dizionario a livello di documento anziché dentro i singoli stream di pagina. Quando ImportPages copia una pagina che contiene campi modulo, l'aspetto visivo di quei campi viene trasferito perché è renderizzato nel content stream della pagina, ma i widget di campo che li rendono interattivi fanno parte della struttura AcroForm e non seguono. In una fusione tipica un campo di testo di un documento sorgente mostrerà il valore che aveva al momento dell'importazione, ma non sarà modificabile nel file unito. Se avete bisogno che i campi restino compilabili, appiattiteli in ogni documento sorgente prima di importarli: così i valori correnti vengono fissati nel content stream e l'overlay interattivo viene rimosso, dandovi un risultato visivo pulito senza widget rotti nell'output
File sorgente cifrati
I documenti sorgente protetti da password si aprono allo stesso modo di quelli non cifrati, con una sola proprietà in più da impostare prima. Assegnate la password a PdfSrc.Password prima di portare Active := True, e PDFium la userà durante l'apertura:
PdfSrc.Password := 'user-password';
PdfSrc.FileName := 'protected.pdf';
PdfSrc.Active   := True;
if not PdfSrc.Active then
  raise Exception.Create('Wrong password or file cannot be opened');

PdfDest.ImportPages(PdfSrc, '1-' + IntToStr(PdfSrc.PageCount), InsertAt);
Inc(InsertAt, PdfSrc.PageCount);
PdfSrc.Active := False;
Una password sbagliata produce lo stesso esito silenzioso Active = False di un file mancante, quindi il controllo esplicito è altrettanto necessario qui. La cifratura non si trasferisce alla destinazione: le pagine importate da una sorgente protetta atterrano nella destinazione come contenuto non protetto. Se anche l'output unito ha bisogno di cifratura, configuratela su PdfDest prima di chiamare SaveAs
Salvare il risultato
SaveAs su TPdf accetta un percorso di file oppure un TStream. Per la maggior parte delle fusioni, l'overload su file è quello che vi serve:
PdfDest.SaveAs('merged-output.pdf');Il secondo argomento opzionale è un TSaveOption che controlla la modalità di salvataggio. Il valore predefinito, saNone, scrive un aggiornamento incrementale se il documento è stato caricato da un file, oppure una riscrittura completa se è stato creato da zero. Poiché una destinazione costruita con CreateDocument è sempre nuova, l'output sarà un file compatto a revisione singola. Il terzo argomento, TPdfVersion, vi permette di fissare l'intestazione di versione PDF quando avete consumatori a valle che richiedono una versione specifica; lasciarlo a pvUnknown lascia scegliere a PDFium in base al contenuto
I metodi ImportPages e SaveAs mostrati qui fanno parte di PDFium Component per Delphi e C++Builder