PDFium Component vi dà un solo metodo per dividere i PDF: ImportPages. Tutto il resto, che stiate isolando una singola pagina, tagliando su confini arbitrari o seguendo la struttura dei segnalibri del documento, sono soltanto modi diversi di decidere quali numeri di pagina finiscono in ciascun file di output. La meccanica resta la stessa. Capirlo presto risparmia molte strade sbagliate
Come funziona il ciclo di divisione
Lo schema è lo stesso indipendentemente da come dividete il documento sorgente. Create una nuova istanza di TPdf, chiamate CreateDocument su di essa per inizializzare un PDF vuoto in memoria, importate le pagine che volete con ImportPages, salvate il risultato, poi riportate Active a False prima dell'iterazione successiva. Quell'ultimo passo è quello che sfugge: CreateDocument non chiude implicitamente il documento ancora in memoria, quindi dovete salvare il vostro output e riportare esplicitamente Active := False prima di chiamarlo di nuovo; il reset preventivo mantiene lo stato pulito e ben definito. L'istanza esterna di TPdf viene riusata in tutte le iterazioni, il che tiene bassa la pressione sulle allocazioni nei lavori grandi
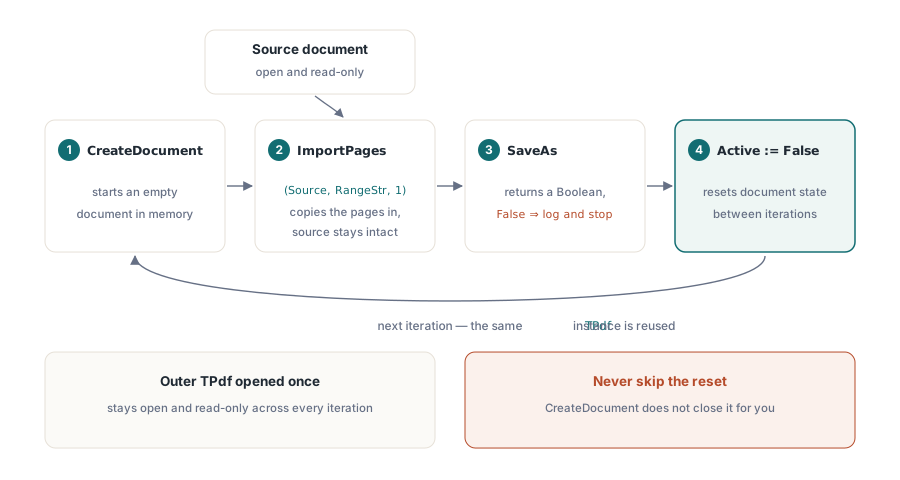
Ecco come appare la divisione pagina per pagina ridotta all'essenziale:
procedure SplitIntoPages(Source: TPdf; const OutputDir: string);
var
  I: Integer;
  PdfOut: TPdf;
  OutFile: string;
begin
  PdfOut := TPdf.Create(nil);
  try
    for I := 1 to Source.PageCount do
    begin
      PdfOut.CreateDocument;

      // Range è una stringa di pagine in base 1; punto di inserimento 1 = prima posizione
      if not PdfOut.ImportPages(Source, IntToStr(I), 1) then
        raise Exception.CreateFmt('Failed to import page %d', [I]);

      OutFile := OutputDir + '\page_' + Format('%.4d', [I]) + '.pdf';
      if not PdfOut.SaveAs(OutFile) then
        raise Exception.Create('Failed to save ' + OutFile);

      PdfOut.Active := False;   // reset prima del prossimo CreateDocument
    end;
  finally
    PdfOut.Free;
  end;
end;
Il parametro Range di ImportPages usa lo stesso formato di stringa che PDFium adopera internamente: un elenco separato da virgole di numeri di pagina o di intervalli delimitati da trattino, tutti in base 1. '3' importa la pagina 3. '1-5' importa le pagine da 1 a 5 in ordine. '2,5,8' importa quelle tre pagine. Il terzo parametro è la posizione di inserimento in base 1 nel documento di destinazione; passare 1 colloca sempre le pagine importate all'inizio di un file altrimenti vuoto, che è ciò che serve qui
Dividere per intervalli di pagine
Quando il chiamante fornisce un elenco come 1-12,13-24,25-36, lo analizzate in coppie inizio/fine ed eseguite lo stesso ciclo, costruendo la stringa di intervallo da ciascuna coppia:
procedure SplitByRanges(Source: TPdf; const RangeList: array of string;
  const OutputDir: string);
var
  I: Integer;
  PdfOut: TPdf;
  OutFile: string;
begin
  PdfOut := TPdf.Create(nil);
  try
    for I := 0 to High(RangeList) do
    begin
      PdfOut.CreateDocument;
      if not PdfOut.ImportPages(Source, RangeList[I], 1) then
        raise Exception.Create('Invalid page range: ' + RangeList[I]);
      OutFile := Format('%s\section_%d.pdf', [OutputDir, I + 1]);
      if not PdfOut.SaveAs(OutFile) then
        raise Exception.Create('Failed to save ' + OutFile);
      PdfOut.Active := False;
    end;
  finally
    PdfOut.Free;
  end;
end;
La validazione prima di arrivare a ImportPages conta qui. ImportPages restituisce False quando un numero di pagina nella stringa di intervallo supera Source.PageCount, ma non solleva un'eccezione e non produce un file di output parziale che possiate individuare dal solo nome. Controllate il valore restituito da SaveAs e registrate i fallimenti separatamente; un intervallo che produce un file di output vuoto non è palesemente sbagliato finché qualcuno non lo apre
Dividere sui confini dei segnalibri
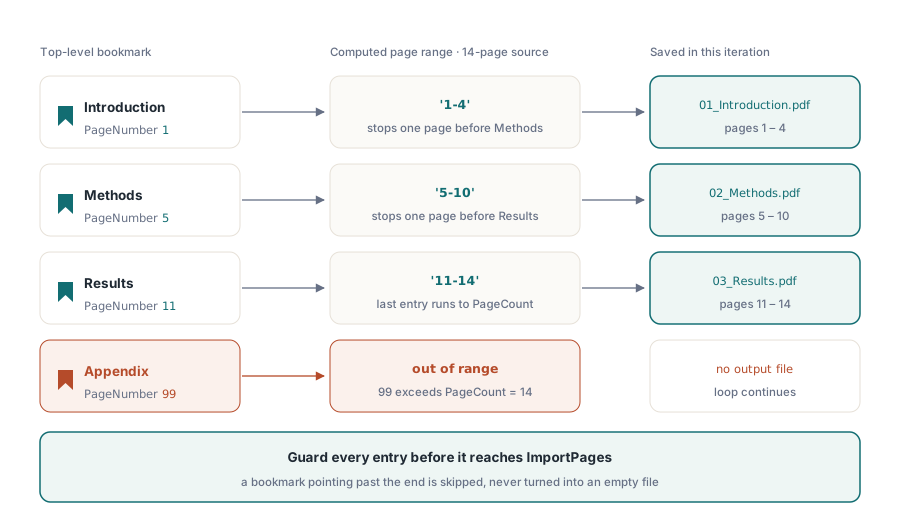
Il terzo approccio usa la struttura del documento stesso invece di un elenco fornito dall'esterno. Ogni segnalibro di primo livello porta con sé un numero di pagina di destinazione; la sezione che definisce va da quella pagina fino a una prima della pagina del segnalibro successivo, oppure fino alla fine del documento per l'ultima voce
procedure SplitByBookmarks(Source: TPdf; const OutputDir: string);
var
  Bm: TBookmarks;
  I, StartPage, EndPage: Integer;
  PdfOut: TPdf;
  RangeStr, OutFile, SafeTitle: string;
begin
  Bm := Source.Bookmarks;
  if Length(Bm) = 0 then
    Exit;

  PdfOut := TPdf.Create(nil);
  try
    for I := 0 to High(Bm) do
    begin
      StartPage := Bm[I].PageNumber;
      if I < High(Bm) then
        EndPage := Bm[I + 1].PageNumber - 1
      else
        EndPage := Source.PageCount;

      if (StartPage < 1) or (EndPage < StartPage) then
        Continue;

      RangeStr := Format('%d-%d', [StartPage, EndPage]);

      PdfOut.CreateDocument;
      if not PdfOut.ImportPages(Source, RangeStr, 1) then
      begin
        PdfOut.Active := False;
        Continue;   // salta una sezione malformata invece di scrivere un file vuoto
      end;

      SafeTitle := StringReplace(Bm[I].Title, '/', '_', [rfReplaceAll]);
      SafeTitle := StringReplace(SafeTitle, ':', '_', [rfReplaceAll]);
      OutFile := Format('%s\%02d_%s.pdf', [OutputDir, I + 1, SafeTitle]);
      if not PdfOut.SaveAs(OutFile) then
        raise Exception.Create('Failed to save ' + OutFile);

      PdfOut.Active := False;
    end;
  finally
    PdfOut.Free;
  end;
end;
Un documento privo di segnalibri non è una condizione di errore da presentare all'utente come tale; significa soltanto che questa modalità di divisione non ha nulla su cui lavorare. La guardia Length(Bm) = 0 se ne occupa in silenzio. Ciò che vale la pena segnalare è quando il numero di pagina di un segnalibro sta fuori dall'intervallo del documento, cosa che accade nei file malformati in cui l'indice non è mai stato aggiornato dopo la cancellazione di pagine. Il controllo dei limiti su StartPage ed EndPage salta quelle voci invece di passare un intervallo spazzatura a ImportPages
Nomi dei file di output e il reset di Active
La sicurezza dei nomi di file ricavati dai segnalibri richiede attenzione esplicita. I titoli dei segnalibri possono contenere caratteri validi in una stringa PDF ma non in un percorso del filesystem. Come minimo, sostituite barra, barra rovesciata e due punti prima di costruire il percorso di output. Su Windows sono vietati anche *, ?, ", <, > e |; un semplice ciclo su un insieme fisso li copre senza tirare in ballo una regex
La riga Active := False alla fine di ogni iterazione merita enfasi perché è l'unico requisito non ovvio dello schema. CreateDocument non chiude implicitamente ciò che è aperto. Se Active è ancora True quando CreateDocument viene eseguito di nuovo, il documento ancora in memoria non è mai stato chiuso o salvato correttamente, e in quello stato non potete contare su un comportamento ben definito, quindi salvate e resettate esplicitamente prima di iniziare il documento successivo. Pensatelo come il compagno di try/finally: il blocco finally libera l'oggetto esterno; Active := False resetta lo stato del documento interno fra un'iterazione e l'altra
L'uso di memoria in un lavoro di divisione grande resta piatto con questo approccio, perché non tenete mai più di un documento di output in memoria alla volta. Il documento sorgente resta aperto e in sola lettura per tutto il tempo; ImportPages copia i dati delle pagine nel nuovo documento senza modificare la sorgente. Se la sorgente è cifrata, apritela con la sua password prima del ciclo e le pagine copiate in ciascun file di output non saranno cifrate, che di solito è il comportamento giusto per output divisi distribuiti a destinatari diversi
Un'ultima cosa su SaveAs: restituisce un Boolean. Una directory di output che non esiste, un percorso con caratteri che il sistema operativo rifiuta o una condizione di disco pieno faranno tutti restituire False a SaveAs senza sollevare un'eccezione. In un lavoro batch che divide un documento di 200 pagine in 200 file di una pagina, un fallimento silenzioso alla pagina 147 è facile da non notare. Controllate il valore restituito a ogni chiamata e confrontate i successi con il totale atteso quando il ciclo finisce
I metodi ImportPages e CreateDocument mostrati qui fanno parte di PDFium Component per Delphi e C++Builder