Una cartella di lavoro ODS con una pivot passa per una libreria, si modifica una singola cella sorgente, e il file salvato si apre con tutti i valori delle celle al loro posto e la pivot sparita: content.xml conteneva un <table:data-pilot-table> all'ingresso e ne contiene zero all'uscita. La riparazione ovvia è copiare l'XML della pivot come stringa. Questo riporta il conteggio degli elementi, e poi un parser namespace-aware rifiuta la parte salvata in blocco con un errore di prefisso non dichiarato. I due fallimenti hanno una sola radice. Un pezzo di XML viaggia in sicurezza solo quando le dichiarazioni di namespace da cui dipende viaggiano con lui
Dove vive una definizione di pivot ODS in content.xml
Una pivot table OpenDocument, che il formato chiama data pilot, è una definizione memorizzata dopo i fogli in content.xml, e uno writer che ricostruisce quella parte dal proprio object model la conserva solo se il modello ha un posto dove metterla. ODF 1.3 Part 3 §9.6 descrive il contenitore: <table:data-pilot-tables> contiene una <table:data-pilot-table> per pivot, ciascuna con un table:source-cell-range, un insieme di figli table:data-pilot-field, un table:target-range-address e un elenco table:buttons. Le celle risultato che la pivot mostra stanno dentro il foglio di lavoro come celle ordinarie. Quindi uno writer che rigenera solo celle, stili, validazioni, named expressions e database ranges produce un foglio di calcolo perfettamente valido con gli stessi numeri a schermo e nessuna pivot dietro
HotXLS Delphi Excel Component legge l'intero sottoalbero <table:data-pilot-tables> da content.xml durante OpenODS, prima di analizzare una singola cella, e poi prova a tradurre la collezione nel suo modello di pivot. Una definizione nella forma semplice che il modello rappresenta, con un intervallo sorgente locale, un campo di riga, misure aggregate e risultati memorizzati che combaciano con i dati sorgente, diventa una TXLSPivotTable nell'elenco PivotTables del foglio di lavoro, lo stesso oggetto che ottieni da una pivot XLSX e puoi estendere con campi calcolati e aggiornare da Delphi. Tutto ciò che esce da quella forma mantiene la collezione come XML catturato, e SaveAsODS la riscrive. Un attributo in un namespace che il traduttore non conosce basta: le pivot salvate da LibreOffice possono portare attributi loext: e calcext:, e un attributo loext: manda la definizione sulla strada della cattura
Il fallback è tutto o niente per cartella di lavoro. Se una pivot su tre di una collezione esce dalla forma traducibile, tutte e tre restano come XML catturato. Dividerle lascerebbe content.xml con due fonti di verità per un solo contenitore, metà ricostruita dagli oggetti e metà rigiocata dal testo, e qualsiasi disaccordo tra le due metà finirebbe nel file dell'utente. Tenere la collezione intera è l'impostazione predefinita più sicura, ed è la stessa policy che HotXLS applica ai blocchi extLst sconosciuti in XLSX: ciò che il modello non sa trasportare resta come scritto
Perché una definizione di pivot tagliata a pezzi rompe il file salvato?
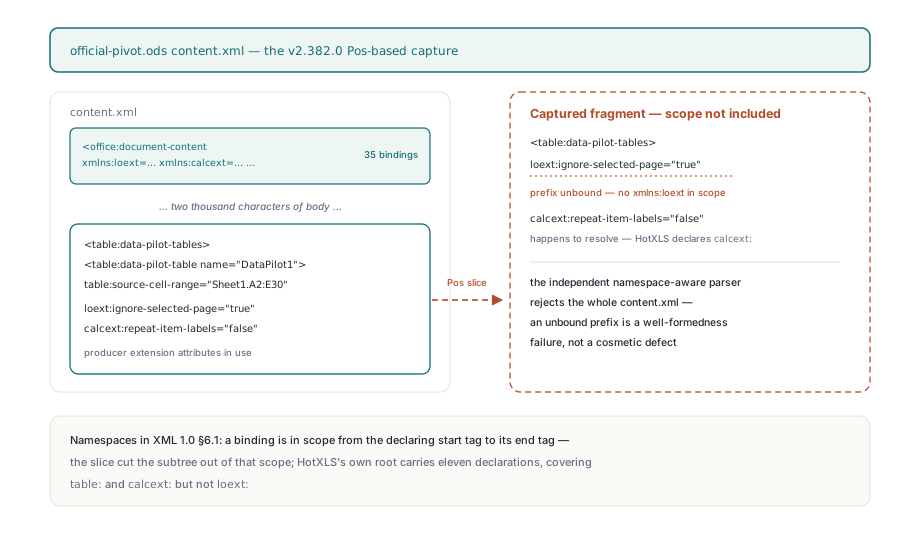
Una definizione di pivot ritagliata da content.xml con una ricerca di stringa perde le dichiarazioni di namespace che danno significato ai suoi prefissi, e Namespaces in XML tratta un prefisso senza dichiarazione come un errore di well-formedness. L'approccio a stringa è breve: decodificare la parte in un WideString, trovare <table:data-pilot-tables con Pos, trovare il tag di chiusura corrispondente dopo di esso, e copiare tutto ciò che sta in mezzo. Il testo che ne esce sembra completo. Contiene loext:ignore-selected-page="true" su un campo di pagina e calcext:repeat-item-labels="false" su ogni livello, ma le dichiarazioni xmlns:loext e xmlns:calcext che legano quei prefissi stanno sulla radice del documento, <office:document-content>, migliaia di caratteri prima
Namespaces in XML 1.0 §6.1 mette una dichiarazione in scope dal tag di apertura che la porta al tag di chiusura corrispondente, e ogni nome con prefisso all'interno si risolve contro di essa. Taglia un sottoalbero fuori dal documento e lo taglia fuori da quello scope. Quando il frammento viene incollato in un nuovo documento, ogni prefisso si risolve solo se la nuova radice per caso lo dichiara. HotXLS scrive il suo <office:document-content> con i namespace che il suo writer usa, tra cui office, table, text, style, fo, draw, calcext, tableooo e of. Nella copia tagliata table: si risolve, calcext: si risolve, e loext: no. Un solo prefisso senza binding basta perché un parser namespace-aware rifiuti l'intera parte, quindi la pivot non degrada con eleganza; anche i dati del foglio attorno diventano illeggibili
La ricerca di stringa ha altri punti ciechi che una cattura basata su reader non incontra mai. Pos combacia con il testo del tag dentro un commento, dentro una sezione CDATA o dentro un valore di attributo che lo cita. Non sa distinguere elementi annidati con lo stesso nome. E combacia con il prefisso letterale table:, mentre ODF consente a un produttore di legare il namespace table al prefisso che preferisce
Come HotXLS porta lo scope dei namespace sul frammento
HotXLS cattura il sottoalbero della pivot con un reader XML streaming che tiene traccia di ogni dichiarazione di namespace insieme alla profondità a cui è comparsa, e copia le dichiarazioni ancora in vigore sul tag di apertura del frammento nel momento in cui arriva l'elemento bersaglio. Lo stack cresce a ogni tag di apertura che dichiara xmlns o xmlns:prefisso e si riduce quando l'elemento che ha dichiarato un binding si chiude. Gli elementi vuoti richiedono lo stesso trattamento: <x xmlns:p="..."/> non produce mai un evento di end tag separato, quindi la pop deve scattare anche sul tag di apertura vuoto, altrimenti un binding si versa negli elementi fratelli
All'obiettivo, la cattura percorre lo stack dal binding più interno verso l'esterno e scrive ogni prefisso una volta sola. Percorrere dall'interno verso l'esterno è ciò che implementa lo shadowing. Se <office:spreadsheet> ribinde un prefisso che la radice ha già dichiarato, il valore più vicino è quello in vigore alla pivot, esattamente come richiede il §6.1, e un insieme di prefissi già scritti impedisce al valore esterno di seguire. Un prefisso che l'elemento pivot dichiara su se stesso viene saltato, perché scrivere xmlns:table due volte sullo stesso tag è un altro errore di well-formedness
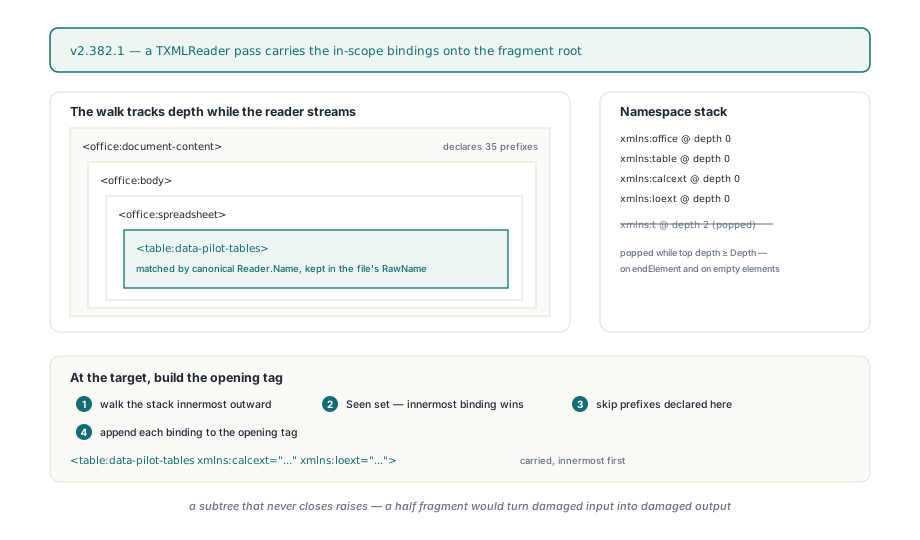
L'obiettivo viene abbinato per namespace, quindi un produttore che scrive <t:data-pilot-tables> con t legato all'URI table di ODF viene comunque riconosciuto, mentre i tag catturati conservano la grafia del file. I nodi di testo con spazi tornano esattamente come scritti. Le virgolette degli attributi e la scelta tra <x/> e <x></x> vengono normalizzate, perché il frammento viene risezializzato dagli eventi del reader invece di essere copiato byte per byte. Se content.xml finisce mentre il sottoalbero della pivot è ancora aperto, come accade in un file troncato, l'apertura fallisce con un'eccezione invece di conservare mezza definizione che verrebbe riscritta al salvataggio successivo
L'insieme trasportato è volutamente generoso. La cattura copia ogni binding in scope, usato o no dal sottoalbero, quindi la radice del frammento ripete xmlns:table e xmlns:calcext anche se la radice del documento salvato le dichiara a sua volta. Rideclarare un prefisso in uno scope annidato è legale sotto Namespaces in XML, e un file di un produttore che dichiara decine di namespace sulla radice guadagna un paio di kilobyte. Potare l'elenco significherebbe scandire il sottoalbero alla ricerca di ogni prefisso nei nomi di elemento, nei nomi di attributo e nei valori di attributo che contengono QName, e un solo mancato lì fa tornare dritto l'errore di prefisso non dichiarato. Poche dichiarazioni ridondanti costano molto meno di quel rischio
Aprire, modificare e salvare una cartella di lavoro che porta una pivot
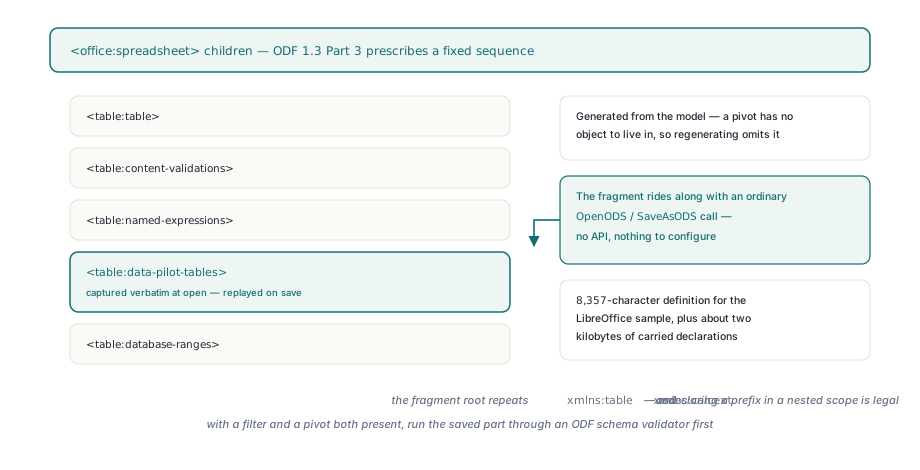
Dal lato chiamante non c'è nulla da attivare: la definizione della pivot viaggia insieme a un normale OpenODS e SaveAsODS. I fogli di lavoro si numerano da 1, e entrambi i metodi restituiscono 1 in caso di successo:
uses
  System.SysUtils, lxHandleX;

procedure EditPivotSource(const InFile, OutFile: string);
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    if Book.OpenODS(InFile) <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InFile]);
    // E2 sta dentro un intervallo sorgente pivot di Sheet1.A2:E30
    Book.Sheets[1].Cells[2, 5].Value := 1250.0;
    if Book.SaveAsODS(OutFile) <> 1 then
      raise Exception.CreateFmt('Cannot save %s', [OutFile]);
  finally
    Book.Free;
  end;
end;
Nel content.xml salvato, la collezione delle pivot sta dentro <office:spreadsheet> subito dopo le <table:named-expressions> generate dal writer e prima di <table:database-ranges>. Una cartella di lavoro che porta sia un AutoFilter, che HotXLS scrive come database range, sia una pivot mette i due elementi uno accanto all'altro, e se la tua pipeline esegue un validatore rigoroso dello schema ODF, quella coppia è il posto dove guardare per primo
La modifica dell'esempio cambia un valore sorgente e lascia le celle risultato della pivot com'erano. Una definizione catturata viene rigiocata come scritta: HotXLS non la ricalcola, e l'applicazione per fogli di calcolo che apre il file ricalcola la pivot al suo prossimo refresh. Lo stesso vale per i suoi indirizzi. Rinomina Sheet1 o sposta il blocco sorgente, e la definizione salvata continua a puntare a Sheet1.A2:E30, che l'applicazione consumatrice segnala come intervallo rotto al refresh. Tieni stabili i nomi dei fogli e il blocco sorgente in ogni cartella di lavoro le cui pivot viaggiano così
Quale strada ha preso una data pivot?
Il controllo più rapido è l'elenco PivotTables del foglio di lavoro: una definizione tradotta compare lì come TXLSPivotTable, una catturata no. Il report di conversione risponde alla seconda metà della domanda, cosa succederebbe alla pivot in un formato di output diverso. GetConversionReport ispeziona la cartella di lavoro senza salvarla né ricalcolarla, e il report restituito appartiene a chi lo chiama:
uses
  System.SysUtils, lxHandleX, lxDiagnostics;

function DescribeOdsPivots(Book: TXLSXWorkbook): string;
var
  I, Modeled: Integer;
  Report: TXLSConversionReport;
begin
  Modeled := 0;
  for I := 1 to Book.Sheets.Count do          // Sheets è 1-based
    Inc(Modeled, Book.Sheets[I].PivotTables.Count);

  Report := Book.GetConversionReport(xlsConversionOpenXmlWorkbook);
  try
    for I := 0 to Report.Count - 1 do
      if (Report[I].Feature = 'OpenDocumentPivotTables') and
         (Report[I].Fidelity = xlsConversionDropped) then
        Exit('Captured ODF pivot XML: keep this workbook on .ods');
  finally
    Report.Free;
  end;

  if Modeled > 0 then
    Result := Format('%d pivot table(s) in the pivot model', [Modeled])
  else
    Result := 'No pivot definitions';
end;
Il percorso di output conta perché l'XML catturato è vocabolario ODF e solo lo writer ODS lo emette. Salvato come .xlsx, la collezione catturata non ha una controparte SpreadsheetML, e il report la elenca sotto OpenDocumentPivotTables con xlsConversionDropped. Lo writer binario .xlsb rifiuta una cartella di lavoro che la contiene ancora. Una pivot tradotta è un oggetto del modello ordinario e segue le regole del formato di destinazione. Le differenze tra i percorsi di import ed export ODS valgono qui come ovunque, e per file con pivot la strada sicura è .ods in entrata, .ods in uscita
Un'ulteriore regola discende dal fallback tutto-o-niente. Una cartella di lavoro o rigioca una collezione catturata o scrive le sue pivot dal modello; non mescola mai le due cose in uno stesso content.xml. Aggiungere una pivot con AddPivotTable a una cartella di lavoro che contiene già XML di pivot catturato fa fermare il salvataggio ODS con un errore, invece di cucire XML generato accanto a XML rigiocato
Controllare la parte salvata con un secondo parser
Un conteggio di elementi non prova nulla sui namespace. Un'espressione regolare che trova tag di apertura data-pilot-table nel content.xml salvato vede testo, e la copia tagliata della seconda sezione supera quel test. Un parser namespace-aware che non c'entra nulla con la libreria che ha scritto il file è un giudice molto più severo, e Delphi ne ha già uno a bordo. La funzione qui sotto è un controllo da aggiungere alla tua suite di test; TZipFile e TXMLDocument vengono dalla RTL Delphi, non da HotXLS:
uses
  System.SysUtils, System.Classes, System.Zip,
  Xml.xmldom, Xml.XMLIntf, Xml.XMLDoc;

// Helper di test tuo: True quando content.xml di un pacchetto .ods
// si carica in un parser DOM namespace-aware
function OdsContentParses(const OdsFile: string; out Error: string): Boolean;
var
  Zip: TZipFile;
  Bytes: TBytes;
  Stream: TBytesStream;
  Doc: IXMLDocument;
begin
  Error := '';
  Zip := TZipFile.Create;
  try
    Zip.Open(OdsFile, zmRead);
    Zip.Read('content.xml', Bytes);
  finally
    Zip.Free;
  end;
  Stream := TBytesStream.Create(Bytes);
  try
    Doc := TXMLDocument.Create(nil);
    try
      Doc.LoadFromStream(Stream);     // un prefisso senza binding fallisce qui
      Result := True;
    except
      on E: EDOMParseError do
      begin
        Error := E.Message;
        Result := False;
      end;
    end;
  finally
    Stream.Free;
  end;
end;
Eseguila su ogni .ods che il tuo codice salva, poi fai un passo in più per i file con pivot e confronta dopo il parsing il sottoalbero della pivot di input e di output: tag, attributi ordinati, testo e figli, ricorsivamente, con i nomi espansi in URI di namespace più nome locale. Quel confronto lascia passare un prefisso riscritto e becca uno senza binding, che è esattamente la linea tra innocuo e rotto. Dalle in pasto file di ogni produttore che i tuoi utenti usano davvero. Un documento che lega il namespace table a un prefisso diverso, dichiara un prefisso sull'elemento pivot stesso o ribinde un prefisso in <office:spreadsheet> mette alla prova le regole di salto e shadowing in un modo che un singolo file LibreOffice non fa
Il reader e il writer ODS, il modello di pivot per XLSX e ODS e il report di conversione usato qui sopra fanno tutti parte del HotXLS Delphi Excel Component; la pagina di prodotto copre il supporto completo di lettura e scrittura XLSX, XLS e ODS per Delphi e C++Builder