Il HotXLS Delphi Component valuta =1<2<3 come FALSE, la stessa risposta che dà Excel 16, perché dalla v2.384.3 il suo parser delle formule ripiega gli operatori di confronto da sinistra a destra: 1<2 diventa TRUE, e TRUE<3 è FALSE perché un boolean sta sopra ogni numero. La stessa release rende un operando vuoto uguale sia a 0 sia a "", e lascia che SUMIF allunghi un intervallo somma di una cella fino alla forma del suo intervallo dei criteri. Ognuna di queste sembra un'inezia finché un workbook calcolato in Delphi non è in disaccordo con lo stesso workbook aperto in Excel
Il disaccordo di solito parte da una formula scritta per intuizione. Qualcuno digita =0<B2<100 per controllare che una quantità sia nel range, Excel risponde in silenzio FALSE per ogni riga, e il foglio esce con quel bug cucito dentro. Un motore di calcolo non può sistemare le intenzioni dell'utente; il suo lavoro è produrre il valore che Excel produrrebbe, così che il risultato in cache che HotXLS scrive nel file combaci con ciò che Excel mostra dopo un ricalcolo. Prima della v2.384.3 HotXLS rispondeva TRUE per quel controllo di range su ogni riga, sbagliando nella direzione opposta, e un report generato su un server contraddiceva lo stesso report aperto su un desktop
Perché =1<2<3 restituisce FALSE in Excel?
Excel restituisce FALSE perché legge una catena di confronti come (1<2)<3, e il TRUE interno perde poi la gara di classificazione di tipo contro il numero 3. Il vecchio parser HotXLS leggeva lo stesso testo come 1<(2<3): TXLSSyntax.Parse_expr in lxFormula.pas analizzava un operando, vedeva un token di confronto e ricorreva in Parse_expr per il lato destro, il che rende l'operatore right-associative. Ne usciva 1<TRUE, e un numero sta sotto un boolean, quindi il risultato era TRUE. L'errore è simmetrico: =3>2>1 è TRUE in Excel ed era FALSE in HotXLS, e =1=1=TRUE è TRUE in Excel ed era FALSE prima della correzione. Il test di regressione CalculateFormula_ComparisonChainsFoldLeftToRight inchioda sette formule di questo tipo ai valori che restituisce Excel 16, e le fa girare tutte attraverso entrambe le architetture di engine, la classica TXLSWorkbook e la nativa XLSX TXLSXWorkbook, usando il metodo Calculate descritto in la panoramica del motore di formule di HotXLS
const
  Formulas: array [0..6] of string = ('=1<2<3', '=3>2>1', '=(1<2)<3',
    '=1<(2<3)', '=1=1=TRUE', '=3>2>1=TRUE', '=1<2<3=FALSE');
  // Ciò che Excel 16 restituisce:  FALSE, TRUE, FALSE, TRUE, TRUE, TRUE, TRUE
var
  Classic: IXLSWorkbook;
  Xlsx: TXLSXWorkbook;
  i: Integer;
begin
  Classic := TXLSWorkbook.Create;
  Xlsx := TXLSXWorkbook.Create;
  try
    // TXLSXWorkbook.Calculate valuta sul foglio attivo e
    // restituisce Null quando il workbook non ha proprio nessun foglio
    Xlsx.Sheets.Add('Data');
    for i := 0 to High(Formulas) do
      Writeln(Formulas[i], '  classic=', VarToStr(Classic.Calculate(Formulas[i])),
        '  xlsx=', VarToStr(Xlsx.Calculate(Formulas[i])));
  finally
    Xlsx.Free;
  end;
end;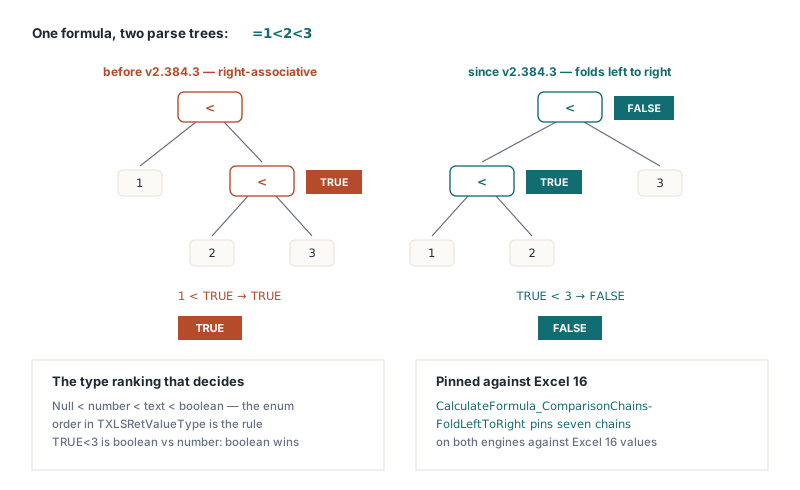
La correzione trasforma Parse_expr in un loop della stessa forma che Parse_expr1 già usava per +, - e &. Analizza il primo operando con Parse_expr1 e, finché il token successivo è uno tra =, <>, <, >, <= o >=, crea un nodo di confronto, attacca il risultato sinistro accumulato come primo figlio, analizza l'operando successivo con Parse_expr1 anziché con Parse_expr e fa del nuovo nodo il risultato sinistro per il round successivo. Due dettagli erano facili da sbagliare convertendo la ricorsione in iterazione, ed entrambi sono nelle note dei manutentori: il nodo accumulato va consegnato (lChild := Item; Item := nil) in quest'ordine, e il percorso di errore deve fare Exit dopo aver liberato il nodo a metà costruito invece di uscire dal loop restituendo un albero pendente
Come ordina HotXLS numeri, testo e boolean in un confronto?
HotXLS ordina i tipi misti come Excel: ogni numero è minore di ogni valore testuale, e ogni valore testuale è minore di ogni boolean. TXLSCalculator.CompareVariants in lxCalc.pas classifica entrambi gli operandi con GetRetValueType nell'enumerazione TXLSRetValueType = (xlVariantValue, xlNumberValue, xlStringValue, xlBooleanValue), e quando le due classi differiscono semplicemente confronta i loro ordinali, quindi l'ordine di dichiarazione di quell'enum è la regola tra tipi. Dentro una stessa classe il confronto è quello naturale, con una svolta specifica di Excel per il testo: entrambe le stringhe passano prima per lxUpperCase, quindi ="abc"="ABC" è TRUE. Questo ranking è la ragione per cui il risultato di una catena non si può ragionare senza di lui. TRUE<3 non è una coercizione di TRUE a 1, è un boolean confrontato con un numero, e vince il boolean. Le date sono numeri seriali per l'engine (varDate si classifica come xlNumberValue), quindi una data sta sempre sotto qualsiasi testo, compreso un testo che per caso assomiglia a una data
A cosa è uguale una cella vuota in un confronto?
Una cella vuota usata come operando di confronto vale 0 quando l'altro lato è un numero, vale "" quando l'altro lato è testo, e dalla v2.384.53 vale FALSE quando l'altro lato è un valore logico, così con A1 vuota =A1=0, =A1="" e =A1=FALSE sono tutti TRUE. TXLSCalculator.CompareVarValues, che serve tutti e sei gli operatori di confronto, sostituisce la vuota prima di chiamare CompareVariants: se esattamente un operando è Null diventa WideString('') quando il suo partner è una stringa, False quando il suo partner è un boolean, e 0 negli altri casi. Due vuote continuano a risultare uguali tra loro senza sostituzione. Il percorso aritmetico ha sempre trasformato una vuota in 0, ecco perché =A1+1 dava 1, ma CompareVariants tiene Null come suo gradino più basso, sotto ogni numero, e gli operatori di confronto usavano quel gradino direttamente
var
  Wb: IXLSWorkbook;
  Sh: TXLSWorksheet;
begin
  Wb := TXLSWorkbook.Create;
  Sh := Wb.Sheets.Add;
  Sh.Range['B1', 'B1'].Value := 5;      // A1 è lasciata vuota di proposito

  Writeln(VarToStr(Wb.Calculate('=A1=0')));    // True
  Writeln(VarToStr(Wb.Calculate('=A1=""')));   // True
  Writeln(VarToStr(Wb.Calculate('=A1<B1')));   // True: la vuota confronta come 0
  Writeln(VarToStr(Wb.Calculate('=A1<0')));    // False; True prima della v2.384.3
end;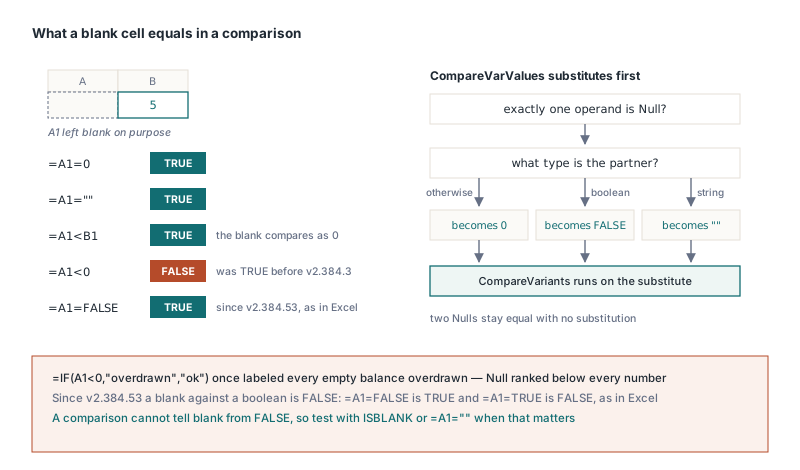
L'ultima riga è quella che ha fatto male nella pratica. Col vecchio ranking una vuota era più piccola di ogni numero, negativi compresi, quindi =IF(A1<0,"overdrawn","ok") etichettava ogni cella saldo vuota come scoperta, e =A1=0 era FALSE per una cella che qualunque utente descriverebbe come zero. Restava un confine dopo la v2.384.3: la sostituzione sceglieva solo tra 0 e la stringa vuota, quindi una vuota confrontata con un boolean diventava 0, che sta sotto sia TRUE sia FALSE, e =A1=FALSE su una A1 vuota valutava FALSE. Da HotXLS 2.384.53 una vuota confrontata con un valore logico è trattata come FALSE in entrambi gli engine XLS e XLSX, come fa Excel: con A1 vuota, =A1=FALSE e =A1<TRUE restituiscono TRUE e =A1=TRUE restituisce FALSE. Significa anche che il confronto non sa distinguere una vuota da FALSE, in Excel come in HotXLS; quando un foglio ha bisogno di quella distinzione, testate con ISBLANK o =A1=""
Perché SUMIF con intervallo somma a una cella restituiva 0?
SUMIF restituiva 0 perché HotXLS limitava l'iterazione al più piccolo dei due intervalli, mentre Excel mantiene la forma dell'intervallo dei criteri e usa l'intervallo somma solo per la sua cella in alto a sinistra. =SUMIF(A1:A10,">5",B1) significa quindi B1:B10 in Excel, una comodità su cui contano molti template costruiti a mano. Il worker condiviso TXLSCalculator.GetValueItemRange2 restringeva i suoi conteggi di righe e colonne a quelli dell'intervallo dei valori, il che riduceva l'esempio a un unico test di A1 contro B1. La v2.384.3 rimuove il clamp: il loop ora percorre l'intervallo dei criteri e legge ogni valore allo stesso offset dall'angolo in alto a sinistra dell'intervallo somma. Poiché CalcSumIF e CalcAverageIF chiamano entrambi quel worker, AVERAGEIF ottiene lo stesso ridimensionamento, e un intervallo somma più grande dell'intervallo dei criteri viene tagliato alla forma dei criteri per la stessa ragione. L'argomento dei criteri in mezzo è di classe valore e i due esterni sono di classe riferimento, la distinzione trattata in l'articolo su implicit intersection e classi di argomenti
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
  Row: Integer;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Sales');
    for Row := 1 to 10 do
    begin
      Sheet.Cells[Row, 1].Value := Row;          // colonna criteri: 1..10
      Sheet.Cells[Row, 2].Value := Row * 100;    // importi: 100..1000
    end;
    Sheet.Cells[1, 4].Formula := '=SUMIF(A1:A10,">5",B1)';     // intervallo somma a una cella
    Sheet.Cells[2, 4].Formula := '=SUMIF(A1:A10,">5",B1:B10)'; // intervallo somma esplicito
    if Book.Recalculate = lxOk then
      // D1 e D2 valgono entrambi 4000 (600+700+800+900+1000); D1 era 0 prima della v2.384.3
      Writeln(VarToStr(Sheet.Cells[1, 4].Value), ' ', VarToStr(Sheet.Cells[2, 4].Value));
  finally
    Book.Free;
  end;
end;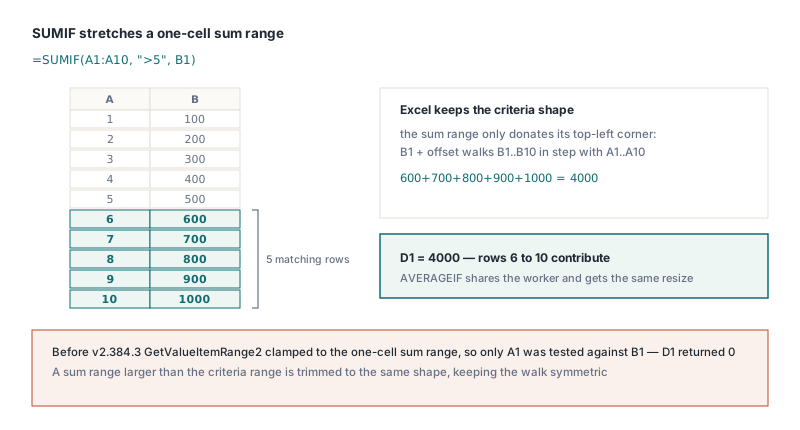
INDIRECT e YEARFRAC: due correzioni più silenziose
INDIRECT ora onora il suo secondo argomento, e il testo dopo un riferimento valido è un errore invece di essere ignorato. Con a1 FALSE il testo si analizza come R1C1 assoluto, quindi =INDIRECT("R2C3",FALSE) legge C2; il vecchio codice ignorava il flag, leggeva "R2" come colonna R, riga 2, e restituiva in silenzio la cella sbagliata. Il flag viene instradato sul suo tipo variant (boolean, numero o testo) perché convertire un variant stringa direttamente in Double solleva un'eccezione. Un testo R1C1 relativo come R[1]C[1] restituisce #REF!, visto che INDIRECT non ha una cella formula di origine contro cui risolverlo, e un testo A1 con caratteri in coda, "B2 junk", restituisce #REF! anch'esso. YEARFRAC con base 0 ora applica le regole NASD per l'ultimo di febbraio che DAYS360 implementava già: quando entrambe le date sono l'ultimo giorno di febbraio il giorno finale diventa 30, poi un inizio sull'ultimo giorno di febbraio diventa 30. Dal 2024-02-29 al 2025-02-28 il conteggio ora è 360 giorni, una frazione di esattamente 1, dove il precedente Days360US contava 359
Che cosa garantiscono queste correzioni, e qual è stata la lezione?
Il comportamento delle catene di confronto è garantito da un test che confronta entrambi gli engine con valori misurati in Excel 16, e quel test esiste perché la prima descrizione della correzione era sbagliata. La nota di rilascio della v2.384.3 diceva originariamente che il ripiegamento da sinistra a destra rendeva =1<2<3 TRUE, che è esattamente ciò che produceva il vecchio parser right-associativo e l'opposto di ciò che restituiscono sia Excel sia il nuovo codice. Nessuno aveva valutato l'esempio; era stato scritto dall'intuizione che "1 è minore di 2 che è minore di 3". La nota fu corretta e il test a sette formule aggiunto in un commit successivo, e la regola che ne è uscita vale per chiunque documenti semantiche di fogli di calcolo: fate girare l'esempio in Excel prima di scrivere il valore atteso. La sostituzione degli operandi vuoti e il ridimensionamento di SUMIF seguono lo stesso comportamento di Excel, compreso il caso vuota-contro-boolean dalla v2.384.53, e gli aggregati condizionali che devono anche saltare righe filtrate o nascoste seguono le regole separate in l'articolo su SUBTOTAL e AGGREGATE e le righe nascoste
HotXLS è un componente foglio di calcolo nativo per Delphi e C++Builder che legge, ricalcola e scrive XLS, XLSX, ODS e CSV senza Excel installato, e le regole di confronto, vuote e SUMIF descritte qui vivono nel motore di calcolo condiviso da entrambe le architetture di workbook. La lista completa delle funzioni e le opzioni di licenza sono sulla pagina del prodotto HotXLS Delphi spreadsheet component