Un nome definito che punta a un'intera colonna viene letto da Excel come una singola cella quando compare in posizione scalare: =Vertical+1 alla riga 7 significa "la cella di Vertical alla riga 7", non l'intera area. Il componente HotXLS per Delphi applica quella intersezione implicita su due livelli, in fase di valutazione e in fase di estrazione delle dipendenze, perché ottenere il valore giusto non basta. Un walker delle dipendenze che espande il nome alla sua area completa lascia che qualsiasi formula a valle che alimenta una cella di quell'area chiuda un ciclo che non esiste, e TXLSXWorkbook.Recalculate dovrebbe allora rifiutare l'intera cartella di lavoro come circolare
Una cartella di lavoro di ammortamento di un prestito con 4805 formule è il caso di stress che mette tutto questo all'opera. Ricalcolarla correttamente da cache stantie dipende da tre meccanismi separati: l'intersezione implicita per i nomi, l'ordinamento delle scansioni di ricerca, e il tipo numerico usato per l'aritmetica annidata. Sbagli uno qualunque dei tre e il sintomo è lxErrorRef, il codice di riferimento circolare, oppure totali che tendono a allontanarsi da un calcolo indipendente riga per riga. Questo articolo percorre ogni meccanismo con il codice che vi sta dietro
Perché un riferimento scalare a un nome di colonna crea un ciclo falso?
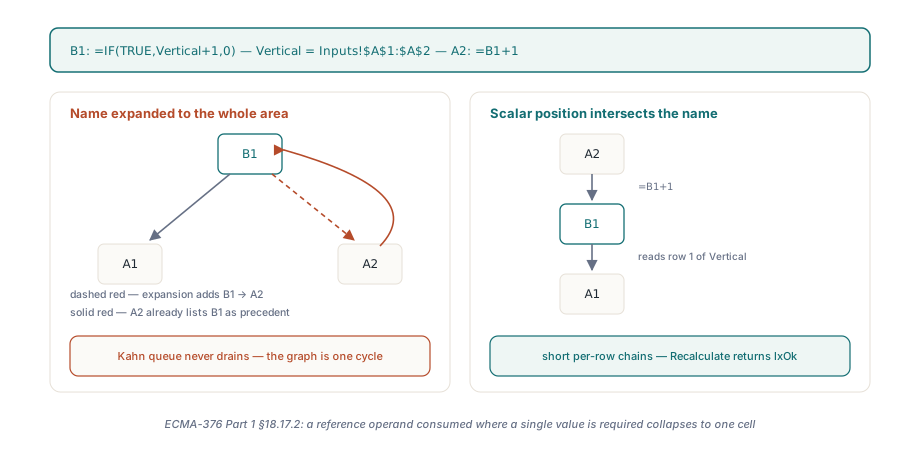
Perché un grafo di dipendenze conosce solo archi, e un arco da una formula a un'area di 480 righe sono 480 archi, uno dei quali punta all'indietro attraverso una cella che dipende dalla formula. Prendi =IF(TRUE,Vertical+1,0) in B1 con Vertical definito come Inputs!$A$1:$A$2, e =B1+1 in A2. Excel valuta B1 come A1+1 e A2 come B1+1, una catena lineare. Un walker che registra B1 come dipendente da A1:A2 rende A2 un precedente di B1, A2 elenca già B1 tra i suoi precedenti, e la coda di Kahn che guida il ricalcolo incrementale in HotXLS non vede mai nessuno dei due nodi raggiungere in-degree zero. È il pattern di cui sono fatti i template di prestito: ogni riga di periodo referenzia colonne con nome per il saldo, il tasso e il conteggio delle rate, ogni nome copre l'intero piano di ammortamento, e ogni riga scrive anche in quelle colonne. Espandi i nomi e il grafo è un unico componente fortemente connesso. Valutali con l'intersezione implicita e il grafo diventa un insieme di catene corte, una per riga, che è quanto ECMA-376 Part 1 §18.17.2 descrive per un operando di riferimento consumato dove serve un valore singolo
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Posizione scalare: Vertical collassa ad A1 perché la formula è nella riga 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Un nome la cui definizione è un altro nome interseca comunque, quindi questo è A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argomento di classe reference: viene sommata tutta l'area, nessuna intersezione
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // La riga 6 è fuori da A1:A2, l'intersezione è vuota e IFERROR la intercetta
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Espandere Vertical ad A1:A2 qui trasformerebbe B1 -> A2 -> B1 in un ciclo falso
    end;
  finally
    Book.Free;
  end;
end;
Come fa HotXLS a stabilire che un argomento è scalare?
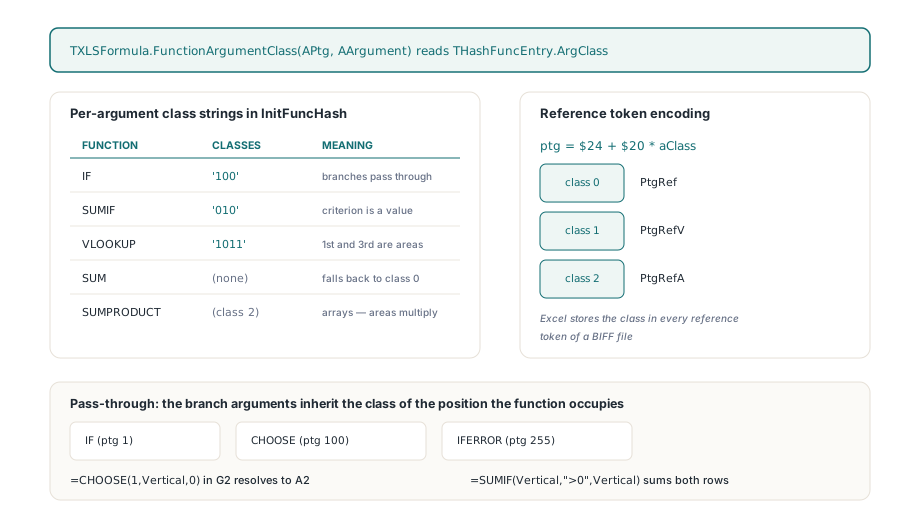
HotXLS legge la risposta dalla tabella delle funzioni invece che dalla forma dell'argomento. Ogni voce di TXLSFormula.InitFuncHash è registrata tramite THashFunc.SetValue con una stringa opzionale di classi per argomento: 'IF' porta '100', 'SUMIF' porta '010', 'VLOOKUP' porta '1011', e 'SUM' non ne porta nessuna, quindi tutti i suoi argomenti ricadono sulla classe 0 a livello di funzione. TXLSFormula.FunctionArgumentClass(APtg, AArgument) espone quel byte tramite THashFuncEntry.ArgClass, e un risultato di 1 significa classe value. Sono le stesse tre classi che [MS-XLS] §2.2.2 assegna ai token operando, e anche l'encoder vi si appoggia: quando scrive un riferimento calcola il ptg come $24 + $20 * aClass, che produce PtgRef per la classe 0, PtgRefV per la classe 1 e PtgRefA per la classe 2. Un file BIFF scritto da Excel memorizza quella classe in ogni token di riferimento, quindi un motore la cui tabella corrisponde alla specifica può rispondere alla domanda "questo argomento è scalare" senza guardare i dati. L'argomento centrale di SUMIF è il criterio, un valore; il primo e il terzo sono aree, riferimenti. SUMPRODUCT è registrata con classe 2 a livello di funzione, array, ed è per questo che =SUMPRODUCT(Vertical,Vertical) moltiplica ancora l'intera area
Tre funzioni non consultano la propria voce di tabella per nulla oltre al primo argomento. IF (ptg 1), CHOOSE (ptg 100) e IFERROR (ptg 255) lasciano passare ciò che selezionano, quindi i loro argomenti di ramo ereditano la classe della posizione che la funzione stessa occupa. È quella singola regola a permettere che =CHOOSE(1,Vertical,0) in G2 si risolva in A2 mentre =SUMIF(Vertical,">0",Vertical) accanto somma ancora entrambe le righe, ed è la regola che un piano di ammortamento esercita di più, perché le sue celle di periodo si appoggiano a IF per verificare se il prestito è ancora aperto
Portare la classe attraverso il walk delle dipendenze
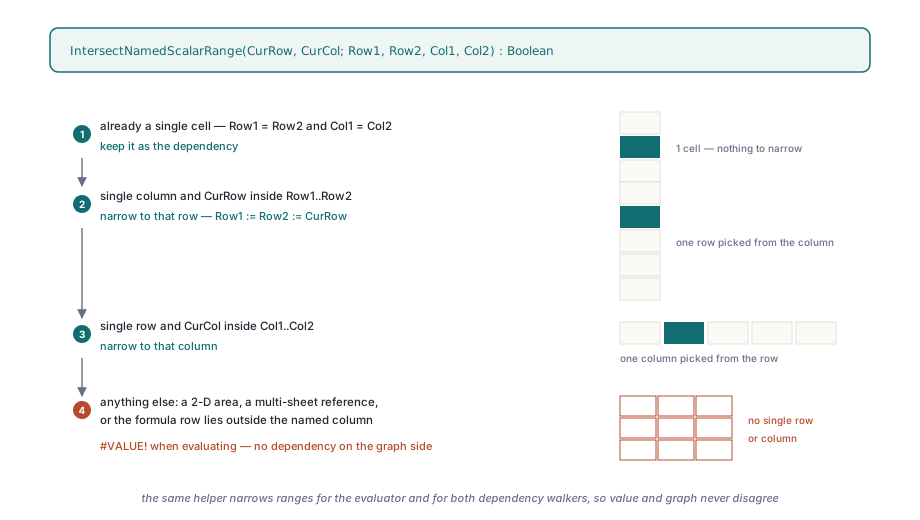
L'estrattore di dipendenze in lxCalc.pas è un Walk ricorsivo sull'albero sintattico compilato, ed esiste due volte, una in TXLSCalculator.ExtractDependencies per il grafo a livello di cartella di lavoro e una in ExtractWorkspaceDependencies per il grafo tra cartelle di lavoro. Entrambi i walker portano due parametri in più. AScalar parte come True alla radice di una formula, viene ricalcolato per ogni figlio funzione a partire da FunctionArgumentClass, e viene passato invariato per gli argomenti di ramo dei ptg 1, 100 e 255. ANameRoot diventa True solo quando il walker scende nella definizione compilata di un nome, e sopravvive solo attraverso i nodi SA_GROUP, le parentesi, così un nome definito come =A1:A2+1 non viene scambiato per un'area semplice. Quando entrambi i flag sono True su un nodo SA_RANGE, AddResolvedRange restringe l'area con lo stesso helper che usa il valutatore prima di registrare la dipendenza. L'helper è abbastanza corto da citarlo per intero
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // già una cella
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // colonna singola: prendi questa riga
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // riga singola: prendi questa colonna
    Result := True;
  end;
end;
Tutto ciò che l'helper rifiuta, un'area bidimensionale, un riferimento multi-foglio o una formula la cui riga cade fuori dalla colonna con nome, produce #VALUE! sul versante della valutazione e nessuna dipendenza sul versante del grafo, che è ciò che Excel fa per un'intersezione vuota. Il versante della valutazione vive in TXLSCalculator.GetValueItemName: rimuove gli involucri SA_GROUP dalla definizione compilata e, se la radice è un SA_RANGE, chiama GetRangeInfo, interseca e recupera l'unica cella tramite FGetValue invece di valutare l'intera definizione. I riferimenti esterni prendono il percorso regolare, perché non c'è una riga locale con cui intersecare. Da dove arrivino memorizzazione e scope di un nome lo racconta l'articolo sui nomi definiti e le formule tra fogli; qui interessa solo cosa fa il motore una volta che il nome si risolve
Perché MATCH deve aspettare una colonna calcolata a metà?
Perché l'argomento lookup-array di MATCH è un riferimento di scansione, e i riferimenti di scansione sono tenuti deliberatamente fuori dall'ordine di valutazione rigido. L'articolo sugli scan nelle ricerche introduce TXLSDepRange.LookupScan e spiega cosa si rinuncia escludendo gli archi di scansione dall'ordinamento: una formula di ricerca può girare prima che ogni cella del suo intervallo sia stata ricalcolata e leggere valori stantii. In una sessione interattiva la cosa converge al passaggio successivo. In un ricalcolo batch unico di un template le cui cache sono stantie no: PaymentCount, definito come =MATCH(0.01,Balances,-1)+1, leggerebbe i valori stantii ancora seduti nella colonna del saldo e restituirebbe un numero di rate che non potrebbe essere giusto
TXLSDepGraph.TopoOrder tratta quindi gli archi di scansione come archi di ordinamento soft. Accanto all'in-degree rigido mantiene un array ScanInDeg, che conta i precedenti di scansione sporchi per nodo e lo decrementa man mano che quei precedenti vengono emessi, usando le liste ScanPrecedents, ScanDependents e ScanPrecedentCount che il grafo conserva già. A ogni iterazione la coda di Kahn scorre la sua finestra di nodi pronti in cerca del primo nodo il cui ScanInDeg è zero e lo scambia in testa; se ogni nodo pronto sta ancora aspettando un precedente di scansione, la testa viene estratta nel suo ordine stabile. Gli archi di scansione non entrano mai nell'in-degree rigido, quindi un VLOOKUP autoreferenziale sulla propria colonna resta legale, ma una ricerca che può aspettare un precedente completabile lo fa. Con tre celle del saldo che tengono valori stantii, PaymentCount torna come 3; porta l'input a zero e =IFERROR(PaymentCount,99) vede il #N/A e restituisce 99
Perché l'aritmetica annidata viene forzata a Double
Perché l'aritmetica Variant di Delphi nasconde una trappola che si mostra solo nelle posizioni annidate. Copiare un + o un - di primo livello in due variabili locali Double tiene =B1-A1 esatta. Dentro =IF(TRUE,B1-A1,0), l'implementazione ovvia fa girare la stessa sottrazione come Value := Value - SubValue su due Variant, e quando un operando è un valore di cella Int64 e l'altro un Double, il risultato che abbiamo osservato era un Currency, un tipo a virgola fissa con quattro decimali, quindi 1066.1854641400994 meno 120 torna troncato a quattro decimali. Su un piano dove ogni rata è composta dalla riga precedente, quell'errore attraversa centinaia di periodi prima di arrivare ai totali, ed è per questo che TXLSCalculator.GetValueItem converte entrambi gli operandi prima che l'operatore giri
// TXLSCalculator.GetValueItem, ramo dell'aritmetica binaria (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// L'aritmetica Variant mista Int64/Double può promuovere a Currency.
// L'aritmetica di un foglio di calcolo deve mantenere la precisione in virgola mobile.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
La guardia gira prima di SA_ADD, SA_SUB, SA_MUL e SA_DIV allo stesso modo, quindi con Int64(120) in A1 e 1066.1854641400994 in B1 la differenza, la somma, il prodotto e il quoziente annidati conservano tutti la precisione double. HotXLS non pretende di conoscere ogni regola di promozione che la RTL applica ai tipi Variant misti attraverso le versioni del compilatore; tratta l'aritmetica dei fogli di calcolo come double IEEE e rende double entrambi gli operandi prima che l'operatore li veda, il che elimina la domanda
Cosa garantisce il motore per le colonne con nome
Con i tre meccanismi a posto, entrambe le architetture del motore ricalcolano il template di ammortamento da cache stantie fino a lxOk, e tutti i 4805 valori corrispondono a un'attesa indipendente riga per riga entro 1E-7. Non viene abilitata nessuna iterazione e nessun codice di errore viene soppresso per arrivarci. Un ciclo genuino attraverso un nome, =B1 in A1 con B1 che legge ancora Vertical, restituisce comunque un errore, esattamente come deve
Le regole seguono Excel. L'intersezione implicita si applica a un nome la cui definizione compilata, dopo aver tolto le parentesi, è un'area su una singola colonna o una singola riga di un unico foglio; un nome bidimensionale in posizione scalare dà #VALUE!, come in Excel, e una funzione che la tabella non conosce riceve la classe 0 da FunctionArgumentClass, quindi i suoi argomenti con nome vengono espansi per intero. L'ordinamento soft è una preferenza, non una garanzia: un ciclo fatto solo di scansioni viene valutato in ordine stabile e legge ciò che è in cache, che è il compromesso che l'articolo sugli scan nelle ricerche accetta di proposito. HotXLS è un componente nativo per fogli di calcolo per Delphi e C++Builder che legge, ricalcola e scrive XLS, XLSX, ODS e CSV senza Excel installato; l'intersezione dei nomi, la tabella delle classi di argomento e l'ordinamento soft degli scan valgono per ogni formato perché il motore di calcolo è condiviso, e l'attuale copertura delle funzioni è elencata nella pagina prodotto del componente foglio di calcolo HotXLS per Delphi