Il frammento di content stream [(Reference)-333(Manual)] TJ dipinge due parole con un netto spazio in mezzo, eppure non contiene nessun carattere spazio. Lo spazio è movimento di penna: ISO 32000-1 §9.4.3 dice al reader di spostare il prossimo glyph a destra di 333 millesimi della dimensione del font prima di disegnare Manual. Un estrattore che copia caratteri e ignora la geometria restituisce ReferenceManual, e un indice di ricerca alimentato da lui non troverà mai la frase "Reference Manual". L'output di TeX, molti file Distiller e la maggior parte dei layout giustificati separano le parole così
Gli a capo vanno male dall'altro lato. Un apice alzato spezza la sua riga in due, una filigrana diagonale DRAFT arriva un carattere per riga, e una prova ritagliata si apre con la slug line della stampante che nessun viewer mostra mai. Nessuno di questi file è rotto. Ognuno usa un modo legale di posizionare il testo che un estrattore che copia caratteri fraintende
Spazi tra parole ricostruiti dalla geometria dei glyph
THotPDF.ExtractLoadedPageText in HotPDF Delphi Component decide le battute di parola dalle posizioni dei glyph, e un carattere spazio nello stream è solo uno dei segnali che legge. Lungo la direzione di scrittura del glyph precedente misura la distanza dalla fine della larghezza propria di quel glyph all'origine del glyph corrente, e inserisce uno spazio quando la distanza supera 0.15 dell'altezza del box del glyph corrente, misurata da ascent a descent nello spazio utente. Per il frammento TJ di sopra, un terzo di em sta comodamente oltre quella linea per qualunque faccia di testo ordinaria, quindi il testo di pagina recita Reference Manual
Due condizioni trattengono lo spazio. Nulla viene aggiunto quando il testo fin lì termina già con un blank o il prossimo glyph è un blank (spazio, tab, no-break space, spazio ideografico), così i producer che mostrano gli spazi non si vedono mai raddoppiare. Nulla viene aggiunto nemmeno tra due caratteri CJK. Ideogrammi, kana, hangul e forme full-width contano tutti, perché la giustificazione stira una riga cinese o giapponese senza che quella stirata significhi un confine di parola. Separatamente da entrambe, un box glyph con altezza zero ripiega sulla dimensione Tf come propria altezza. Ogni numero che la regola usa è memorizzato sui record dei glyph, così un file il cui spacing sembra sbagliato può essere rigiocato glyph per glyph
uses
  SysUtils, HPDFDoc, HPDFContentStream;

// Stampa i gap che ExtractLoadedPageText trasformerebbe in spazi.
// Solo testo orizzontale; ExtractLoadedPageGlyphs restituisce lo stream di
// contenuto della pagina senza il testo dei Form XObject e senza il filtro crop
procedure DumpWordGaps(Pdf: THotPDF; PageIndex: Integer);
var
  Glyphs: THPDFGlyphArray;
  I: Integer;
  Height, Gap: Double;
begin
  if not Pdf.ExtractLoadedPageGlyphs(PageIndex, Glyphs) then
    Exit;
  for I := 1 to High(Glyphs) do
  begin
    if Glyphs[I].Vertical or Glyphs[I - 1].Vertical then
      Continue;
    // altezza ascent-to-descent del box glyph, nello spazio utente
    Height := Sqrt(Sqr(Glyphs[I].QuadX[3] - Glyphs[I].QuadX[0]) +
      Sqr(Glyphs[I].QuadY[3] - Glyphs[I].QuadY[0]));
    if Height <= 0 then
      Height := Abs(Glyphs[I].FontSize);
    // gap dalla fine della larghezza propria del glyph precedente
    Gap := Glyphs[I].BaselineStartX - Glyphs[I - 1].GlyphEndX;
    if (Height > 0) and (Gap > 0.15 * Height) then
      Writeln(Format('U+%.4x gap %.2f height %.2f: space',
        [Glyphs[I].Unicode, Gap, Height]));
  end;
end;
Perché misurare dalla larghezza propria del glyph invece che dalla posizione della penna?
Perché la posizione della penna dopo un glyph contiene già spacing che non c'entra nulla con le battute di parola. ISO 32000-1 §9.4.4 definisce lo spostamento orizzontale come larghezza del glyph per dimensione del font, più character spacing Tc, più word spacing Tw, il tutto scalato per lo scaling orizzontale Tz. Ogni record di glyph porta entrambe le estremità: BaselineEndX / BaselineEndY tengono quello spostamento completo, mentre GlyphEndX / GlyphEndY tengono solo l'avanzamento del font alla dimensione corrente e Tz. I due divergono sui file che stringono il tracking con un Tc negativo e restituiscono lo spazio con una correzione TJ dopo ogni glyph. Misurato dalla penna, ogni restituzione sembra un gap, e un termine cinese come "95后" esce come "9 5 后". Misurato dalla larghezza propria del glyph, la correzione restituisce solo ciò che Tc aveva tolto, e il termine resta intatto
La soglia è legata all'altezza del box glyph invece che alla dimensione Tf per un motivo affine. Gli export di Word spesso scrivono 1 Tf e portano la dimensione reale in una Tm scalata, così l'operando della dimensione font recita 1 mentre il testo è alto 10 punti. Una regola agganciata a quell'operatore metterebbe la soglia a 0.15 punto su una pagina del genere, e le normali coppie di kerning inizierebbero a leggersi come battute di parola. L'altezza del box viene misurata dopo che ogni matrice è stata applicata, così 1 Tf con matrice scalata e un semplice 10 Tf producono lo stesso testo
Due casi limite seguono dritti dalla geometria. Un titolo composto con una spaziatura tra lettere molto larga, dove il solo Tc apre tra le lettere più di 0.15 dell'altezza del testo, viene estratto come S P A C E D. È ciò che mostra la pagina, e preferiamo restituirlo piuttosto che aggiungere un'euristica che indovini quali gap larghi sono tracking e quali sono parole; un'euristica del genere inizia a inghiottire vere battute di parola nelle colonne strettamente giustificate, che è un fallimento peggiore per la ricerca. I pezzi disegnati fuori ordine su una stessa baseline producono un gap negativo e si uniscono senza spazio. Nel corpo del testo corrente quel caso è raro
Quando inizia una nuova riga nel testo estratto?
ExtractLoadedPageText inizia una nuova riga quando lo spostamento dall'origine del glyph precedente a quella corrente, proiettato sulla normale della direzione di scrittura precedente, supera metà dell'altezza di box più grande dei due glyph. Il movimento lungo la baseline non conta mai verso un a capo, per quanto salti la penna
Una regola che confronta lo spostamento Y grezzo con metà della dimensione Tf fallisce in due direzioni. Con 1 Tf e una Tm scalata la soglia si rimpicciolisce a mezza unità, così un apice alzato da un text rise di 0.4 spezza la riga. La spezza anche il piccolo jitter di baseline che certi motori di layout lasciano tra le sequenze. La stessa regola ignora del tutto la X. Il testo sotto una Tm ruotata, come quella filigrana diagonale, scende lungo la pagina a ogni glyph e esce un carattere per riga, mentre la proiezione tratta una sequenza a 45 gradi esattamente come una orizzontale
Prendere la più grande delle due altezze conta quando le dimensioni si mescolano su una riga. Una parola in evidenza da 36 punti seguita da una didascalia da 8 punti qualche punto più in basso viene giudicata contro metà dell'altezza del glyph grande, così la coppia resta insieme; giudicata contro il solo glyph piccolo, la didascalia atterrerebbe su una riga sua. Il text rise fa parte dell'origine del glyph, ed è per questo che la baseline alzata di un apice viene misurata contro quella stessa mezza altezza
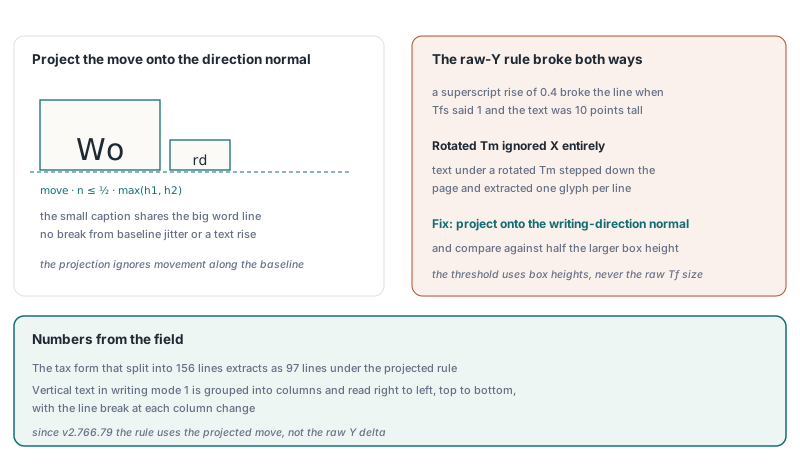
Il testo verticale in writing mode 1 (§9.7.4.3) prende una strada separata. Quei glyph vengono raggruppati in colonne sulla loro origine X, con metà della dimensione del font come tolleranza di colonna, poi letti da destra a sinistra e dall'alto in basso, con un a capo a ogni cambio di colonna. Una pagina che mescola un corpo giapponese verticale con una intestazione corrente orizzontale prende anche un a capo a ogni cambio tra le due direzioni
Quali glyph finiscono nel testo di pagina
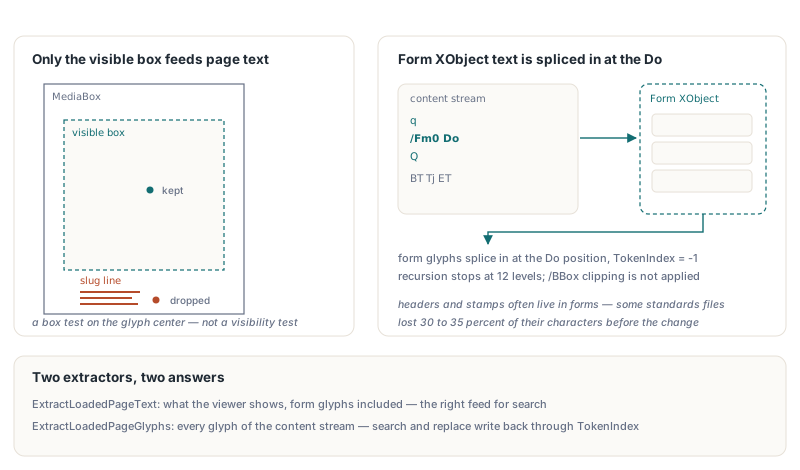
ExtractLoadedPageText restituisce il testo che un viewer mostra. Conserva solo i glyph il cui centro del box cade dentro GetLoadedPageVisibleBox, che è il CropBox ritagliato sul MediaBox (§14.11.2), così le slug line e gli altri marchi della stampante composti come testo fuori dall'area di taglio cadono fuori. ExtractLoadedPageGlyphs continua a restituire ogni glyph dello stream di contenuto della pagina, slug line compresa, per i lavori che ne hanno bisogno. Il filtro è un test geometrico su un punto per glyph. Il testo nascosto da un clipping path, dipinto in bianco o coperto da un'immagine esce comunque, perché decidere la visibilità reale vorrebbe dire renderizzare la pagina
uses
  SysUtils, HPDFDoc, HPDFContentStream;

var
  Pdf: THotPDF;
  Raw, Merged: THPDFGlyphArray;
  PageText: UnicodeString;
  L, B, R, T: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('trimmed-proof.pdf');
    if Pdf.GetLoadedPageVisibleBox(0, L, B, R, T) then
      Writeln(Format('Visible box: %.1f %.1f %.1f %.1f', [L, B, R, T]));
    // ogni glyph dello stream di contenuto della pagina, slug line compresa
    if Pdf.ExtractLoadedPageGlyphs(0, Raw) then
      Writeln(Length(Raw), ' glyphs in the page content stream');
    // stream di pagina più testo dei Form XObject, in ordine di disegno, prima del crop
    if Pdf.ExtractLoadedPageGlyphsWithForms(0, Merged) then
      Writeln(Length(Merged), ' glyphs including forms');
    // ciò che la pagina mostra: form innestate, glyph fuori crop scartati
    if Pdf.ExtractLoadedPageText(0, PageText) then
      Writeln(PageText);
    // le stesse regole di spacing applicate allo stream non filtrato, per un diff
    Writeln(HPDFAssemblePageText(Raw));
  finally
    Pdf.Free;
  end;
end.
Il testo dipinto attraverso Form XObjects fa parte del testo di pagina. Intestazioni, timbri e filigrane vivono molto spesso dentro form, e un estrattore che legge solo lo stream di contenuto della pagina non li vede mai. HotPDF registra ogni Do insieme alla CTM in vigore, interpreta la form alla sua /Matrix per quella CTM (§8.10.1), e innesta i glyph della form alla posizione del Do, ricorsendo nelle form annidate. Una form senza /Resources propria prende in prestito quelle dello stream che la dipinge, l'assetto più vecchio che §7.8.3 descrive. I glyph il cui centro cade fuori dal /BBox della form vengono lasciati fuori, dato che quel box ritaglia la form quando viene dipinta. Una form che dipinge se stessa, direttamente o attraverso un'altra form, non viene rientrata una seconda volta, e l'annidamento si ferma a 12 livelli
I glyph delle form portano TokenIndex = -1 e ItemIndex = -1. Lo stesso motivo tiene ExtractLoadedPageGlyphs limitata ai glyph dello stream di pagina: ricerca, sostituzione e redazione riscrivono i loro cambiamenti attraverso TokenIndex, e un glyph di form in quell'array li punterebbe su byte di uno stream diverso. Quando serve la lista fusa a livello glyph, ExtractLoadedPageGlyphsWithForms la restituisce in ordine di disegno, prima che giri il filtro del box visibile
Un altro passaggio gira prima delle regole di spacing. Loghi sovrastampati e bold finto ottenuto dipingendo lo stesso testo due volte con un piccolo offset verrebbero altrimenti estratti con ogni lettera doppia. Quando un glyph dipinge lo stesso carattere alla stessa dimensione entro un decimo di quella dimensione lungo la baseline, e un quinto attraverso di lei, di un glyph precedente, ne resta una sola copia; gli spazi non vengono mai tolti così. L'articolo sul bold finto e i glyph duplicati nell'estrazione del testo percorre quel caso
Lo stato del testo attraverso q e Q
Il testo dopo un Q si decodifica male in qualunque estrattore che salvi solo la CTM su q. I parametri di stato del testo, cioè font, dimensione, Tc, Tw, Tz, TL, rendering mode e rise, appartengono allo stato grafico (§9.3.1), quindi Q deve ripristinarli insieme a tutto il resto dello stack (§8.4.2). Un pattern espone l'errore in fretta: un font Identity-H a due byte viene selezionato dentro q … Q per una singola cella di tabella, e il testo dopo il Q mostra stringhe WinAnsi a un byte senza un Tf proprio. Un interprete che conserva il font interno legge quei byte a coppie, e i puntini di indirizzo di un indice si trasformano in una stringa di caratteri CJK senza senso. L'interprete di HotPDF mette in push tutti e otto i valori di stato del testo insieme alla CTM a ogni q e li toglie a ogni Q
Tutto quanto sopra vale su ogni pagina, quindi un intero documento può finire in un file UTF-8 con una sola chiamata. ExtractLoadedPagesTextToStream prende un intervallo di pagine 1-based (una stringa vuota significa tutte le pagine), un separatore scritto tra le pagine, e un flag per il byte order mark, e restituisce il numero di pagine estratte. L'output viene appeso alla posizione corrente dello stream, quindi in memoria non viene tenuto nulla di più grande del testo di una pagina
uses
  SysUtils, Classes, HPDFDoc;

var
  Pdf: THotPDF;
  Output: TFileStream;
  Pages: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('report.pdf');
    Output := TFileStream.Create('report.txt', fmCreate);
    try
      // intervallo vuoto = tutte le pagine; form feed tra le pagine; BOM UTF-8
      Pages := Pdf.ExtractLoadedPagesTextToStream(Output, '', #12, True);
      Writeln(Pages, ' pages extracted');
    finally
      Output.Free;
    end;
  finally
    Pdf.Free;
  end;
end.
Scegliere l'API di testo per il lavoro
Per ricerca e indicizzazione, ExtractLoadedPageText è l'alimentazione giusta: segue l'ordine del content stream e riflette ciò che la pagina mostra. La catena di decodifica sotto di lei, dalle mappe /ToUnicode ai font CID, è trattata in estrarre testo dai PDF caricati con HotPDF. L'ordine del content stream è più debole sui documenti con tag il cui producer ha scritto l'intestazione corrente per ultima o ha intrecciato due colonne; per quelli, l'estrazione del testo in ordine di struttura percorre l'albero di struttura in ordine di authoring invece di dedurlo dalla geometria. I dati chiusi nelle tabelle stanno meglio con l'estrazione di tabelle tipizzate oltre i salti di pagina, che restituisce celle con i loro valori. Il codice che modifica la pagina sta su ExtractLoadedPageGlyphs, i cui indici di token puntano ai byte che riscriverà
I campi dei record di glyph usati in questi esempi, insieme al resto dell'API di estrazione testo e a una build di prova, sono documentati sulla pagina del prodotto HotPDF Delphi PDF Component