I livelli di testo OCR, i limiti dei barcode e le box di oscuramento dei volti sbandano sulle pagine PDF ritagliate quando i pixel bitmap vengono rimappati attraverso il MediaBox invece che attraverso la box che il renderer ha davvero rasterizzato: il CropBox ritagliato sul MediaBox (ISO 32000-1 §14.11.2). HotPDF mappa i risultati di ApplyLoadedOCRTextLayer, DecodeLoadedPageBarcodes e DetectLoadedRedactionFindings attraverso quella box visibile, e qualsiasi motore o detector personalizzato che scrivi deve fare lo stesso
Il sintomo è facile da riconoscere una volta che l'hai visto. Un archivio di contratti scansionati passa per l'OCR, l'output è ricercabile, e il risultato di ricerca di un numero di clausola viene evidenziato mezzo pollice più in basso e a sinistra del numero stampato. La maggior parte dei file nel lotto sta bene. Quelli spostati vengono tutti da una stazione di scansione che scrive una /CropBox per rifilare il margine del vetro. Quello singolo dettaglio separa l'immagine che il motore OCR ha visto dalla cornice in cui il livello di testo è stato collocato, e lo stesso disallineamento sposta i limiti dei barcode e, più seriamente, le box di oscuramento dei volti
Perché il livello di testo OCR si allontana dalle parole scansionate?
Il livello di testo sbanda quando due metà della pipeline sono in disaccordo su quale rettangolo copre la bitmap. Il rendering di HotPDF, l'export SVG, il viewer e la stampa onorano tutti il CropBox: una pagina viene mostrata attraverso il proprio CropBox ritagliato sul MediaBox, che è ciò che prescrive ISO 32000-1 §14.11.2, e GetLoadedPageVisibleBox restituisce quella box visibile. Una trasformazione da dispositivo a pagina costruita da GetLoadedPageBox(PageIndex, pbMediaBox, ...) presume invece che il raster copra il MediaBox, così il raster e la trasformazione descrivono rettangoli diversi e ogni posizione riconosciuta torna spostata del varco tra le due
Fare le cose per bene significa tenere d'accordo tre cose per ogni funzionalità di riconoscimento: la trasformazione, la stima del budget di pixel, e la page box consegnata a un motore personalizzato nel record della richiesta. HotPDF deriva tutte e tre dalla box visibile, il che significa anche che il riconoscimento vede solo contenuto che i viewer mostrano davvero
Alcuni casi sono immuni al disallineamento:
- Pagine senza una
/CropBox, o il cui CropBox eguaglia il MediaBox, si mappano identiche attraverso l'una o l'altra box DecodeLoadedPageBarcodesconHasRegionimpostato renderizza esattamente la regione che passi e mappa attraverso quella stessa regione; il controllo che la regione giaccia dentro la pagina usa il MediaBox- I risultati di oscuramento basati su pattern (email, numeri di carta e così via) vengono dall'estrazione di testo in user space, non da un raster, quindi solo i risultati della rilevazione dei volti dipendono dalla mappatura del raster
Tre sistemi di coordinate, e quali API HotPDF usano ciascuno
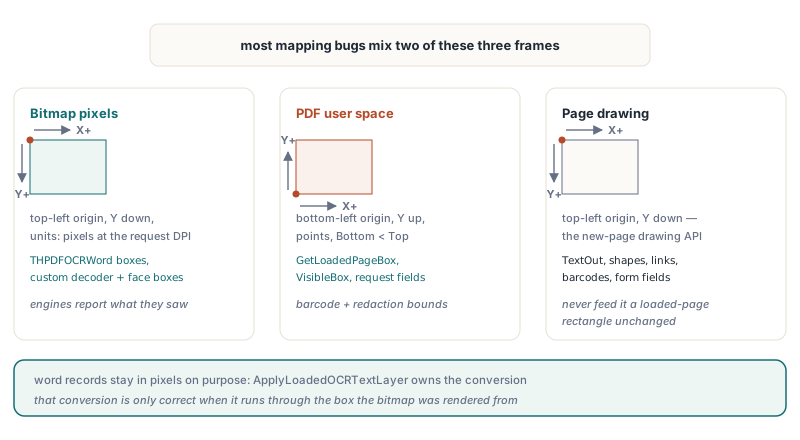
Il codice che tocca il riconoscimento di HotPDF ha a che fare con tre sistemi, e la maggior parte degli errori di mappatura viene dal mescolarne due
- Pixel bitmap: origine in alto a sinistra, Y cresce verso il basso, le unità sono pixel al DPI richiesto.
THPDFOCRWord.Left,Top,RighteBottomstanno in questo sistema, così come i punti di baseline opzionali, i risultati che unIHPDFBarcodeDecoderpersonalizzato restituisce, e le box di unIHPDFFaceDetectorpersonalizzato - User space PDF di una pagina caricata: origine in basso a sinistra, Y cresce verso l'alto, le unità sono punti, con
Bottom < Top.GetLoadedPageBoxeGetLoadedPageVisibleBoxrestituiscono Left, Bottom, Right, Top in questo sistema, così come i campiPageLeft,PageBottom,PageRightePageTopdiTHPDFOCRRequest, i limiti inTHPDFDecodedBarcodee i rettangoli inTHPDFRedactionFinding - Coordinate di disegno pagina HotPDF: l'API che usi per costruire nuove pagine (output di testo, forme, barcode, link, campi modulo) lavora con origine in alto a sinistra e Y che cresce verso il basso. Quel sistema appartiene alla generazione di documenti e non c'entra nulla con le API dei documenti caricati qui sopra, quindi non dare mai in pasto un rettangolo in user space di pagina caricata invariato
Il record di parola OCR è volutamente basato sui pixel: un motore riporta ciò che ha visto nell'immagine, e ApplyLoadedOCRTextLayer si occupa della conversione. Quella divisione funziona solo quando la conversione usa la box giusta, ed è per questo che HotPDF la costruisce dalla box visibile
La trasformazione da dispositivo a pagina dietro OCR, barcode e volti
HotPDF mappa i pixel bitmap sulla pagina con un'unica matrice affine costruita da cinque ingressi: la rotazione, la scala DPI / 72, l'altezza della bitmap, e Left, Bottom, Right e Top della box renderizzata. OCR, decodifica dei barcode e rilevazione dei volti condividono un'unica routine per questo, così l'input di box decide l'accuratezza di tutti e tre in una volta. Per una pagina non ruotata la matrice pagina-a-dispositivo [A B C D E F] è:
A = ScaleeD = -Scale, doveScale = DPI / 72; laDnegativa capovolge lo user space (Y in su) nello spazio bitmap (Y in giù)B = C = 0, perché una pagina non ruotata non ha taglio né scambio tra gli assiE = -Left * Scale, che porta il bordo sinistro della box alla colonna di pixel 0F = BitmapHeight + Bottom * Scale, che mappa il bordo inferiore della box a y = BitmapHeight, il bordo inferiore della bitmap, così il bordo superiore atterra sulla riga 0
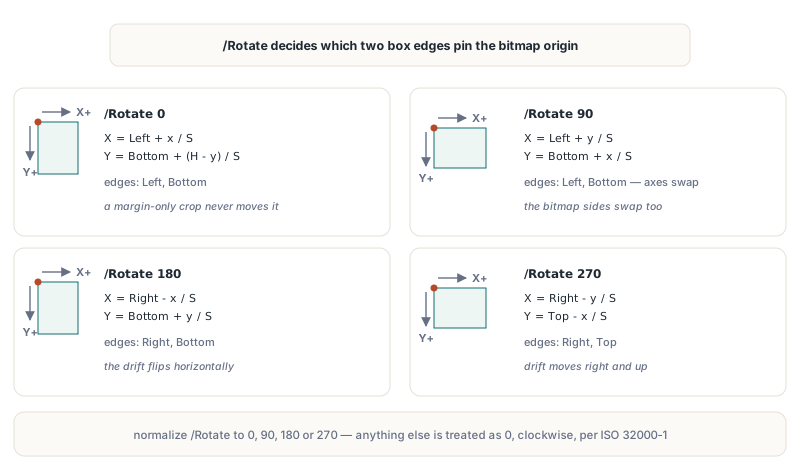
I pixel tornano sulla pagina attraverso l'inverso di quella matrice. Request.PageRotation porta la /Rotate della pagina normalizzata a 0, 90, 180 o 270 (qualsiasi valore che non sia multiplo di 90 viene trattato come 0), e il renderer ruota la pagina in senso orario come richiede ISO 32000-1 §7.7.3.3. Sotto rotazione gli assi si scambiano e una diversa coppia di bordi della box è fissata all'origine della bitmap. Scritte come formule inverse, con S = DPI / 72, x e y in pixel e H l'altezza della bitmap:
| /Rotate | X pagina | Y pagina | Bordi della box da cui dipende la mappatura |
|---|---|---|---|
| 0 | Left + x / S | Bottom + (H - y) / S | Left, Bottom |
| 90 | Left + y / S | Bottom + x / S | Left, Bottom |
| 180 | Right - x / S | Bottom + y / S | Right, Bottom |
| 270 | Right - y / S | Top - x / S | Right, Top |
L'ultima colonna spiega perché una mappatura basata sul MediaBox sembra casuale in produzione. Un CropBox che rifila solo la parte alta della pagina lascia Left e Bottom intatti, così le pagine dritte escono perfette e solo le pagine con /Rotate 270 sbandano. La rotazione scambia anche le dimensioni della bitmap: a 90 e 270 la bitmap è larga (Top - Bottom) * S pixel e alta (Right - Left) * S pixel
Che cosa va storto con MediaBox [0 0 612 792] e CropBox [36 36 576 756]?
Con un ritaglio di mezzo pollice su ogni lato, il livello di testo di una pagina non ruotata atterra esattamente 36 punti a sinistra e 36 punti sotto le parole scansionate quando si usa il MediaBox. Prendi una pagina US Letter il cui CropBox rifila 36 punti (0,5 pollici) da ogni bordo. La box visibile è 540 per 720 punti, così alla risoluzione OCR di default di 300 DPI la scala è 300 / 72 ≈ 4,1667 e la bitmap è 2250 per 3000 pixel
Supponi che il motore riporti una parola con box in pixel Left 450, Top 600, Right 900, Bottom 660 e nessuna baseline. HotPDF colloca allora la baseline al 20 percento dell'altezza della parola sopra il bordo inferiore, alla riga di pixel 648, e mappa il punto di partenza (450, 648):
- Attraverso la box visibile: x = 36 + 450 / 4.1667 = 144.0 e y = 36 + (3000 - 648) / 4.1667 = 600.48, che è dove la parola è stampata
- Attraverso il MediaBox: x = 0 + 108.0 = 108.0 e y = 0 + 564.48 = 564.48, uno scostamento uniforme di (-36, -36) punti
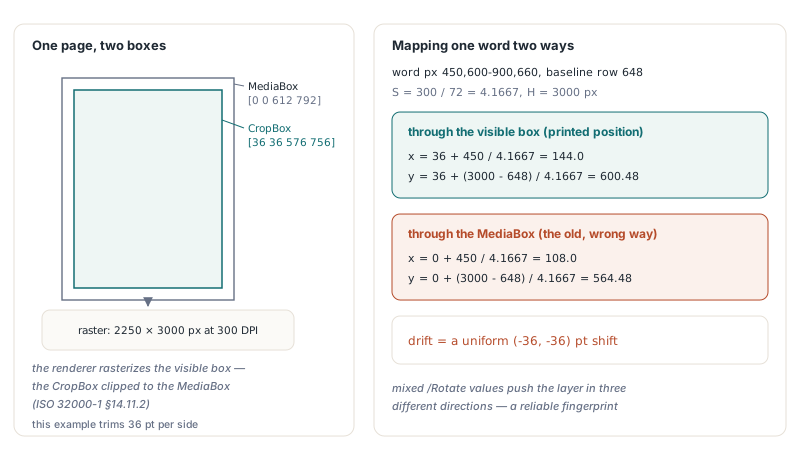
Ruota la stessa pagina e la direzione dell'errore cambia, perché sono coinvolti bordi diversi. A /Rotate 180 il termine X usa Right, e 612 invece di 576 spinge il livello 36 punti a destra mentre Bottom lo tira ancora 36 punti in giù. A /Rotate 270 sia Right sia Top sono troppo grandi, quindi il livello si muove 36 punti a destra e 36 punti in su. Un documento con orientamenti misti può mostrare la deriva in tre direzioni, un'impronta affidabile per questo errore. Il codice scritto a mano che ricava la scala dalla box, come Bitmap.Width / (Right - Left), stira inoltre ogni coordinata di 612 / 540, circa il 13 percento, sopra lo scostamento
Quali delle tue pagine PDF richiedono una mappatura consapevole del CropBox?
Un documento PDF richiede attenzione quando almeno una pagina ha una box visibile che differisce dal proprio MediaBox, e HotPDF può dirtelo in poche righe. Confronta GetLoadedPageBox con pbMediaBox contro GetLoadedPageVisibleBox per ogni pagina, e stampa GetLoadedPageRotation accanto così puoi prevedere la direzione della deriva dalla tabella qui sopra. THPDFPageBoundary offre anche pbCropBox, pbBleedBox, pbTrimBox e pbArtBox, ma GetLoadedPageBox(pbCropBox) ripiega sul MediaBox quando non esiste alcun crop box e non ritaglia, quindi la box visibile è la cosa giusta con cui confrontarsi
uses
  System.SysUtils, HPDFDoc;

procedure ReportCroppedPages(const FileName: string);
var
  Pdf: THotPDF;
  I: Integer;
  ML, MB, MR, MT, VL, VB, VR, VT, Tmp: Single;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile(FileName) < 1 then
      raise Exception.Create('Cannot load ' + FileName);
    for I := 0 to Pdf.LoadedPageCount - 1 do
    begin
      if not Pdf.GetLoadedPageBox(I, pbMediaBox, ML, MB, MR, MT) then
        Continue;
      // l'array conservato può elencare i propri angoli in qualsiasi ordine
      if MR < ML then begin Tmp := ML; ML := MR; MR := Tmp; end;
      if MT < MB then begin Tmp := MB; MB := MT; MT := Tmp; end;
      // già normalizzata e ritagliata sul MediaBox
      if not Pdf.GetLoadedPageVisibleBox(I, VL, VB, VR, VT) then
        Continue;
      if (Abs(VL - ML) > 0.01) or (Abs(VB - MB) > 0.01) or
         (Abs(VR - MR) > 0.01) or (Abs(VT - MT) > 0.01) then
        Writeln(Format('Page %d  MediaBox [%g %g %g %g]  visible [%g %g %g %g]  /Rotate %d',
          [I + 1, ML, MB, MR, MT, VL, VB, VR, VT,
           Pdf.GetLoadedPageRotation(I)]));
    end;
  finally
    Pdf.Free;
  end;
end;
Due dettagli di GetLoadedPageVisibleBox contano per script come questo. La funzione lascia intatti i propri parametri out quando fallisce, così preimpostare una dimensione pagina di default prima della chiamata è un pattern sicuro. E quando un CropBox malformato non interseca affatto il MediaBox, la funzione restituisce il MediaBox invece di un rettangolo vuoto. Se il rapporto elenca pagine che una pipeline precedente ha processato in OCR attraverso una mappatura basata sul MediaBox, ricorda che il livello di testo già commesso resta nel file salvato: l'opzione di default SkipPagesWithText salterà quelle pagine a un secondo passaggio se non la disattivi o non rimuovi prima il vecchio livello
Come deve mappare un IHPDFOCREngine personalizzato i pixel di nuovo in spazio PDF?
Un IHPDFOCREngine personalizzato dovrebbe restituire le box delle parole in pixel bitmap e lasciare fare a HotPDF la mappatura; converti in user space solo per le tue decisioni, e in tal caso usa la box della richiesta, mai il MediaBox. I PageLeft, PageBottom, PageRight e PageTop della richiesta descrivono la box visibile renderizzata, quindi corrispondono esattamente a Request.Bitmap. L'helper qui sotto è l'inverso della trasformazione della libreria, incluso il suo uso dell'altezza reale della bitmap per le pagine dritte, quindi concorda con HotPDF al pixel
uses
  System.SysUtils, System.Math, Vcl.Graphics, HPDFDoc;

// Pixel bitmap (origine in alto a sinistra, Y in giù) a spazio utente PDF
// (origine in basso a sinistra, Y in su), attraverso la box da cui la bitmap è stata renderizzata
procedure HotPixelToPage(Rotation, DPI, BitmapHeight: Integer;
  Left, Bottom, Right, Top: Single; X, Y: Double;
  out PageX, PageY: Double);
var
  S: Double;
begin
  S := DPI / 72.0;
  case Rotation of
    90:  begin PageX := Left + Y / S;  PageY := Bottom + X / S; end;
    180: begin PageX := Right - X / S; PageY := Bottom + Y / S; end;
    270: begin PageX := Right - Y / S; PageY := Top - X / S; end;
  else
    PageX := Left + X / S;
    PageY := Bottom + (BitmapHeight - Y) / S;
  end;
end;
Un motivo realistico per cui serve lo user space dentro un motore è una regola di zona: fatture il cui intestazione non vuoi mai ricercabile, o un'area di timbro che confonde il riconoscitore. Il motore qui sotto, scritto con TInterfacedObject così il reference counting gestisce la sua vita, filtra le parole per dove i loro centri cadono sulla pagina, poi restituisce i superstiti intatti in coordinate pixel. RunRecognizer sta al posto della tua chiamata di riconoscimento
type
  TZoneFilterOCREngine = class(TInterfacedObject, IHPDFOCREngine)
  private
    FSkipLeft, FSkipBottom, FSkipRight, FSkipTop: Single;  // spazio utente
    function RunRecognizer(Bitmap: TBitmap; MaxWords: Integer;
      out Words: THPDFOCRWords): boolean;  // il tuo recognizer, box in pixel
  public
    constructor Create(SkipLeft, SkipBottom, SkipRight, SkipTop: Single);
    function GetName: AnsiString;
    function Recognize(const Request: THPDFOCRRequest;
      out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
  end;

function TZoneFilterOCREngine.Recognize(const Request: THPDFOCRRequest;
  out Words: THPDFOCRWords; out Diagnostic: AnsiString): boolean;
var
  Raw: THPDFOCRWords;
  I, Count: Integer;
  CX, CY: Double;
begin
  Diagnostic := '';
  SetLength(Words, 0);
  if not RunRecognizer(Request.Bitmap, Request.MaxWords, Raw) then
  begin
    Diagnostic := 'recognizer failed';
    Exit(False);
  end;
  SetLength(Words, Length(Raw));
  Count := 0;
  for I := 0 to High(Raw) do
  begin
    HotPixelToPage(Request.PageRotation, Request.DPI,
      Request.Bitmap.Height, Request.PageLeft, Request.PageBottom,
      Request.PageRight, Request.PageTop,
      (Raw[I].Left + Raw[I].Right) / 2, (Raw[I].Top + Raw[I].Bottom) / 2,
      CX, CY);
    if (CX >= FSkipLeft) and (CX <= FSkipRight) and
       (CY >= FSkipBottom) and (CY <= FSkipTop) then
      Continue;
    Words[Count] := Raw[I];  // ancora pixel: HotPDF li mappa da solo
    Inc(Count);
  end;
  SetLength(Words, Count);
  Result := True;
end;
Consegna il motore a ApplyLoadedOCRTextLayer(PageIndices, Engine, Options, Info) come con qualsiasi altro motore. La libreria valida ciò che torna prima di fidarsi: una parola viene scartata e contata in Info.DroppedWordCount quando la sua box lascia la bitmap, quando Right <= Left o Bottom <= Top, o quando Confidence sta fuori da 0..1 o sotto MinimumConfidence. Restituire più parole di MaxWordsPerPage, o spingere il totale corrente oltre MaxTotalWords, fa fallire l'intera chiamata con un errore di budget, quindi onora Request.MaxWords nel motore. Non convertire le box delle parole in user space prima di restituirle; HotPDF tratterebbe i valori in punti come pixel e il livello collasserebbe verso l'origine della bitmap
Mappare l'output del tuo detector
Lo stesso helper serve una pipeline fatta in casa costruita su RenderLoadedPageToBitmap, che renderizza la box visibile e applica /Rotate proprio come fanno le funzionalità di riconoscimento. Leggi la box con GetLoadedPageVisibleBox, normalizza la rotazione allo stesso modo di HotPDF, e mappa due angoli opposti di ogni box in pixel. L'asse Y si capovolge e, a 90 e 270 gradi, gli assi si scambiano, così gli angoli mappati escono in nessun ordine fisso; prendi minimo e massimo dei punti mappati, che è anche il modo in cui HotPDF costruisce i limiti dei barcode
const
  DPI = 200;
var
  Pdf: THotPDF;
  Bmp: TBitmap;
  VL, VB, VR, VT: Single;
  Rotation: Integer;
  PxL, PxT, PxR, PxB, X1, Y1, X2, Y2: Double;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('scanned-ids.pdf');
    if not Pdf.GetLoadedPageVisibleBox(0, VL, VB, VR, VT) then Exit;
    Rotation := Pdf.GetLoadedPageRotation(0) mod 360;
    if Rotation < 0 then Inc(Rotation, 360);
    if (Rotation <> 90) and (Rotation <> 180) and (Rotation <> 270) then
      Rotation := 0;
    Bmp := Pdf.RenderLoadedPageToBitmap(0, DPI);
    if Bmp = nil then Exit;
    try
      MyDetector(Bmp, PxL, PxT, PxR, PxB);  // il tuo codice, box in pixel
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxL, PxT, X1, Y1);
      HotPixelToPage(Rotation, DPI, Bmp.Height, VL, VB, VR, VT,
        PxR, PxB, X2, Y2);
      Writeln(Format('User-space box [%.2f %.2f %.2f %.2f]',
        [Min(X1, X2), Min(Y1, Y2), Max(X1, X2), Max(Y1, Y2)]));
    finally
      Bmp.Free;
    end;
  finally
    Pdf.Free;
  end;
end;
Il comportamento di rotazione è coperto più a fondo in appiattire la rotazione di pagina senza rompere le page box, e la pipeline di decodifica dei barcode che consuma la stessa trasformazione in decodificare codici QR ruotati dalle pagine PDF. Se il tuo motore avvolge un riconoscitore esterno, l'adapter OCR Tesseract per PDF ricercabile mostra il lato isolamento di processo e cancellazione della stessa interfaccia
Riferimento rapido: mappatura coordinate a prova di CropBox
- Il renderer rasterizza la box visibile, il CropBox ritagliato sul MediaBox (ISO 32000-1 §14.11.2); ogni mappatura pixel-a-pagina deve usare quella box, letta con
GetLoadedPageVisibleBox ApplyLoadedOCRTextLayer,DecodeLoadedPageBarcodessull'intera pagina e i risultati dei volti daDetectLoadedRedactionFindingsmappano tutti attraverso la box visibile, e così deve fare qualsiasi motore o detector personalizzato- Le box
THPDFOCRWordsono pixel bitmap con origine in alto a sinistra;GetLoadedPageBoxeGetLoadedPageVisibleBoxrestituiscono user space PDF con origine in basso a sinistra eBottom < Top - La scala è
DPI / 72; ricavala dal DPI, mai da una page box divisa nella larghezza della bitmap - /Rotate decide quali bordi contano: Left e Bottom a 0 e 90, Right e Bottom a 180, Right e Top a 270
- Restituisci le parole OCR in pixel e lascia mappare a HotPDF; converti solo per la tua logica di filtro
- Quando rifai l'OCR su pagine che portano già un livello di testo, ricorda che
SkipPagesWithTextle salta se non la disattivi o non rimuovi prima il vecchio livello
Le funzionalità di riconoscimento, le interrogazioni delle page box e il rendering dei documenti caricati usati qui viaggiano tutti nel componente HotPDF per Delphi e C++Builder; licenze, download di prova e la lista completa delle funzionalità sono sulla pagina di HotPDF Delphi PDF component