Un report taggato a cui è stata tagliata via la copertina può aprirsi con il numero di pagine giusto ed essere comunque rotto in tre punti: il bookmark "Contenuto" non fa nulla quando lo clicchi, il checker di accessibilità segnala un elemento di struttura che non appartiene a nessuna pagina e un validatore severo segnala un riferimento a un oggetto libero. L'albero delle pagine è a posto. ISO 32000-1 §7.7.3 chiede solo che la pagina esca da /Kids e che /Count scali di uno, e un file può rispettare quella clausola con metà del catalogo che punta ancora alla pagina mancante
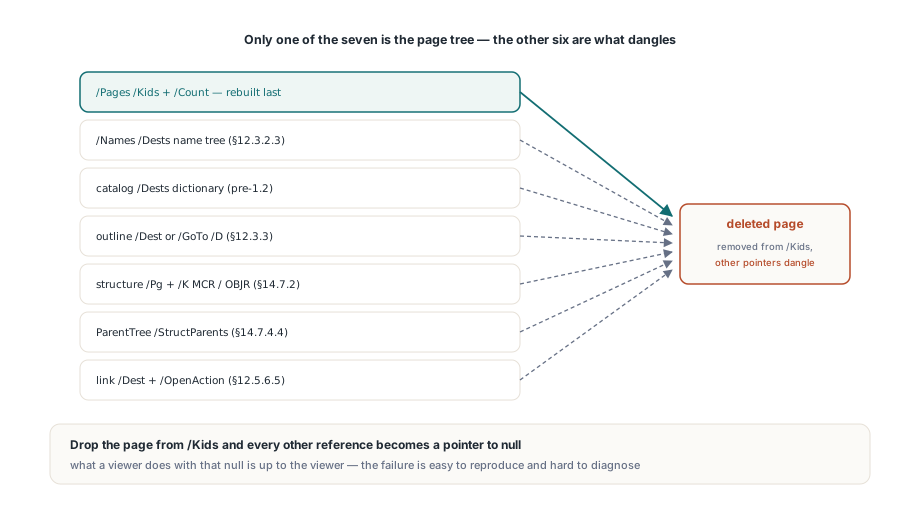
Sette strutture possono tenere un riferimento a una pagina
Una sola è l'albero delle pagine. Le altre sono sparse tra catalogo, outline, struttura logica e annotazioni di altre pagine, e ognuna di loro risolve a null una volta che l'oggetto pagina è sparito dal file. Cosa fa un viewer con quel null è una sua scelta, quindi lo stesso file alleggerito può comportarsi male in modo diverso in due reader
- Il name tree sotto
/Names/Dests(§7.7.4, §12.3.2.3) mappa nomi su array di destinazione il cui primo elemento è la pagina - Il dizionario
/Destspre-1.2 direttamente nel catalogo contiene lo stesso tipo di array, con i nomi come chiavi - Gli outline item (§12.3.3) raggiungono una pagina tramite un
/Destinline o tramite un'azione/Acon/S /GoToe un array/D - Gli elementi di struttura (§14.7.2) portano una chiave
/Pgche nomina la pagina su cui vive il loro marked content, e i loro figli/Kpossono essere marked-content reference e object reference (§14.7.4.3) legati a quella pagina - Il
ParentTree(§14.7.4.4) riporta i numeri/StructParentsdi pagine e annotazioni agli elementi di struttura, e un elemento può starci senza comparire da nessuna parte nella catena di/Kdalla radice - Le annotazioni link su altre pagine (§12.5.6.5) portano un
/Desto un'azione/GoTopuntata sulla pagina, e il/OpenActiondel catalogo può fare lo stesso
Cosa fa THotPDF.DeletePage prima di toccare /Kids
THotPDF.DeletePage(PageIndex) su un documento caricato passa prima in rassegna tutte quelle strutture e riscrive l'albero delle pagine per ultimo. L'indice è zero-based. Due guardie girano prima che qualcosa cambi: un indice fuori intervallo solleva Invalid page number, e una richiesta di rimuovere l'unica pagina rimasta solleva a sua volta un'eccezione, perché un nodo /Pages con zero figli non descrive un documento valido
L'ordine della scansione è fisso: l'albero /Names /Dests, il dizionario /Dests legacy del catalogo, /OpenAction, l'outline, /StructTreeRoot insieme al suo ParentTree, e infine gli array /Annots di ogni pagina che resta. Solo dopo l'oggetto pagina viene marcato come eliminato, i suoi widget annotation vengono staccati dall'albero dei campi AcroForm, e /Kids, /Count e il /Parent di ogni pagina superstite vengono riscritti. Sul fronte dei form, un campo padre rimasto senza figli dopo che il suo widget è andato viene rimosso a sua volta, fino a risalire a /Fields, così un form alleggerito non conserva alcuna voce di campo senza nulla sullo schermo alle sue spalle
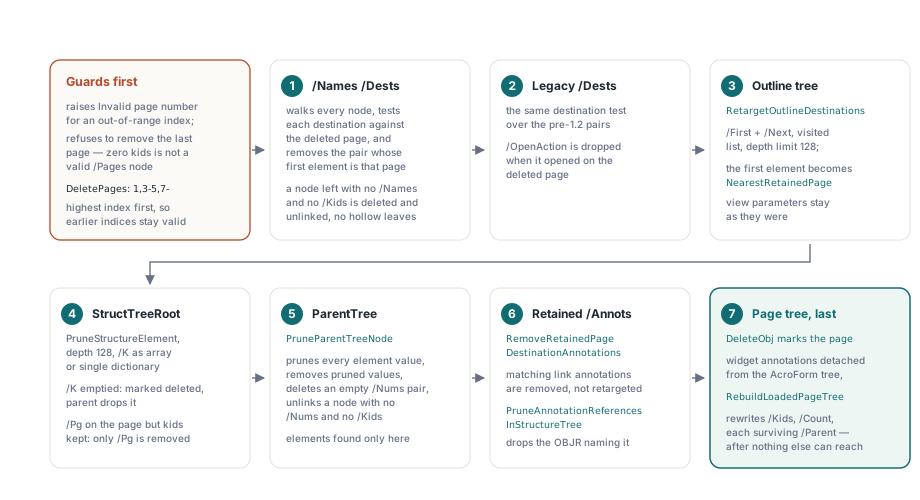
DeletePages prende una stringa di intervalli one-based come '1,3-5,7-', la notazione che usano le altre operazioni su pagine del documento caricato, ed elimina dalla pagina selezionata più alta verso il basso. Andare dall'alto in basso mantiene validi i numeri che hai scritto mentre le pagine spariscono sotto di essi. Un intervallo che copre tutte le pagine solleva un'eccezione per la stessa ragione per cui DeletePage rifiuta l'ultima, e la funzione restituisce quante pagine ha rimosso
var
  Pdf: THotPDF;
  Removed: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
        // LoadFromFile restituisce il numero di pagine caricate
    if Pdf.LoadFromFile('tagged-report.pdf') > 0 then
    begin
            // Zero-based: la pagina 0 è la copertina
      Pdf.DeletePage(0);
            // Intervallo one-based, numerato sul documento com'è adesso
      Removed := Pdf.DeletePages('3-4,9');
      Pdf.SaveLoadedDocument('tagged-report-trimmed.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
I nomi spariscono, i bookmark si spostano
Le named destination puntate sulla pagina eliminata vengono rimosse. I bookmark puntati su di essa vengono riportati altrove. Nell'albero /Names /Dests ogni nodo viene visitato e ogni destinazione viene provata nelle due forme che la specifica consente, l'array nudo e il dizionario con chiave /D; la coppia nome/valore va via quando il primo elemento dell'array è la pagina eliminata. Un nodo intermedio rimasto senza né /Names né /Kids viene scollegato dal padre, così l'albero non conserva foglie vuote. Il dizionario /Dests legacy del catalogo riceve la stessa prova, chiave per chiave, e un /OpenAction del catalogo che apriva sulla pagina eliminata viene abbandonato, il che lascia la vista iniziale al default del viewer
Un nodo che perde voci perde anche il suo array /Limits. Le nuove chiavi minima e massima non vengono ricalcolate, e i viewer risolvono i nomi senza di esse. Il §7.9.6 richiede /Limits sui nodi intermedi e sulle foglie, quindi se un passaggio di preflight della tua pipeline fa rispettare quella regola in modo severo, fai girare il file alleggerito anche lì come parte dello stesso lavoro
L'outline viene percorso tramite /First e /Next con una lista dei visitati e un limite di profondità di 128, così una catena /Next corrotta che rimanda a se stessa non può bloccare la chiamata. Per ogni array /Dest o array /D di un'azione /GoTo puntato sulla pagina eliminata, il primo elemento viene sostituito con la pagina che la seguiva, o con quella che la precedeva quando la pagina eliminata era l'ultima. I parametri di vista dopo il riferimento alla pagina restano com'erano, così un salto /XYZ conserva i suoi valori left, top e zoom e li applica alla nuova pagina
L'asimmetria è voluta. Un nome che non risolve a nulla è legale e innocuo; un GoTo che nomina una destinazione mancante semplicemente non fa nulla. Un bookmark con destinazione null è peggio: resta nella sidebar, sembra cliccabile e fallisce. Atterrare sulla pagina superstite più vicina è il migliore di due esiti imperfetti. Il retargeting copre solo gli array di destinazione espliciti. Un outline item il cui /Dest è una stringa di nome risolve attraverso il name tree, e una volta che la scansione ha rimosso quel nome il bookmark non va da nessuna parte, quindi i documenti che usano pesantemente i bookmark nominati meritano un controllo dopo l'eliminazione. Il controllo qui sotto legge i nomi con ResolveLoadedNamedDestination, che guarda solo l'array /Names del nodo radice; dà una risposta significativa per un name tree piatto, mentre un albero diviso in /Kids restituisce -1 per ogni nome. La struttura dell'outline in sé, inclusa la semantica non ovvia di /Count, è trattata nella guida all'aggiunta di bookmark e named destination su un PDF caricato
// Controlla il risultato invece di darlo per scontato.
// Memo1 è un TMemo sulla tua form.
Pdf.DeletePage(0);
// ResolveLoadedNamedDestination legge solo l'array /Names radice,
// quindi questo controllo ha senso per un name tree piatto; su un
// albero con /Kids restituisce -1 per ogni nome, eliminato o no
if Pdf.ResolveLoadedNamedDestination('cover') = -1 then
  Memo1.Lines.Add('"cover" is not resolvable from the root /Names array');
// Un bookmark che puntava alla copertina ora risolve alla pagina
// che la seguiva, cioè l'indice zero-based 0 dopo l'eliminazione
Memo1.Lines.Add(Format('Bookmark "Contents" -> page index %d',
  [Pdf.GetLoadedBookmarkPageIndex('Contents')]));
Potare lo structure tree e il ParentTree
Gli elementi di struttura che esistevano solo per la pagina eliminata vengono rimossi, e gli elementi che coprono più pagine perdono la chiave /Pg ma conservano i figli. La scansione parte da /StructTreeRoot, scende lungo /K fino a una profondità di 128 e accetta sia la forma array sia la forma dizionario singolo di /K che il §14.7.2 consente. I figli di ogni elemento vengono potati prima di giudicare l'elemento stesso. Se la potatura ha svuotato il suo /K, l'elemento viene rimosso e il padre lo lascia cadere. Se il suo /Pg nomina la pagina eliminata ma ha ancora figli e un padre /P, va via solo /Pg, perché /Pg su un elemento è solo la pagina di default per i figli marked-content che non nominano la propria, e quei figli possono benissimo vivere su altre pagine. Un elemento il cui /Pg è la pagina eliminata e che non ha nulla sotto viene rimosso senza indugi; i dizionari marked-content reference il cui /Pg nomina la pagina rientrano in quest'ultima regola
Il ParentTree riceve lo stesso trattamento, per una ragione facile da perdere di vista: un elemento può essere raggiungibile dal ParentTree e da nessun altro posto. Quel number tree mappa gli interi /StructParents a un singolo elemento o a un array di elementi. Ogni valore viene potato con le regole di sopra, i valori rimossi cadono dai loro array, una coppia /Nums il cui array finisce vuoto viene eliminata, e un nodo senza né /Nums né /Kids viene scollegato. Salta questo passaggio e gli orfani continuano a puntare a una pagina liberata tramite /Pg. Per chi estrae testo in ordine di tag la cosa è diretta: la estrazione testo in ordine di struttura percorre esattamente questi alberi, e un elemento con /Pg null è un paragrafo che cade fuori dall'ordine di lettura
Perché i link sulle pagine superstiti vengono rimossi e non riportati altrove?
Un'annotazione link su una pagina conservata il cui array /Dest o la cui azione /GoTo punta alla pagina eliminata viene rimossa dagli /Annots di quella pagina, e il suo tag va con lei. Il dizionario OBJR il cui /Obj nominava l'annotazione viene tolto dal suo elemento di struttura; se quell'OBJR era l'unico figlio dell'elemento, anche l'elemento viene rimosso, e il ParentTree viene potato di nuovo. Lasciare l'OBJR al suo posto violerebbe il §14.7.4.3, che si aspetta che /Obj referenzi un oggetto reale, e un checker PDF/UA vedrebbe un elemento Link il cui object reference non porta da nessuna parte
I bookmark si spostano; i link no. Un riferimento incrociato nel testo che dice "vedi pagina 3" è sbagliato una volta che la pagina 3 è sparita, e puntarlo in silenzio sulla pagina 4 trasforma un link rotto in un link fuorviante. Un bookmark che atterra sul capitolo successivo è navigazione; un link nel corpo del testo è un'affermazione sul contenuto. La rimozione è il default più sicuro. Se il tuo flusso di lavoro ha bisogno che quei link sopravvivano, riscrivi le loro destinazioni prima di chiamare DeletePage, perché dopo la chiamata sono già fuori dagli array /Annots
Salvataggi incrementali e la trappola del figlio diretto
DeletePage si comporta allo stesso modo tra BeginIncrementalUpdate e SaveIncrementalUpdate. La sezione aggiunta contiene gli oggetti modificati dalla scansione più voci libere per gli oggetti rimossi che avevano un numero d'oggetto proprio, come la pagina e le annotazioni link eliminate. Tutto ciò che sta sopra il %%EOF originale resta byte per byte, come richiede il §7.5.6
Pdf := THotPDF.Create(nil);
try
  Pdf.BeginIncrementalUpdate('tagged-report.pdf');
  Pdf.DeletePage(0);
    // Gli elementi di struttura che hanno perso un figlio /MCR diretto
    // vengono aggiunti in forma riscritta con un array /K più corto
  Pdf.SaveIncrementalUpdate('tagged-report-trimmed.pdf');
finally
  Pdf.Free;
end;
È qui che un potatore scritto a mano sbaglia. Le marked-content reference (/Type /MCR) e le object reference (/Type /OBJR) sono in genere dizionari diretti che stanno dentro l'array /K del loro elemento padre. Un oggetto diretto non ha numero d'oggetto né voce xref, quindi non può essere liberato da solo. La mossa ovvia è "liberare" comunque ogni figlio rimosso, e qualsiasi writer che mappa un oggetto diretto all'oggetto indiretto che lo contiene finirà per liberare il contenitore, che è l'elemento di struttura conservato. Quell'elemento esce come null, e il contenuto taggato di pagine mai toccate perde i suoi tag. HotPDF manda un oggetto rimosso nella free list solo quando ha un numero d'oggetto; per un figlio diretto marca l'elemento contenitore come modificato, così l'elemento viene riscritto con il figlio in meno e la free list resta pulita
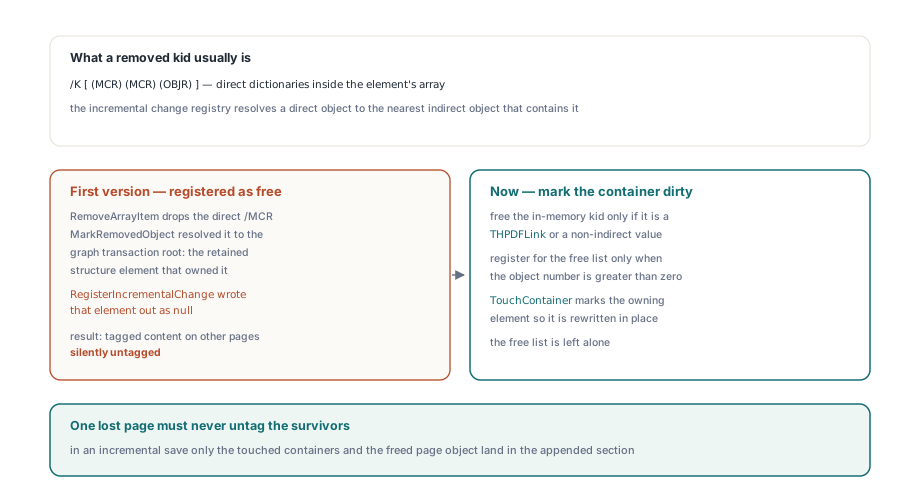
La stessa cautela decide cosa DeletePage lascia in pace su un documento caricato. I content stream, gli XObject e le annotazioni non-widget della pagina eliminata restano come oggetti, perché un file caricato può condividere ognuno di loro con una pagina che resta e non c'è modo economico di provare il contrario al momento dell'eliminazione. Togliere il riferimento dall'albero delle pagine basta per un file corretto. Quanti byte costano ancora quei relitti è una misura a parte, e il grafo delle dipendenze tra oggetti e l'analisi dei byte trattenuti è lo strumento per farla
DeletePage o DeleteLoadedPage?
Usa DeletePage per qualsiasi rimozione di pagina richiesta da un utente. THotPDF.DeleteLoadedPage(PageIndex) è la variante leggera: applica le stesse due guardie, scala la lista delle pagine caricate, riscrive /Kids e /Count, invalida la cache delle pagine renderizzate e scatta OnLoadedDocumentModified. Non tocca il name tree, l'outline, lo structure tree né le annotazioni delle altre pagine, e non marca l'oggetto pagina come eliminato. ComposeLoadedPagesNUp è il lavoro che le si addice: aggiunge fogli appena composti che disegnano le pagine sorgente come form XObject, poi elimina ogni originale con DeleteLoadedPage(0), dato che i fogli referenziano il contenuto delle pagine e non gli oggetti pagina. Per un "togli la pagina 7 da questo contratto" su un file taggato, con bookmark e riferimenti incrociati, DeletePage è la chiamata che lascia ogni riferimento coerente, che tu salvi con SaveLoadedDocument o aggiunga sezioni con SaveIncrementalUpdate
Entrambi i metodi, il DeletePages a intervalli e il percorso di aggiornamento incrementale usato sopra fanno parte dell'HotPDF Delphi Component, che modifica PDF caricati da codice Delphi e C++Builder senza runtime di viewer sulla macchina