Per un report di 400 pagine che incorpora un solo font da 2 MB, addebitare a ogni pagina tutto ciò che referenzia produce un totale strano: le pagine sommano 800 MB di font in un file che su disco può pesare 30 MB. Dividi invece il font in parti uguali e ogni pagina costa circa 5 KB, così nulla sembra costoso e la memoria sembra venire dal nulla. Nessuno dei due numeri risponde alla domanda vera, cioè quanti byte verrebbero liberati se un dato oggetto scomparisse
Quel numero ha un nome nell'analisi degli heap, retained size, e la teoria dei grafi offre un modo pulito per calcolarlo. Un oggetto viene messo in conto al suo dominator, l'oggetto più vicino che ogni percorso dalla radice è obbligato a attraversare per arrivarci. Gli oggetti condivisi risalgono finché non raggiungono un nodo che li possiede davvero, quelli esclusivi restano al loro posto, e i totali si sommano senza doppi conteggi
Dimensione shallow, dimensione retained e la regola del dominator in HotPDF
HotPDF lo calcola per un documento caricato tramite THotPDF.BuildLoadedObjectDependencyGraph. La chiamata restituisce un THPDFObjectDependencyNode per ogni oggetto indiretto caricato e un THPDFObjectDependencyEdge per ogni riferimento indiretto, poi esegue un'analisi dei dominator con radice nel Catalog del documento, l'oggetto indicato dalla entry /Root del trailer (ISO 32000-1 §7.7.2). Ogni nodo porta con sé due dimensioni. EstimatedShallowBytes è quanto costa l'oggetto da solo. EstimatedRetainedBytes è il suo costo più la dimensione shallow di ogni oggetto che domina
Torniamo al font. Lo referenzia ogni pagina, quindi nessuna pagina da sola lo domina; i percorsi convergono solo nel nodo dell'albero delle pagine sopra quelle pagine, che in un albero piatto è l'oggetto radice /Pages. I 2 MB del font finiscono lì e poi risalgono fino al Catalog. Un image XObject disegnato sulla pagina 12 e da nessun'altra parte è il caso opposto: ogni percorso verso di lui passa per la pagina 12, quindi la dimensione retained della pagina 12 include l'intera immagine. La cima della lista retained è dunque una lista di oggetti la cui rimozione libererebbe memoria
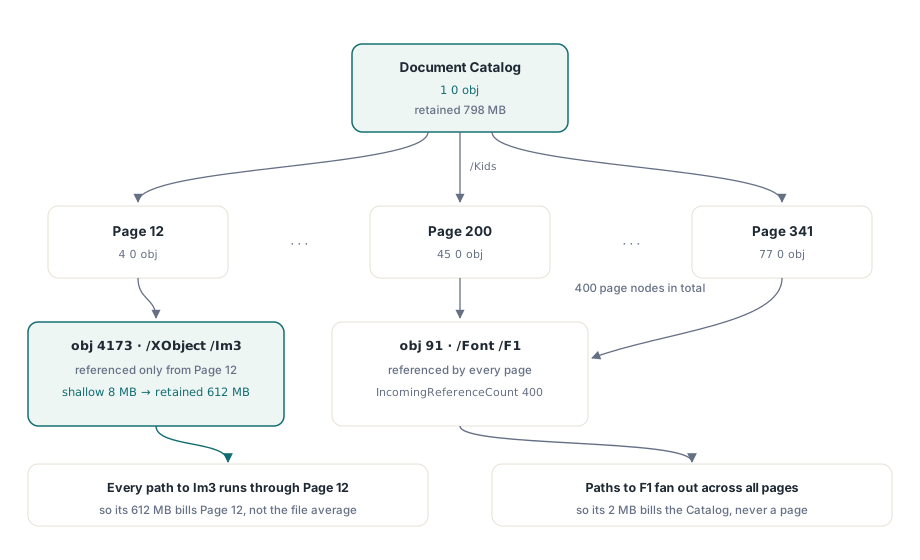
La stessa aritmetica regala anche un controllo incrociato. THPDFObjectDependencyGraphInfo.CatalogRetainedBytes equivale alla somma delle dimensioni shallow di ogni oggetto raggiungibile dal Catalog, mentre TotalEstimatedBytes è la somma delle dimensioni shallow di ogni oggetto caricato, raggiungibile o meno. La differenza tra i due è memoria trattenuta da oggetti a cui il documento non punta più
Eseguire il grafo e leggere un risultato fallito
Il metodo restituisce True solo quando l'intera analisi è giunta a termine, ed è quel valore di ritorno che va controllato. Un risultato False riempie comunque il record informativo, ma gli array non sono qualcosa da usare per un report. Quando il numero di oggetti supera MaxObjects (predefinito 250.000), il metodo si ferma prima di costruire qualsiasi nodo e imposta ObjectCount a uno più del limite, così scopri che il limite era troppo piccolo, non quanto è grande il documento. Quando durante la scansione si esaurisce il budget degli archi (predefinito 2.000.000) o si tocca il limite di annidamento a 256 livelli per gli oggetti diretti, i nodi tornano con dimensioni shallow parziali e senza dimensioni retained né informazioni di raggiungibilità
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile restituisce il numero di pagine; 0 significa che il caricamento è fallito
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // Limiti alzati per un'analisi forense offline
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Log è la tua routine di logging
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // non ordinare né sommare un array di nodi parziale
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;
Altri due flag meritano uno sguardo in quel ramo di fallimento. InvalidObjectGraph viene impostato quando l'oggetto Catalog non si trova tra gli oggetti caricati, o quando un oggetto diretto risulta contenere se stesso, cosa che accade solo con input malformati. LimitExceeded copre anche un'analisi dei dominator che non si è assestata entro 128 passate. Diagnostic spiega ogni caso in una riga. Passare zero o un valore negativo per MaxObjects, o un MaxEdges negativo, solleva EArgumentOutOfRangeException invece di restituire False
Quando la chiamata fallisce per un limite, butta gli array e rilanciala con limiti più larghi. Le dimensioni shallow parziali sembrano plausibili in un log e sono sbagliate esattamente nel modo che manda la gente a caccia dell'oggetto sbagliato. I limiti esistono perché il grafo ha un costo tutto suo: ogni arco memorizza una stringa Path, quindi un'esecuzione da otto milioni di archi alloca otto milioni di piccole stringhe in aggiunta al documento che sta misurando. Appartiene a un percorso diagnostico che qualcuno attiva di proposito
Cosa conta davvero EstimatedShallowBytes?
EstimatedShallowBytes stima la memoria residente, non i byte nel file. Per ogni oggetto somma la dimensione dell'istanza dell'oggetto analizzato e dei suoi figli diretti, gli slot tenuti dalle liste di dictionary e di array, la lunghezza di ogni chiave, nome e stringa, e il payload di uno stream se quel payload è in RAM: uno stream in memoria, oppure uno stream a caricamento lazy già letto in memoria. Uno stream i cui byte stanno ancora nel file sorgente, o che è stato versato su un file temporaneo, contribuisce solo con il proprio overhead da oggetto
La conseguenza è pratica. Un file ricco di scan profilato subito dopo il caricamento può mostrare dimensioni retained modeste per le sue immagini, perché nulla le ha ancora decodificate. Esegui il grafo dopo il passo che ha fatto crescere il processo (rendering, estrazione del testo, un merge) e gli stream materializzati compariranno con il loro peso reale. Per un controllo riproducibile, profila lo stesso file due volte, una subito dopo LoadFromFile e una dopo l'operazione costosa, e confronta le voci in cima
ObjectType è grossolano. Riporta il tipo di valore PDF, otStream o otDictionary e così via, quindi un'immagine, un programma di font e un content stream di pagina risultano tutti come otStream. Il ruolo si vede nell'arco in entrata. THPDFObjectDependencyEdge.Path registra dove nell'oggetto sorgente è stato trovato il riferimento, partendo da $, con /Key per le entry di dictionary, [n] per gli elementi di array e /dictionary per il dictionary di uno stream. Un percorso $/Resources/XObject/Im3 da una pagina, o $/XObject/Im3 da un resource dictionary separato, significa che l'oggetto è usato come XObject di nome Im3; $/FontFile2 proveniente da un font descriptor significa un programma TrueType incorporato; $/Contents[0] significa contenuto di pagina
// Un tuo aiutante, non parte della libreria: ordina i primi Count nodi per
// dimensione retained e stampa il percorso di un riferimento in entrata per ciascuno
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;
Un solo percorso in entrata basta per classificare la maggior parte degli oggetti. Per un oggetto condiviso, IncomingReferenceCount ti dice quanti riferimenti ci sono, e ImmediateDominatorObjectNumber con il suo generation number ti dice quale oggetto lo possiede dopo l'analisi dei dominator. Quel campo vale -1 per il Catalog e per ogni oggetto che il Catalog non riesce a raggiungere. Un arco con flag Resolved a False punta a un numero di oggetto non caricato; questi vengono contati in UnresolvedReferenceCount, e un conteggio alto su un file per il resto sano di solito significa una sezione cross-reference danneggiata
Da dove vengono gli oggetti non raggiungibili?
Un nodo con ReachableFromCatalog impostato a False è caricato e costa memoria, ma nessuna catena di riferimenti dal Catalog porta a lui, quindi nulla nella struttura del documento conduce un viewer fino a lui. La sua dimensione retained equivale alla sua dimensione shallow, perché l'analisi dei dominator gira solo sugli oggetti raggiungibili. Sommare EstimatedRetainedBytes sui nodi non raggiungibili dà quindi lo stesso risultato di TotalEstimatedBytes - CatalogRetainedBytes
Gli incremental update sono una fonte comune, anche se non nel modo in cui la gente tende a immaginare. Quando una revisione successiva ridefinisce l'oggetto 2120, vince l'entry cross-reference più recente e la definizione più vecchia non viene mai caricata, quindi le copie superate dello stesso numero di oggetto non compaiono nel grafo. Quello che compare è un oggetto che una revisione successiva ha semplicemente smesso di referenziare: un'annotazione eliminata da un array /Annots riscritto, un'immagine sostituita da un nuovo numero di oggetto, un campo di form rimosso dall'AcroForm. Nulla in ISO 32000-1 §7.5.6 obbliga un update a marcare quelle entry come libere, e finché i dati cross-reference le elencano come in uso il loader le tratta come oggetti vivi. L'articolo sugli object stream e gli incremental update copre come si impilano le revisioni
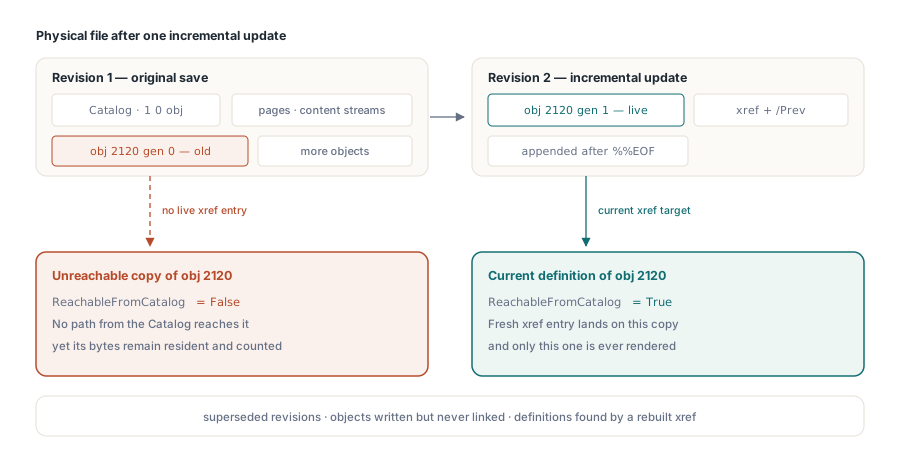
Le altre due fonti sono i producer che scrivono oggetti e poi non riescono a collegarli, e i file danneggiati i cui dati cross-reference hanno dovuto essere ricostruiti con una scansione, che può raccogliere definizioni di oggetti a cui nulla fa riferimento. Quando una larga quota del totale stimato risiede in nodi non raggiungibili, una riscrittura pulita del file batte l'append di un'altra revisione ancora, e il grafo ti dà il conteggio di byte per giustificare il salvataggio più lento
È il parser a trattenere memoria?
Prima di incolpare il documento, verifica come si è comportato il caricamento stesso. Due chiamate descrivono il parser anziché il contenuto, ed entrambe si azzerano all'inizio di ogni LoadFromFile o LoadFromStream, quindi descrivono sempre il caricamento più recente
GetLastParserArenaStatistics riempie un record THPDFParserArenaStatistics per l'arena a blocchi che tiene token e buffer di breve vita durante il parsing. I blocchi sono da 64 KiB (BlockSize), e un'allocazione più grande di un blocco riceve un blocco della sua stessa dimensione. AllocationCount meno ReusedAllocationCount fa BlockAllocationCount, il numero di volte in cui l'arena ha dovuto chiedere un nuovo blocco al memory manager. I blocchi restano per tutta la vita dell'istanza THotPDF e vengono liberati quando viene distrutta. Se una singola istanza processa un intero batch, RetainedBytes riflette all'incirca il working set più grande di cui ha avuto bisogno qualche file del batch, il che spiega un plateau che dura finché il componente non viene liberato. TemporaryObjectElisionCount conta le chiavi di dictionary lette direttamente nell'arena invece di essere costruite come oggetti nome temporanei
GetDocumentStringInternStatistics descrive il pool per documento che deduplica nomi PDF, operatori di content stream e stringhe brevi. Sono ammissibili le stringhe da 1 a 64 byte. Il pool tiene al massimo 65.536 voci e 4 MiB, e questi tetti tornano nel record come MaxStringLength, MaxEntryCount e MaxRetainedBytes. Una stringa vuota, più lunga di 64 byte, o nuova con il pool pieno viene contata in BypassCount e tenuta come stringa ordinaria. Un file che genera un numero enorme di nomi unici costa quindi più o meno quanto costerebbe senza il pool, e non di più
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // Un tuo controllo, non una chiamata di libreria: segnala un pool che ha toccato i tetti
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;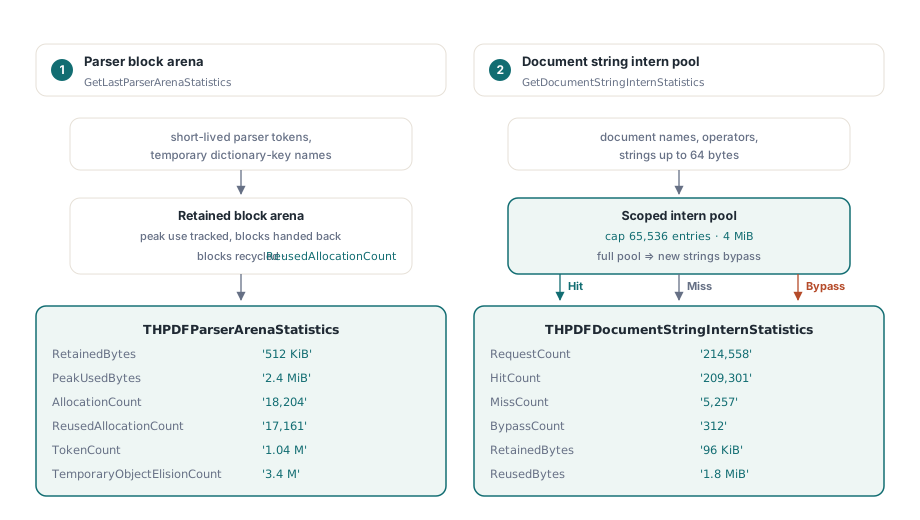
I PDF tipici ripetono un piccolo vocabolario di nomi e operatori, quindi HitCount sta vicino a RequestCount e ReusedBytes cresce col numero di pagine. Un BypassCount che si avvicina a RequestCount su un file modesto è insolito. Su un percorso di ingestion di upload non attendibili, loggalo
Un ordine di triage per un problema di memoria
Parti da CatalogRetainedBytes. Se è vicino alla crescita che hai misurato nel processo, la memoria è nel documento e la cima della lista retained lo indicherà. Se sta molto più in basso, la memoria vive in un punto che il grafo non misura, come le tue cache, i bitmap renderizzati o l'arena del parser, e il record dell'arena è la cosa successiva da leggere
- Ordina i nodi per
EstimatedRetainedBytese leggi ilPathin entrata dei primi dieci. I target XObject in cima indicano di solito contenuti ricchi di scan dove il downsampling ripaga; i target/FontFile,/FontFile2o/FontFile3indicano programmi di font completi incorporati dove sarebbero bastati i subset; gli stream/Contentsgrandi vengono di solito da output vettoriale generato, come mappe o export CAD - Sottrai
CatalogRetainedBytesdaTotalEstimatedBytes. Un resto grande significa oggetti abbandonati, quindi la correzione sta nel passo di salvataggio - Leggi per ultimi i record dell'arena e dell'intern. Raramente spiegano gigabyte, ma spiegano bene un processo che resta grande dopo la chiusura di ogni documento
Esegui quei passi in quest'ordine. Il primo chiude la maggior parte dei casi, e per i documenti molto grandi la risposta strutturale è spesso smettere di tenere in memoria l'intero grafo di oggetti, che è ciò per cui è pensato il workflow della direct file API
Tutte e tre le diagnostiche sono normali chiamate di metodo che restituiscono semplici record, quindi si innestano nel logging o nella telemetria che un'applicazione Delphi o C++Builder ha già. HotPDF viene distribuito come componente VCL nativo con sorgente completo; documentazione e download di prova sono sulla pagina del componente PDF Delphi HotPDF