PDFlibPas, la PDF Library per Delphi, importa immagini TIFF la cui compressione JPEG va oltre la baseline a 8 bit: sequenziale estesa a 12 bit (SOF1), Huffman lossless (SOF3), con codifica aritmetica (SOF9 e SOF10) e il vecchio JPEG TIFF 6.0 con tabelle a offset. Poiché il DCTDecode del PDF non può trasportare quei processi, PDFlibPas li decodifica in Pascal nativo e incorpora i campioni senza perdite a 8 o 16 bit per componente
Il set completo richiede la v3.724.0 o successiva, e mira dritto ai TIFF provenienti da scanner, software di acquisizione medico e scientifico, e sistemi di archivio congelati negli anni Novanta. Qui sotto c'è perché queste varianti non possono essere copiate nel PDF così come sono, come PDFlibPas le smista, e le trappole Pascal trovate lungo la strada
Perché un JPEG a 12 bit non può entrare dritto in un PDF?
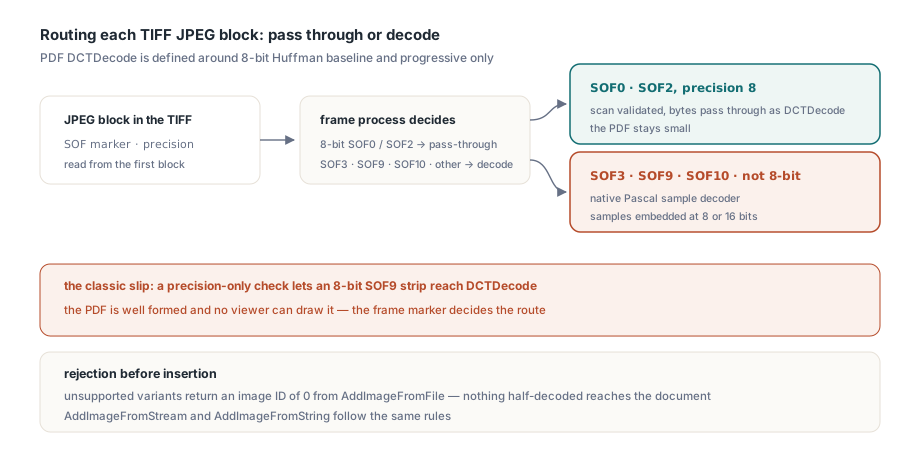
Un JPEG a 12 bit non può essere passato attraverso perché il PDF non ha alcun filtro che sia tenuto a decodificarlo. ISO 32000-1 §7.4.8 definisce DCTDecode attorno al formato baseline JPEG, con l'estensione progressive aggiunta nel PDF 1.3. Nulla in quella clausola copre la precisione dei campioni a 12 bit, il processo lossless dell'allegato H di ITU-T T.81, o il codificatore di entropia aritmetico dell'allegato D. Un reader che incontra un frame SOF1 a 12 bit o un marker SOF9 dentro uno stream DCTDecode ha pieno diritto di non disegnare nulla, e la maggior parte dei viewer fa esattamente questo
Per le strip Huffman baseline e progressive a 8 bit che compongono la maggior parte dei file JPEG-in-TIFF, PDFlibPas continua a validare ogni scan e lascia passare i byte compressi come DCTDecode, il che mantiene il PDF piccolo. Tutto il resto viene decodificato. PDFlibPas legge il frame marker e la precisione dei campioni del primo blocco JPEG, e quando trova SOF3, SOF9, SOF10 o una precisione diversa da 8, la pagina passa per il decoder dei campioni invece che per il percorso pass-through. Individuare la codifica aritmetica dal suo frame marker conta più di quanto sembri: un controllo che guarda solo la precisione dei campioni lascia che un TIFF classico infili una strip SOF9 a 8 bit nel percorso DCTDecode e produca un PDF che i reader non riescono a mostrare
Cosa scrive invece PDFlibPas nel PDF
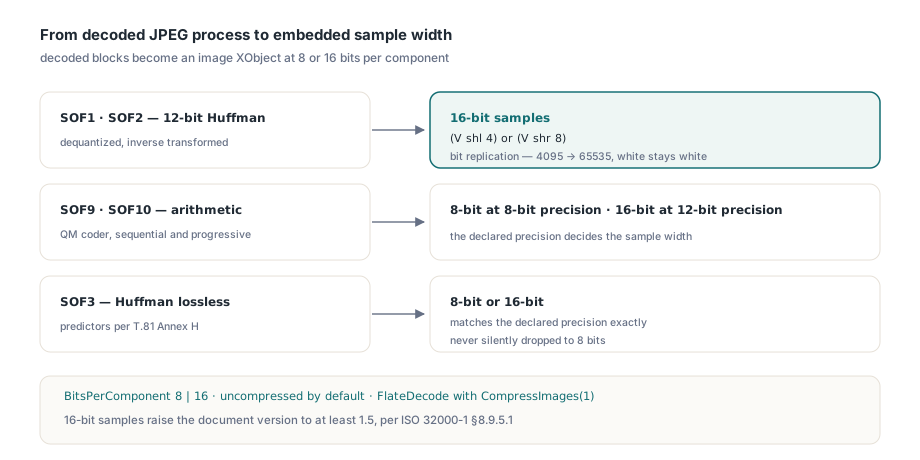
PDFlibPas trasforma i blocchi JPEG decodificati in un comune image XObject con BitsPerComponent 8 o 16. I campioni sono memorizzati non compressi per default; chiamate CompressImages(1) prima di aggiungere l'immagine e PDFlibPas li scrive con FlateDecode. ISO 32000-1 §8.9.5.1 consente 16 bit per componente dal PDF 1.5, così PDFlibPas porta la versione del documento ad almeno 1.5 ogni volta che viene aggiunta un'immagine con campioni a 16 bit. Vale anche per le immagini multi-strip e tiled, il cui oggetto radice è un Form XObject senza un proprio BitsPerComponent da ispezionare
La mappatura è fissa per ogni processo JPEG:
- il JPEG Huffman a 12 bit (sequenziale SOF1, progressive SOF2) viene dequantizzato, trasformato inversamente e allargato a campioni a 16 bit
- il JPEG con codifica aritmetica (sequenziale SOF9, progressive SOF10) diventa campioni a 8 bit con precisione a 8 bit e campioni a 16 bit con precisione a 12 bit
- il JPEG Huffman lossless (SOF3) diventa campioni a 8 o 16 bit, rispettando esattamente la precisione che dichiara
L'allargamento da 12 a 16 bit usa la replicazione dei bit, (V shl 4) or (V shr 8), così 4095 mappa su 65535 e il bianco resta bianco invece di fermarsi a 65520. PDFlibPas non degrada mai queste immagini a 8 bit alle vostre spalle. Quando la libreria rasterizza una pagina simile per la propria superficie di visualizzazione usa il byte alto di ogni campione, ma l'immagine PDF incorporata li conserva tutti e sedici
Il prezzo è la dimensione del file: anche con CompressImages(1), i campioni a 16 bit compressi con Flate sono più grandi dei dati DCT da cui vengono, e senza compressione lo sono ancora di più. Per i flussi diagnostici e d'archivio quel cambio è di solito giusto. Se per un dato lavoro conta di più la dimensione, la guida alla riduzione della dimensione dei file PDF in Delphi mostra dove finiscono davvero i byte
Importare questi TIFF con TPDFlib
Il codice chiamante non cambia affatto. TPDFlib.AddImageFromFile(Const FileName: WideString; Options: Integer): Integer prende il numero di pagina TIFF a base 1 in Options e restituisce un ID immagine, oppure 0 quando la pagina non può essere importata. Le varianti JPEG non supportate vengono rifiutate prima che l'immagine venga inserita, quindi uno 0 significa che nulla di mezzo decodificato è arrivato al documento
uses
  PDFlibrary;

function TiffToPdf(const TiffName, PdfName: WideString): Boolean;
var
  Lib: TPDFlib;
  Page, PageCount, ImageID: Integer;
  DPI, W, H: Double;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    Lib.SetMeasurementUnits(0);   // user space predefinito, 1/72 di pollice
    Lib.SetOrigin(1);             // origine in alto a sinistra per DrawImage
    Lib.CompressImages(1);        // Flate per i campioni decodificati
    PageCount := Lib.GetImagePageCount(TiffName);
    if PageCount = 0 then
      Exit;
    for Page := 1 to PageCount do
    begin
      ImageID := Lib.AddImageFromFile(TiffName, Page);  // Options = pagina TIFF
      if ImageID = 0 then
        Exit;                     // dati immagine non supportati o danneggiati
      Lib.SelectImage(ImageID);
      case Lib.ImageResolutionUnits of
        2: DPI := Lib.ImageHorizontalResolution;          // punti per pollice
        3: DPI := Lib.ImageHorizontalResolution * 2.54;   // punti per cm
      else
        DPI := 0;
      end;
      if DPI <= 0 then
        DPI := 300;
      W := Lib.ImageWidth * 72 / DPI;
      H := Lib.ImageHeight * 72 / DPI;
      if Page > 1 then
        Lib.NewPage;
      Lib.SetPageDimensions(W, H);
      Lib.DrawImage(0, 0, W, H);
    end;
    Result := Lib.SaveToFile(PdfName) = 1;
  finally
    Lib.Free;
  end;
end;
Non serve alcun branching per formato, e AddImageFromStream e AddImageFromString seguono le stesse regole per dati TIFF tenuti in memoria
JPEG vecchio stile: tabelle a offset, strip senza header
Dalla v3.713.0, PDFlibPas importa TIFF JPEG vecchio stile (Compression = 6) le cui tabelle arrivano dai tag a offset JPEGQTables, JPEGDCTables e JPEGACTables o da uno stream JPEGInterchangeFormat di sole tabelle. TIFF 6.0 Sezione 22 definiva quel layout, e TIFF Technical Note 2 l'ha poi sostituito con Compression = 7 e un tag condiviso JPEGTables, ma gli scanner hanno continuato per anni a scrivere la forma vecchia
Il lato contenitore, BigTIFF e layout tiled, è coperto nella cronaca dell'irrobustimento del decoder TIFF; qui il focus è il payload JPEG. Ogni tag a offset di tabella punta a una tabella di quantizzazione grezza da 64 byte, o a una tabella Huffman di 16 conteggi seguiti dai suoi valori, una voce per componente. PDFlibPas li trasforma in segmenti DQT e DHT dentro uno stream JPEGTables sintetizzato. Ogni strip di dati entropy-coded nudi riceve poi un header suo: SOI, un frame marker che porta il numero di righe di quella strip, DRI quando JPEGRestartInterval è impostato, SOS, i dati di entropia ed EOI. Le strip non possono essere incollate in un solo scan, perché il JPEG vecchio stile riavvia la predizione DC a ogni confine di strip
Due dettagli sono facili da sbagliare. I tre componenti di un'immagine YCbCr puntano spesso i loro offset di tabella sugli stessi byte, quindi PDFlibPas deduplica le tabelle per contenuto prima di assegnare i numeri di tabella. Se restano più di due tabelle Huffman di una stessa classe, il frame sintetizzato usa SOF1 invece di SOF0, dato che un frame baseline può riferire solo due tabelle DC e due AC. Quando JPEGInterchangeFormat invece punta a uno stream JPEG completo che contiene degli scan, PDFlibPas tratta quello stream come l'intera immagine e la importa come un'unica strip di nuovo stile. Il JPEG vecchio stile lossless, tiled e a piani separati viene rifiutato con un errore esplicito invece di essere tirato a indovinare, quindi convertiteli in JPEG di nuovo stile a monte
Perché un JPEG CMYK dentro un TIFF esce invertito?
Un JPEG CMYK dentro un TIFF esce invertito quando l'importer applica la convenzione Adobe APP14 che appartiene ai file JPEG autonomi. Photoshop scrive CMYK invertito nei JPEG autonomi, così i produttori PDF tradizionalmente aggiungono /Decode [1 0 1 0 1 0 1 0] per compensare. TIFF PhotometricInterpretation 5 definisce i campioni come quantità di inchiostro dove 0 significa nessun inchiostro, e i reader TIFF mainstream prendono i campioni JPEG decodificati alla lettera senza guardare APP14
PDFlibPas incorpora le strip TIFF CMYK compresse JPEG senza l'array Decode invertito, che ci sia o meno un marker APP14. La bandiera transform di APP14 continua a decidere se YCCK viene convertito in CMYK, e DCTDecode gestisce da solo quel passaggio. I file JPEG autonomi a quattro componenti conservano la convenzione Adobe invertita, così byte JPEG identici vengono trattati diversamente a seconda del contenitore, come i due formati pretendono
Perché la decodifica JPEG lossless si rompe su uno shift Pascal?
La decodifica JPEG lossless si rompe in Pascal perché i predittori 5 e 6 richiedono uno shift destro aritmetico e lo shr del Pascal è logico. SOF3 predice ogni campione dai vicini sinistro (Ra), superiore (Rb) e in alto a sinistra (Rc) e codifica solo la differenza. Dei sette predittori nella tabella H.1 di T.81, il predittore 5 è Ra + ((Rb - Rc) >> 1) e il predittore 6 è Rb + ((Ra - Rc) >> 1), e la differenza tra parentesi va in negativo ogni volta che il vicino in alto a sinistra è quello più chiaro. Dare un Integer negativo in pasto a shr trasforma il bit di segno in un bit di magnitudine, così l'immagine si scioglie in rumore
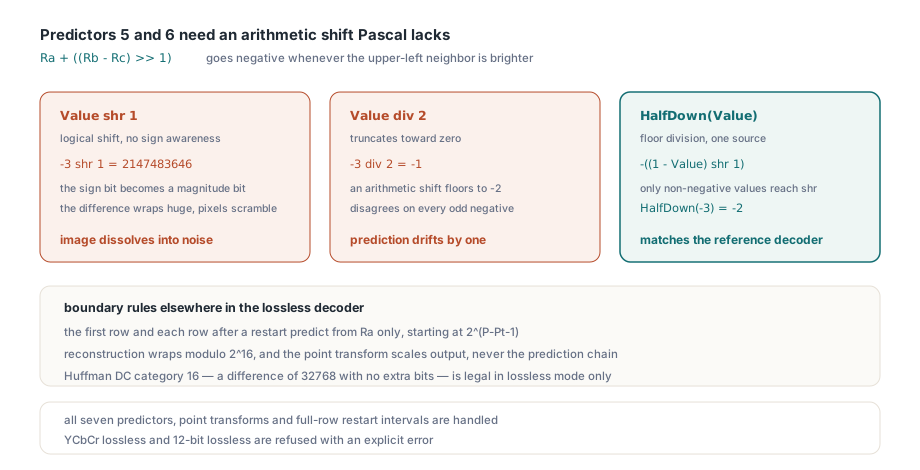
Sostituire lo shift con div 2 non sistema nemmeno quella. div tronca verso zero mentre uno shift aritmetico arrotonda verso l'infinito negativo, e i due divergono su ogni valore negativo dispari. Free Pascal ha SarLongint nella sua unità System; Delphi non ha un equivalente, così PDFlibPas usa un helper che compila identico su entrambi:
// Shift destro aritmetico di uno: floor(Value / 2)
// shr è uno shift logico, e div 2 tronca verso zero
function HalfDown(Value: Integer): Integer;
begin
  if Value >= 0 then
    Result := Value shr 1
  else
    Result := -((1 - Value) shr 1);
end;

// Value = -3:  -3 shr 1 = 2147483646,  -3 div 2 = -1,  HalfDown(-3) = -2
Per il lato larghezze dei tipi della stessa famiglia di problemi, vedete trappole su Longint e puntatori su Delphi Linux64
Il resto del decoder lossless ha regole di confine sue. La prima riga, e la prima riga dopo ogni restart marker, predice solo dal vicino sinistro e parte da 2^(P−Pt−1) per precisione P e point transform Pt; ogni riga successiva parte dal campione sopra. La ricostruzione lavora modulo 2^16, e il point transform ridimensiona solo l'output, mai la catena di predizione. La categoria DC 16 di Huffman, una differenza di 32768 senza bit extra, è legale solo in modalità lossless, quindi il parser delle tabelle deve accettarla prima ancora di sapere quale processo dichiarerà il frame
PDFlibPas supporta tutti e sette i predittori, i point transform e gli intervalli di restart che coprono righe intere. La precisione JPEG deve eguagliare BitsPerSample ed essere 8 o 16, e ogni componente deve essere campionato 1x1. I dati YCbCr lossless e il JPEG lossless a 12 bit vengono rifiutati con un errore esplicito
DCT a 12 bit e codifica aritmetica in Pascal nativo
I decoder a 12 bit e aritmetico di PDFlibPas condividono una sola DCT inversa e differiscono solo nella decodifica di entropia. Nel JPEG Huffman a 12 bit, le categorie DC arrivano a 15 e le AC a 14, le tabelle di quantizzazione possono portare voci a 16 bit, e la predizione DC si azzera a ogni scan e a ogni restart. I coefficienti restano in ordine zigzag fino alla dequantizzazione, che deve usare il valore di quantizzazione allo stesso indice zigzag, e solo dopo passano all'ordine naturale per la IDCT separabile a due passate. I campioni decodificati atterrano entro ±1 da un decoder di riferimento in floating point indipendente
La codifica aritmetica sostituisce Huffman con il QM coder dell'allegato D di T.81: una tabella di stati di probabilità da 114 voci, un'area statistica DC da 64 caselle e una AC da 256 caselle, guidate dai parametri di conditioning del segmento DAC (default L = 0, U = 1, Kx = 5). Statistiche, contesto DC e predizione si azzera a ogni intervallo di restart e all'inizio di ogni scan. Ecco perché PDFlibPas conserva i segmenti DAC quando normalizza i JPEGTables condivisi per le immagini aritmetiche; buttateli e ogni strip decodifica con il modello statistico sbagliato
La v3.723.0 ha aggiunto a questi percorsi decodificati i componenti sottocampionati e la conversione YCbCr-to-RGB con le equazioni JFIF, e la v3.724.0 ha aggiunto gli scan progressive sia per i dati Huffman a 12 bit (SOF2) sia per quelli aritmetici (SOF10). La croma sottocampionata viene replicata a piena risoluzione invece che attenuata, che è ciò che produce un decoder di riferimento con lo smoothing della croma spento. Il JPEG gerarchico e il JPEG lossless con codifica aritmetica (SOF11) vengono rifiutati con un errore esplicito
Testare fixture JPEG binarie in Delphi
Le fixture JPEG costruite a mano nei test unit Delphi possono fallire in un modo che somiglia esattamente a un bug del decoder. Una costante stringa costruita da caratteri #$xx che supera i 255 caratteri viene tipizzata come UnicodeString, e assegnarla a un AnsiString la converte attraverso la code page attiva. I byte da $80 a $9F, routine nei dati entropy-coded, vengono riscritti durante l'ingresso. Costruire header dei marker a runtime ha la stessa trappola: in Delphi, AnsiChar + AnsiChar produce una UnicodeString, quindi aggiungete singoli byte a un AnsiString oppure scriveteli con SetLength e assegnamento indicizzato. Per le fixture, memorizzate testo esadecimale e decodificatelo a runtime:
uses
  SysUtils, PDFlibrary;

function HexToBytes(const Hex: AnsiString): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Hex) div 2);
  for I := 1 to Length(Result) do
    Result[I] := AnsiChar(StrToInt('$' + string(Copy(Hex, I * 2 - 1, 2))));
end;

// La fixture resta ASCII puro, così nessuna code page può toccarla
ImageID := Lib.AddImageFromString(HexToBytes(TiffHex), 1);
Generando immagini di test, notate che jpegtran -arithmetic scrive SOF9 sequenziale; SOF10 richiede anche -progressive. E un ID immagine diverso da zero prova solo che l'import è stato accettato. Renderizzate la pagina e confrontate i pixel, perché un errore di pass-through produce un PDF ben formato che nessun viewer sa disegnare
Portare gli archivi di scan legacy nel PDF
Queste varianti JPEG tendono a emergere tutte insieme durante una migrazione d'archivio. PDFlibPas legge i TIFF JPEG a 12 bit, lossless, aritmetici e vecchio stile attraverso la stessa chiamata AddImageFromFile di tutto il resto, conserva la precisione piena nel PDF, e rifiuta con un errore esplicito i processi rari fuori da quel set. Per le licenze, la lista completa delle funzionalità e i download di prova, vedete la pagina del prodotto PDFlibPas PDF Library for Delphi