Digitate un nome nella casella Applicant a pagina 1 di un pacchetto di richiesta appena unito, passate oltre, e in molti viewer la casella Applicant a pagina 6 si riempie con lo stesso testo. Nessuno ha collegato quei due controlli. La parte 1 e la parte 3 del pacchetto sono state scritte da persone diverse, entrambe hanno chiamato un campo top-level Applicant, e un modulo PDF identifica un campo tramite il suo nome completamente qualificato. Due campi con un solo nome sono, per quanto riguarda il formato file, un campo disegnato due volte
La correzione è decidere cosa un nome condiviso dovrebbe significare prima che il merge avvenga: rifiutarlo, conservarlo di proposito, o rinominare il nuovo arrivato. Decidere dopo è molto più difficile di quanto suoni
Cosa intende ISO 32000 per nome di campo
Un nome di campo è identità, e la specifica lo dice. ISO 32000-1 §12.7.3.2 costruisce il nome completamente qualificato dal nome parziale (la voce T) di un campo e di ciascuno dei suoi antenati, uniti con punti. La stessa sezione consente a più dizionari di campo di condividere un nome completamente qualificato e li descrive come diverse rappresentazioni dello stesso campo sottostante, che dovrebbero differire solo nell'aspetto. Concatenare gli array Fields di due moduli scritti indipendentemente produce esattamente quell'assetto per accidente
Il danno dipende da cosa contenevano i campi in collisione. Un Date che significava data di nascita su un modulo e data di firma su un altro ora ha un solo slot di valore, e qualunque valore su cui un viewer si assesta finisce in entrambi i posti. Un Total su un foglio spese e un Total su un modulo di versamento saranno in disaccordo nel momento in cui uno dei due viene calcolato. I campi firma sono il caso peggiore: due widget firma su pagine diverse, un solo nome, e nessuna risposta pulita su quale widget il firmatario abbia approvato davvero
Anche le maiuscole contano. I nomi parziali sono stringhe di testo e nulla nella specifica li ripiega, quindi Total e total sono due campi diversi. Un controllo di collisione che minuscolizza i nomi prima di confrontare segnala conflitti che non esistono, e sotto una policy di rename rinomina campi che nessuno doveva toccare
Controllare i nomi prima che qualcosa si muova
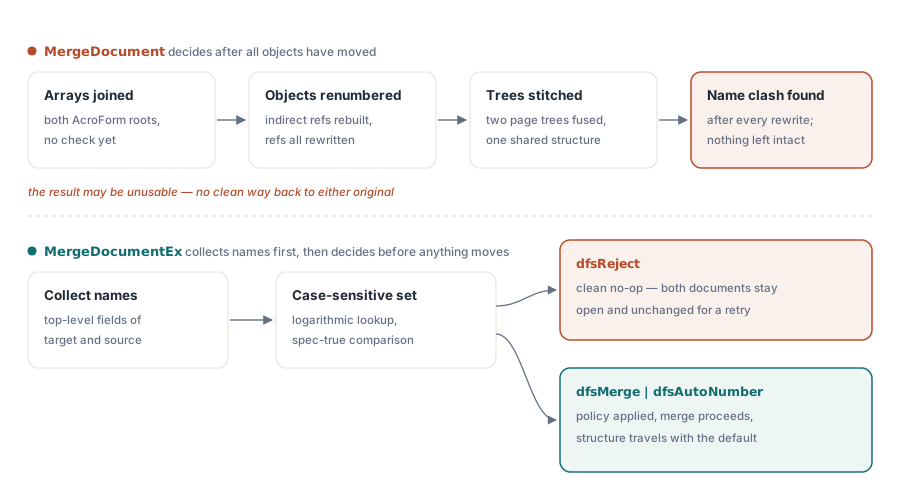
PDF Library for Delphi gestisce la collisione in MergeDocumentEx(DocumentID, DuplicateFieldStrategy), che unisce il documento identificato da DocumentID nel documento attualmente selezionato e risolve ogni conflitto di nome prima che un solo oggetto venga rinumerato. La strategia è un valore TPDFlibDuplicateFieldStrategy: dfsReject, dfsMerge o dfsAutoNumber. Il semplice MergeDocument concatena ancora i due array di campi radice invariati, che è la scelta giusta quando possedete entrambi i moduli e sapete che i loro nomi sono disgiunti
L'ordine è tutto il design. Un merge deve spostare i numeri di oggetto del documento in arrivo perché non collidano con quelli della destinazione, cucire le sue pagine nell'albero pagine della destinazione e accodare i suoi campi al modulo. Se una collisione affiora solo dopo quei passi, rifiutare non è più gratuito — la destinazione ha già assorbito pagine, gli oggetti della sorgente portano numeri con cui nessun file era partito, e il chiamante non ha stato di riserva se non ricaricare entrambi i file da disco. MergeDocumentEx raccoglie prima i nomi dei campi top-level di entrambi i documenti in un set ordinato e case-sensitive e applica la strategia contro quel set. Sotto dfsReject una collisione fa restituire alla chiamata 0 con LastErrorCode impostato a 705, e entrambi i documenti restano esattamente come caricati: potete leggere un valore di campo dal documento sorgente subito dopo il rifiuto e riottenere il testo originale
La scansione in sé è economica. Con n nomi nella destinazione e m nella sorgente, ordinarli in un unico set costa dell'ordine di (n + m) log(n + m) confronti, quindi un pacchetto di qualche centinaio di campi non aggiunge nulla che notereste accanto al parsing dei file
Tre proprietà della scansione affiorano nei pacchetti di moduli reali:
- Vengono confrontati solo i campi top-level. In un modulo gerarchico significa il nome parziale del genitore, quindi due moduli che hanno ciascuno un genitore chiamato
applicantcollidono anche se i figli differiscono, e la rinumerazione automatica rinomina il genitore: i figli in arrivo si leggono quindi comeapplicant_2.nameeapplicant_2.address - I nomi in arrivo entrano nel set mentre vengono controllati. Un documento sorgente che porta già due campi top-level con lo stesso nome fa scattare la strategia sul secondo, anche quando la destinazione non ha affatto un campo di quel nome
- I campi con nome parziale vuoto vengono saltati, e quando uno dei due documenti non ha AcroForm non c'è nulla da confrontare, quindi il merge procede sotto qualunque strategia
Il lato caricamento ha una sua trappola. LoadFromFile aggiunge un nuovo documento alla libreria e lo seleziona, quindi l'identificatore da conservare è quello che SelectedDocument restituisce dopo ogni caricamento. Prendetelo prima del caricamento e state tenendo un documento diverso da quello in cui credete di unire
uses
  SysUtils, PDFlibrary;

procedure BuildPack(const Part1, Part2, OutFile: WideString);
var
  Lib: TPDFlib;
  TargetDoc, SourceDoc: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(Part1, '') = 0 then
      raise Exception.CreateFmt('Cannot load %s', [Part1]);
    TargetDoc := Lib.SelectedDocument;   // si legge dopo il caricamento, non prima

    if Lib.LoadFromFile(Part2, '') = 0 then
      raise Exception.CreateFmt('Cannot load %s', [Part2]);
    SourceDoc := Lib.SelectedDocument;

    Lib.SelectDocument(TargetDoc);       // il documento selezionato riceve il merge
    if Lib.MergeDocumentEx(SourceDoc, dfsReject) = 0 then
    begin
      if Lib.LastErrorCode <> 705 then
        raise Exception.CreateFmt('Merge failed, error %d', [Lib.LastErrorCode]);

      // Nomi top-level duplicati: entrambi i documenti sono intatti,
      // quindi SourceDoc può rientrare dritto in un secondo tentativo
      WriteLn('Duplicate field names in ', Part2, ', retrying with auto-numbering');
      if Lib.MergeDocumentEx(SourceDoc, dfsAutoNumber) = 0 then
        raise Exception.CreateFmt('Merge failed, error %d', [Lib.LastErrorCode]);
    end;

    Lib.SaveToFile(OutFile);
  finally
    Lib.Free;
  end;
end;
Prima severi, poi indulgenti. Quella forma in due passi funziona solo perché il rifiuto lascia SourceDoc caricato e intatto; con un merge che fallisce a metà, il ramo di fallback dovrebbe ricominciare ricaricando entrambi i file. Controllare 705 specificamente conta anche, perché un identificatore di documento non valido o un valore di strategia fuori intervallo fanno fallire la chiamata con un codice diverso, e riprovare con un'altra strategia non sistema nessuna delle due cose
Scegliere una strategia: rifiutare, condividere o rinumerare
Per le pipeline senza supervisione, fate di dfsReject il predefinito e trattate il 705 come un ticket per chi possiede i moduli sorgente. Rinominare un campo a monte una volta sola costa meno che scoprire mesi dopo che una mappatura di export ha smesso silenziosamente di corrispondere perché un merge ha inventato Total_2. Le strategie automatiche guadagnano il loro posto quando un essere umano ha guardato i moduli e deciso cosa significano i nomi condivisi
dfsMerge conserva il nome condiviso di proposito. Prima che qualsiasi cosa venga accodata, il valore e il valore predefinito del campo della destinazione vengono copiati nel campo in arrivo, così il file unito parte coerente e un viewer che raggruppa i widget per nome vede un campo logico con un valore. I due dizionari di campo restano oggetti separati, ognuno con la propria pagina, il proprio aspetto e le proprie azioni. Ripiegarli in un dizionario solo butterebbe via formattazione e comportamento che appartengono al modulo in arrivo, e quel cambio non vale la pena farlo per una semplificazione cosmetica
dfsAutoNumber rinomina i duplicati in arrivo accodando un suffisso numerico, partendo da _2 e prendendo il primo libero. Se la destinazione ha già Shared e Shared_2, il nuovo arrivato diventa Shared_3. Il risultato dipende solo dai nomi presenti, mai dai numeri di oggetto, quindi unire la stessa coppia di file due volte dà gli stessi nomi entrambe le volte — una proprietà su cui contano gli import FDF a valle e le mappature di database
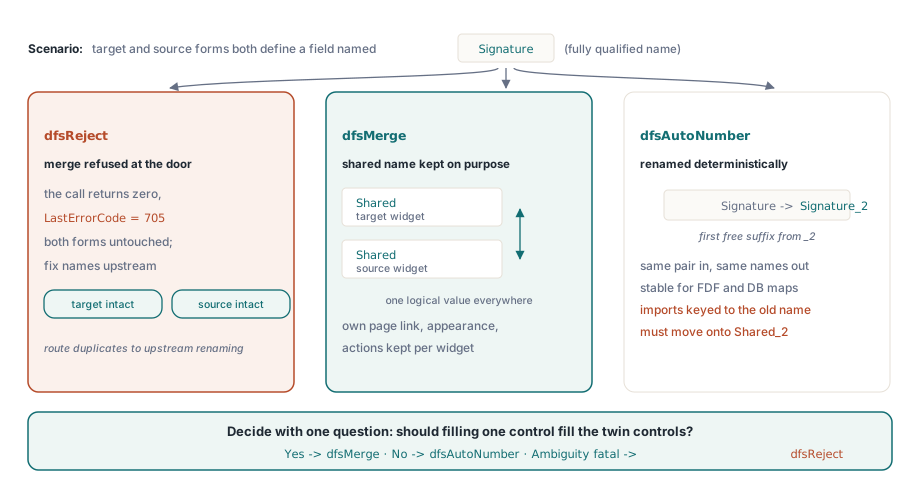
Scegliere tra le due strategie automatiche si riduce a una domanda: riempire un controllo deve riempire l'altro? Per il nome del firmatario ripetuto su ogni parte del pacchetto, sì, e dfsMerge ci sta. Per un totale calcolato diversamente su ogni modulo, no. Lì scegliete dfsAutoNumber, o meglio, rinominate il campo nel modulo sorgente così il suffisso non appare mai
Cosa contiene il modulo unito dopo?
Prendete una destinazione con un campo testo top-level Shared che contiene "Target value" e una sorgente con il suo Shared. Dopo dfsMerge, FormFieldCount conta due campi, entrambi titolati Shared, entrambi riportano "Target value". Dopo dfsAutoNumber, lo stesso input dà Shared e Shared_2, e il campo in arrivo conserva il valore che aveva nel file sorgente
Il risultato dfsMerge ha un filo tagliente, e sta nel vostro codice di riempimento. FindFormFieldByTitle restituisce il primo indice il cui titolo corrisponde, e SetFormFieldValue scrive esattamente un campo. Una routine che cerca Shared una volta e lo imposta aggiorna la copia della destinazione e lascia la copia in arrivo con il valore ricevuto al momento del merge. Il file salvato ora contiene due campi con un nome e due valori diversi, e quale mostra un viewer lo decide il viewer. Scrivete invece ogni corrispondenza:
// Imposta ogni campo che porta Title; restituisce quanti sono stati scritti.
// Dopo un merge dfsMerge un campo logico può comparire a più indici
function SetAllFieldsNamed(Lib: TPDFlib; const Title, Value: WideString): Integer;
var
  I: Integer;
begin
  Result := 0;
  for I := 1 to Lib.FormFieldCount do
    if Lib.GetFormFieldTitle(I) = Title then
    begin
      if Lib.SetFormFieldValue(I, Value) = 1 then
        Inc(Result)
      else
        WriteLn(Format('Field %d (%s) not written, error %d',
          [I, Title, Lib.LastErrorCode]));   // i campi read-only finiscono qui
    end;
end;
Prima di collegare un pacchetto unito a un flusso di dati, scaricate ciò che il merge ha davvero prodotto. Un loop di due righe basta, e becca i genitori rinominati e i suffissi _2 prima che lo faccia un job di import:
for I := 1 to Lib.FormFieldCount do
  WriteLn(Format('%3d  %-30s  %s',
    [I, Lib.GetFormFieldTitle(I), Lib.GetFormFieldValue(I)]));
Assemblare un pacchetto di moduli nella pratica
Un merge riuscito consuma il documento sorgente. Viene rimosso dall'elenco documenti della libreria, quindi DocumentCount scende di uno, e il vecchio identificatore SourceDoc non va più usato. Il documento unito prende la più alta delle due versioni PDF: unire un modulo PDF 2.0 in un documento 1.7 dà un file 2.0, il che conta se un passo di archiviazione a valle si aspetta una versione precisa
L'ordine di merge decide quali nomi sopravvivono. Il documento selezionato conserva ognuno dei suoi nomi, e rinomine o copie di valore si applicano solo ai campi in arrivo, quindi unire A in B e unire B in A dà risultati auto-numerati diversi. Quando un pacchetto ha un modulo primario — quello i cui nomi di campo il vostro back office già conosce — fatelo diventare la destinazione e unitegli i supplementi
Firmate per ultimi. Una firma copre i byte della revisione che ha firmato, e il merge riscrive il file, quindi una parte firmata prima dell'assemblaggio non porta più una firma che corrisponda al documento. Assemblate il pacchetto, controllate l'elenco dei campi, poi applicate le firme al file finito. Se il lavoro riguarda solo cucire pagine insieme e i moduli non contano, il merge PDF veloce con shifting dei riferimenti byte è la strada più rapida
Pianificate il lato dati insieme al merge. Se i valori dei campi arrivano da un sistema esterno che indirizza i campi per nome, sistemate la nomenclatura prima di scegliere dfsAutoNumber, dato che Shared_2 non corrisponderà a una mappatura che si aspetta Shared. I formati di import ed export dei valori sono trattati in interscambio dati dei moduli FDF, XFDF e XFA. Gli script di calcolo e le azioni che referenziano i campi per nome sono influenzati dalla rinomina allo stesso modo, e azioni dei moduli interattivi e JavaScript mostra dove vivono quei riferimenti
Il merge dei moduli consapevole dei duplicati, il riempimento dei campi e la firma digitale sono tutti parte della stessa libreria per progetti Delphi, C++Builder e Free Pascal. La pagina del prodotto PDF Library for Delphi elenca il resto dell'API di assemblaggio di moduli e documenti