Ecco un errore che un reader JBIG2 scritto a mano commette sul primo file insolito che incontra. Parsa l'header del file, parsa il primo header di segmento, legge la lunghezza dati a quattro byte e prende altrettanti byte come corpo del segmento. Sulla maggior parte dei file .jb2 è esattamente giusto. Su un file il cui byte di flag ha il bit 0 a zero, quei byte di "corpo" sono in realtà il secondo, il terzo e il quarto header di segmento, e il decoder aritmetico li trasforma in una bitmap di rumore o corre oltre la fine del buffer. Il file non è rotto. Usa l'organizzazione random-access dell'Annex D.2 di ITU-T T.88, dove ogni header di segmento viene prima e tutti i dati dei segmenti seguono dopo, nello stesso ordine
I file random-access sono rari. Escono da sistemi di archiviazione e document imaging che vogliono far vedere a un reader ogni pagina e ogni dipendenza di dizionario prima che tocchi un byte compresso. Se un job di conversione mescola file da una sorgente del genere con scansioni ordinarie, un file random-access può stare in mezzo a un batch altrimenti tutto sequenziale. Il decoder che li legge è lo stesso decoder Pascal nativo che gestisce le tabelle Huffman custom e i codici prefisso canonici di JBIG2, quindi il lato di codifica non cambia; cambia solo l'ordine in cui i segmenti vengono trovati
Tre layout di file dietro un unico byte di flag
PDF Library for Delphi legge i file JBIG2 standalone tramite TPLJBIG2Decoder nella unit PDFlibJBIG2, e il decoder ricava da solo il layout dall'header del file. L'Annex D di T.88 permette di disporre gli stessi segmenti in tre modi: sequential (D.1) mette ogni header subito davanti ai suoi dati, random-access (D.2) mette tutti gli header prima e tutti i dati dopo, ed embedded (D.3) è la forma senza header usata dentro altri container. Un file standalone inizia con l'identificatore di otto byte 97 4A 42 32 0D 0A 1A 0A, poi un byte di flag, poi un conteggio pagine a quattro byte a meno che i flag non dicano che il conteggio è sconosciuto
Il bit 0 di quel byte di flag sceglie l'organizzazione: 1 significa sequential, 0 significa random-access. Il bit 1 impostato significa che il numero di pagine è sconosciuto e il conteggio a quattro byte è assente, quindi il primo header di segmento inizia al byte 9 invece che al byte 13. I bit da 2 a 7 sono riservati; il decoder accetta i file che li impostano invece di rifiutarli, perché un bit riservato vagante non dice nulla su quanto i segmenti stessi siano leggibili
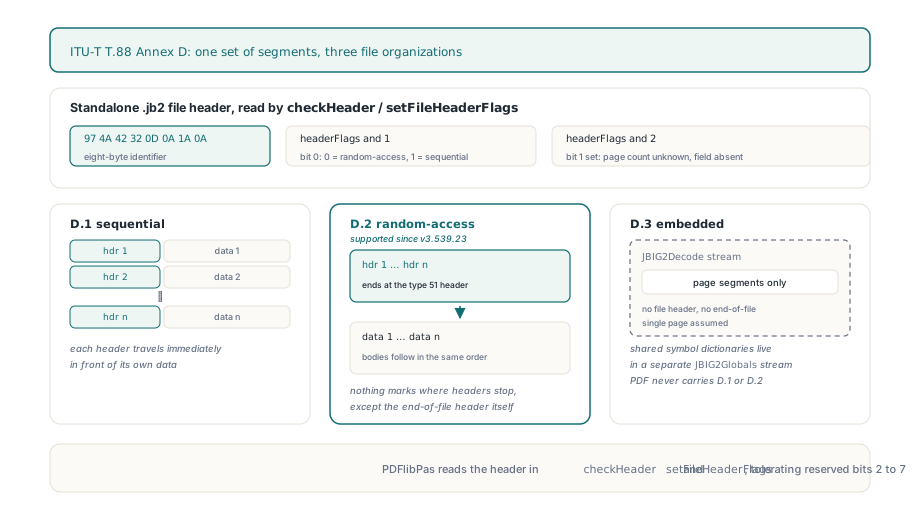
Il PDF stesso non porta mai il layout random-access. Uno stream immagine JBIG2Decode, descritto in ISO 32000-1 §7.4.7, contiene solo segmenti di pagina in forma embedded, con i dizionari di simboli condivisi spostati in uno stream JBIG2Globals separato e senza header di file, segmenti di fine pagina o di fine file. Quando il decoder non trova l'identificatore di otto byte, tratta l'input esattamente come quel tipo di stream: sequenziale, una pagina. Nel verso opposto, quando PDF Library for Delphi esporta un'immagine JBIG2Decode come file .jb2 nativo, scrive il byte di flag $03 (sequential, conteggio pagine sconosciuto) e accoda un header di segmento di fine file. Quindi il random access arriva solo dall'esterno, come file standalone passato direttamente a TPLJBIG2Decoder, di solito mentre viene convertito o ricompresso per il PDF con i backend di encoding JBIG2 in PDFlibPas
Perché non si può leggere un file random-access nell'ordine del file?
Perché niente nel flusso di byte segna dove finisce il blocco degli header e dove inizia il blocco dei dati, tranne l'header del segmento di fine file (tipo 51) stesso. Gli header di segmento JBIG2 non hanno dimensione fissa. Il conteggio dei segmenti referenziati è o una forma corta a tre bit o una forma lunga seguita da una bitmap di retention; ogni numero di segmento referenziato occupa uno, due o quattro byte a seconda di quanto è grande il numero del segmento corrente; il campo di associazione alla pagina è di un byte o di quattro. Un reader deve parsare ogni campo di un header solo per sapere dove inizia il successivo
Un reader sequenziale che percorre il file in ordine azzecca il primo header e sbaglia tutto quello che viene dopo. Peggio, potrebbe non accorgersene per un po': un decoder di regione generica a cui vengono dati in pasto byte di header produce pixel, non un errore, finché qualche controllo successivo di lunghezza o di riferimento finalmente scatta. La nostra opinione è che un decoder che non indicizza prima gli header dovrebbe rifiutare di netto i file random-access. Un rifiuto chiaro costa un file in un batch; una bitmap dall'aria plausibile ma sbagliata può finire in un archivio e restarci
Indicizzare ogni header prima del primo corpo
Quando il byte di flag dice random-access, PDF Library for Delphi fa un passaggio sul blocco degli header prima di decodificare qualsiasi cosa. Ogni header viene parsato per intero e poi buttato via; l'unica cosa conservata è il suo offset in byte nel file. I dati compressi non vengono mai copiati in un secondo buffer riordinato, cosa che conta sulle grandi scansioni di archivio dove il blocco dati può essere la maggior parte del file. Il passaggio si ferma al primo header di fine file, e a quel punto la posizione di lettura sta sul primo byte dei dati del primo segmento
Un file random-access ha meno ridondanza di uno sequenziale, quindi la pre-scansione è rigorosa. Rifiuta il file quando:
- un header viene troncato dalla fine del buffer, segnalato come
JBIG2 truncated random-access header at byte Ncon l'offset in cui quell'header iniziava - i numeri di segmento non crescono strettamente (confrontati come valori unsigned), perché due header che rivendicano lo stesso numero rendono ambigua la lista dei riferimenti di una regione successiva
- una lunghezza dati ha il bit più alto impostato, il che include il marcatore
0xFFFFFFFFdi "lunghezza sconosciuta"; in questo layout non c'è altro modo di trovare dove inizia il corpo successivo, quindi il decoder lo rifiuta subito invece di cercare in avanti un marcatore di fine - l'header di fine file dichiara dei dati, o non compare affatto (
JBIG2 random-access file is missing its end-of-file header) - le lunghezze dichiarate sommano a più dei byte rimanenti, o a meno
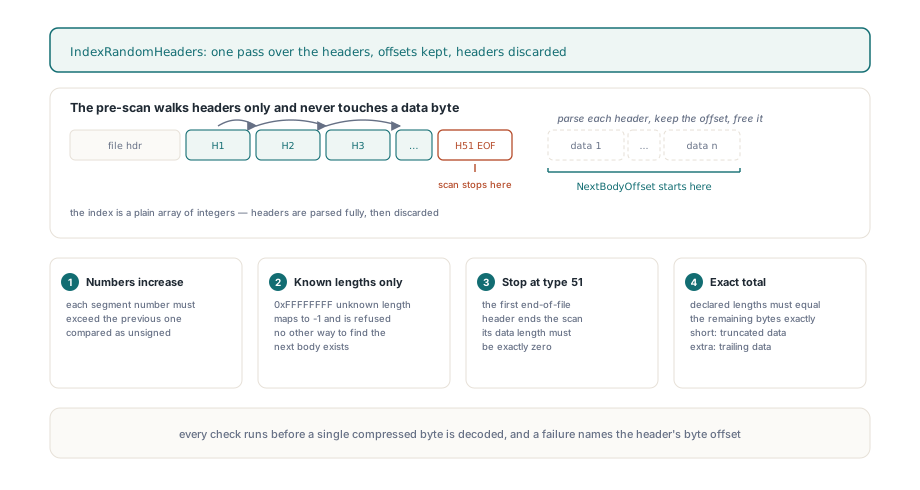
L'ultima regola è quella su cui la gente inciampa. Un singolo byte in più dopo l'ultimo corpo fallisce con JBIG2 trailing random-access data. Sembra severo rispetto al percorso sequenziale, dove la decodifica si ferma semplicemente al segmento di fine file e tutto ciò che segue viene ignorato. L'asimmetria ha una ragione. Nel layout sequenziale ogni header sta subito accanto ai propri dati, quindi la spazzatura in coda non può aver spostato nulla. Nel layout random-access gli header sono l'unica mappa del blocco dati, e se le lunghezze non tornano, il decoder non può distinguere un padding innocuo da un byte perso o aggiunto molto prima che ha spostato ogni corpo successivo
Perché un ciclo che conta i byte perde l'ultimo segmento di fine pagina?
Un ciclo che gira "finché restano byte" termina troppo presto su un file random-access, perché i dati finiscono prima dell'indice degli header. I segmenti di fine pagina (tipo 49) e di fine file portano zero byte di dati e normalmente vengono per ultimi. Una volta consumato l'ultimo corpo di regione, la posizione di lettura è esattamente alla fine del buffer; un ciclo che conta i byte esce lì, e il segmento di fine pagina a lunghezza zero non viene mai dispacciato, il che lascia la pagina incompleta
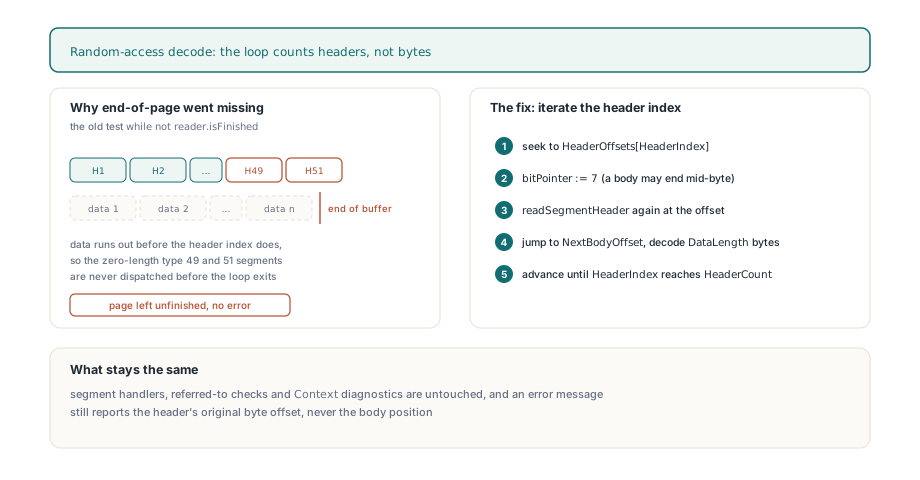
Quindi per i file random-access il decoder conta gli header, non i byte. Ogni passo salta indietro al prossimo header indicizzato, si riallinea a un confine di byte (un corpo codificato aritmeticamente può finire a metà di un byte), parsa di nuovo l'header, poi salta in avanti a dove inizia il corpo successivo e lo oltrepassa della lunghezza dichiarata. Un corpo il cui decoder finisce in anticipo viene saltato fino alla sua fine dichiarata; uno che legge oltre viene rifiutato. Da lì il segmento passa dagli stessi handler e controlli di riferimento di un file sequenziale. Gli errori sollevati durante la decodifica di un corpo portano la posizione originale dell'header, nella forma JBIG2 segment N (type T) at byte B: ..., così l'offset in LastError punta a qualcosa che puoi trovare in un hex editor
Caricare un file .jb2 random-access in Delphi
Il codice applicativo non cambia con l'organizzazione. TPLJBIG2Decoder.LoadFromByteArray rileva header del file e layout, restituisce False su qualsiasi input rifiutato con il motivo in LastError, ed espone la pagina decodificata tramite Width, Height e GetScanline, che riempie un byte per pixel con 1 per il nero
uses
  SysUtils, Classes, PDFlibJBIG2;

function ReadJb2(const FileName: string): TJBIG2ByteArray;
var
  FS: TFileStream;
begin
  FS := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    SetLength(Result, FS.Size);
    if Length(Result) > 0 then
      FS.ReadBuffer(Result[0], Length(Result));
  finally
    FS.Free;
  end;
end;

function CountBlackPixels(const FileName: string): Integer;
var
  Decoder: TPLJBIG2Decoder;
  Row: TJBIG2ByteArray;
  X, Y: Integer;
begin
  Result := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    // I file standalone sequential e random-access usano la stessa chiamata
    if not Decoder.LoadFromByteArray(ReadJb2(FileName)) then
      raise Exception.Create('JBIG2 rejected: ' + Decoder.LastError);
    for Y := 0 to Decoder.Height - 1 do
      if Decoder.GetScanline(Y, Row) then
        for X := 0 to Decoder.Width - 1 do
          if Row[X] = 1 then
            Inc(Result);
  finally
    Decoder.Free;
  end;
end;
Se vuoi sapere quale layout usa un file, per il logging o per smistare un corpus prima di una conversione, leggi tu stesso il byte di flag. La libreria non espone l'organizzazione che ha rilevato, e nove byte sono tutto ciò che serve. L'helper qui sotto è qualcosa da aggiungere al tuo codice; si limita a riformulare le regole dell'header di T.88:
type
  TJb2Layout = (jlNoFileHeader, jlSequential, jlRandomAccess);

// Helper tuo, non fa parte di PDFlibJBIG2: classifica un buffer in base al suo header di file T.88
function DetectJb2Layout(const Data: TJBIG2ByteArray;
  out PageCountKnown: Boolean): TJb2Layout;
const
  Signature: array[0..7] of Byte = ($97, $4A, $42, $32, $0D, $0A, $1A, $0A);
var
  I: Integer;
begin
  Result := jlNoFileHeader;          // es. uno stream embedded estratto da un PDF
  PageCountKnown := False;
  if Length(Data) < 9 then
    Exit;
  for I := 0 to 7 do
    if Data[I] <> Signature[I] then
      Exit;
  PageCountKnown := (Data[8] and 2) = 0;   // bit 1 impostato: nessun conteggio pagine a quattro byte
  if (Data[8] and 1) = 0 then
    Result := jlRandomAccess
  else
    Result := jlSequential;
end;
Job batch: buffer con padding e file rifiutati
La regola sui dati in coda è il punto in cui il codice batch tende a sbagliare, e quando un file che si apre altrove viene rifiutato in questo modo, guarda il buffer prima del file. Un .jb2 tirato fuori da una colonna BLOB di database, una lettura di rete a dimensione fissa o un formato container con padding di allineamento può arrivare con qualche byte a zero dopo la fine reale. Un file sequenziale se ne frega. Un file random-access con lo stesso padding fallisce con JBIG2 trailing random-access data, e così un buffer tagliato di qualche byte, che fallisce come troncato. Passa esattamente i byte del file, dimensionati dalla lunghezza reale della sorgente, mai da una dimensione di chunk o da una capacità
Un file rifiutato inoltre non lascia nulla dietro di sé. LoadFromByteArray azzera Width, Height e le scanline prima di iniziare a decodificare, quindi una chiamata fallita riporta dimensioni zero e non la pagina del file precedente, e la stessa istanza del decoder può passare direttamente al file successivo:
procedure DecodeBatch(const Files, Log, Quarantine: TStrings);
var
  Decoder: TPLJBIG2Decoder;
  I: Integer;
begin
  Decoder := TPLJBIG2Decoder.Create;
  try
    for I := 0 to Files.Count - 1 do
      if Decoder.LoadFromByteArray(ReadJb2(Files[I])) then
        Log.Add(Format('%s: %d x %d', [Files[I], Decoder.Width, Decoder.Height]))
      else
      begin
        // Qui Width e Height valgono 0; nulla del file precedente sopravvive
        Log.Add(Files[I] + ': ' + Decoder.LastError);
        if Pos('trailing random-access data', Decoder.LastError) > 0 then
          Quarantine.Add(Files[I]);   // controlla come sono stati memorizzati i byte prima di incolpare il file
      end;
  finally
    Decoder.Free;
  end;
end;
Verificare tutto questo nella tua pipeline non richiede file campione rari. Riorganizza un .jb2 sequenziale nel layout random-access, conservando ogni header e ogni byte compresso, sposta gli header di fine pagina e di fine file alla fine del blocco degli header, e i pixel decodificati devono coincidere esattamente con l'originale sequenziale, sia con sia senza il campo del conteggio pagine. Poi dagli in pasto ogni prefisso troncato, un numero di segmento duplicato, un byte extra in coda e una lunghezza 0xFFFFFFFF; ognuno dovrebbe restituire False con Width e Height a zero
Cosa restituisce il decoder, e cosa si aspetta
Il random access qui è una proprietà del layout del file. TPLJBIG2Decoder restituisce la bitmap della prima pagina qualunque sia l'organizzazione usata dal file, e Width e Height descrivono quella pagina. Ogni segmento deve dichiarare la sua lunghezza dati; T.88 permette a una regione generica immediata di usare il marcatore 0xFFFFFFFF, e il decoder rifiuta quel marcatore in entrambi i layout con unknown or oversized segment length is not supported. Le lunghezze dei prefissi Huffman custom e i conteggi delle voci di tabella sono limitati allo stesso modo dei file sequenziali
Decodificare JBIG2 è una tappa di un percorso immagine più lungo che copre anche estrazione di immagini da PDF, ricompressione ed encoding JBIG2; la pagina prodotto di PDF Library for Delphi copre il resto di quella pipeline e i formati immagine supportati