Dumpa byte per byte un segmento Tables JBIG2 (tipo 53) e la prima sorpresa è ciò che vi manca: i codici Huffman stessi. Trovi un byte di flag, due limiti e una serie di piccoli numeri, e quei numeri sono lunghezze di codice. Encoder e decoder ricostruiscono entrambi i pattern di bit effettivi dalle lunghezze con la procedura di ITU-T T.88 Annex B.3. Ricostruiscili in un ordine leggermente diverso e ottieni comunque un codice di prefisso valido, ogni pattern decodifica comunque, e ogni valore esce attaccato al pattern sbagliato
Su una pagina codificata con symbol ID Huffman e tabelle fornite dall'encoder, quello disallineamento assomiglia a una brutta scansione: glifi spostati di qualche pixel, caratteri assemblati con i simboli sbagliati, o numeri plausibili finché una larghezza non esce dall'intervallo qualche segmento più avanti. La maggior parte del JBIG2 nei file PDF è arithmetic-coded, e la maggior parte del JBIG2 Huffman-coded resta sulle tabelle standard da B.1 a B.15. I file che si portano le proprie tabelle sono rari, e tendono a esercitare insieme il parser delle tabelle, il refinement Huffman-coded e le collective bitmap non compresse
Cosa porta davvero un segmento Tables
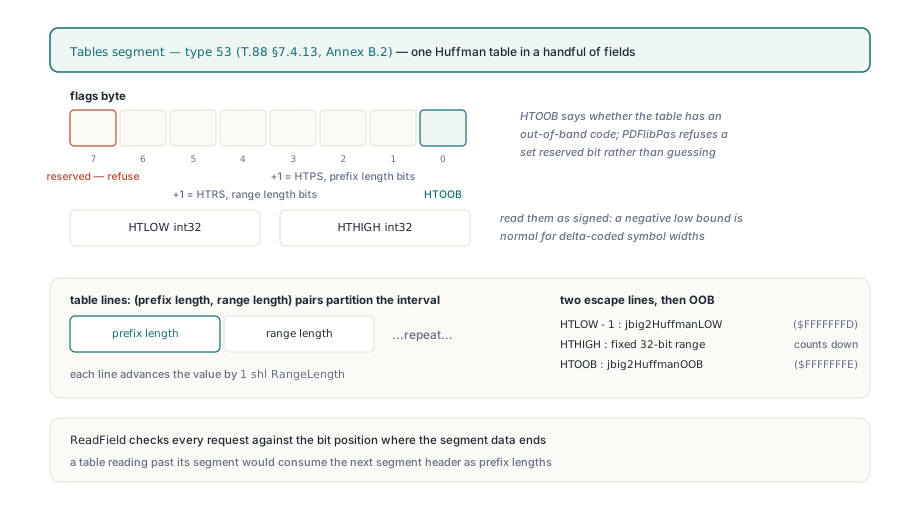
Un segmento Tables descrive esattamente una tabella Huffman. T.88 §7.4.13 e Annex B.2 la dispongono come un byte di flag, un HTLOW signed a 32 bit, un HTHIGH signed a 32 bit, e poi coppie (lunghezza del prefisso, lunghezza del range) che pavimentano l'intervallo da HTLOW fino a HTHIGH. Il bit 0 dei flag è HTOOB, che dice se la tabella ha un codice out-of-band. I bit da 1 a 3 più uno danno HTPS, la larghezza di ogni campo di lunghezza di prefisso. I bit da 4 a 6 più uno danno HTRS, la larghezza di ogni campo di lunghezza di range. Il bit 7 è riservato
I limiti sono dove un parser scritto a mano di solito inciampa per primo. Leggi HTLOW come unsigned e una tabella che parte da -2, cosa ordinaria per larghezze e altezze di simbolo codificate in delta, dichiara all'improvviso di partire da poco sotto i 4,3 miliardi. PDF Library for Delphi legge entrambi i limiti come valori signed, rifiuta una tabella il cui HTLOW non è sotto HTHIGH o la cui lunghezza di range supera 32, e controlla ogni lettura di campo contro il bit in cui finiscono i dati dichiarati del segmento. Quell'ultimo controllo conta più di quanto sembri: una tabella che legge oltre il proprio segmento consuma l'header del segmento successivo come lunghezze di prefisso e si parserizza in nonsense completo. Un bit 7 impostato fallisce con reserved custom Huffman table flag. Preferiamo quel rifiuto a un'ipotesi, perché una tabella indovinata produce pixel sbagliati che nessuno riesce a far risalire alla causa
Dopo le righe regolari arrivano le righe escape dell'Annex B.2. La riga di range inferiore parte da HTLOW meno uno e conta all'indietro con un offset a 32 bit, la riga di range superiore parte da HTHIGH con un range a 32 bit, e la riga out-of-band esiste solo quando HTOOB è impostato. Queste righe portano gli stessi marcatori che usano le tabelle standard integrate, così una tabella custom e la Table B.6 attraversano un unico ciclo di decodifica. Una tabella custom può contenere fino a 65.536 righe
Perché i codici di prefisso vanno assegnati nell'ordine delle righe della tabella?
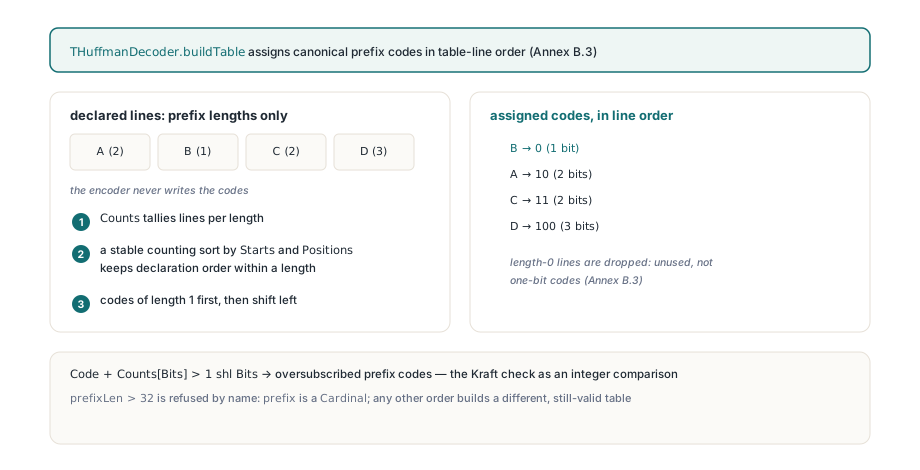
Perché l'ordine di dichiarazione è l'unica cosa che lega un pattern di bit a un intervallo di valori. L'Annex B.3 conta quante righe usano ogni lunghezza di prefisso, distribuisce prima i codici di lunghezza 1, scala a sinistra per passare alla lunghezza 2, e così via; dentro una stessa lunghezza, i codici vanno alle righe nell'ordine in cui compaiono nel segmento. Una tabella piccola rende tutto concreto. Sei righe, etichettate da A a F in ordine di file, con queste lunghezze di prefisso:
| Riga | Lunghezza del prefisso | Codice (ordine di file conservato) | Codice se B e D si scambiano |
|---|---|---|---|
| A | 2 | 00 | 00 |
| B | 3 | 100 | 101 |
| C | 2 | 01 | 01 |
| D | 3 | 101 | 100 |
| E | 3 | 110 | 110 |
| F | 0 | inutilizzata | inutilizzata |
Entrambe le colonne sono codici di prefisso validi. Solo quella di sinistra è ciò che l'encoder intendeva: con B e D scambiate, il pattern 100 restituisce l'intervallo di valori di D e il decoder continua con un numero dell'intervallo sbagliato. La riga F ha lunghezza 0, che B.3 definisce inutilizzata; dagli un codice di un bit e ogni assegnazione successiva slitta
La via facile per ottenere la colonna di destra è un ordinamento generico per lunghezza di prefisso. TArray.Sort e TList<T>.Sort di Delphi non sono stabili, quindi lunghezze uguali possono tornare in qualsiasi ordine. Per codici canonici nel tuo tooling, percorri le righe in ordine di file una volta per lunghezza:
uses
  System.SysUtils;

type
  TCodeLine = record
    PrefixLen: Integer;   // come letto dal segmento Tables
    Code: Cardinal;       // assegnato sotto
  end;

// Assegnazione canonica dell'Annex B.3, scritta per il tuo tooling.
// Le lunghezze uguali conservano l'ordine di file; la lunghezza 0 non prende codice.
procedure AssignCanonicalCodes(var Lines: array of TCodeLine);
var
  LenCount: array[0..32] of UInt64;
  FirstCode: array[0..32] of UInt64;
  NextCode: UInt64;
  CurLen, I: Integer;
begin
  FillChar(LenCount, SizeOf(LenCount), 0);
  for I := 0 to High(Lines) do
  begin
    if (Lines[I].PrefixLen < 0) or (Lines[I].PrefixLen > 32) then
      raise Exception.Create('prefix length out of range');
    Inc(LenCount[Lines[I].PrefixLen]);
  end;
  LenCount[0] := 0;
  FirstCode[0] := 0;
  for CurLen := 1 to 32 do
  begin
    FirstCode[CurLen] := (FirstCode[CurLen - 1] + LenCount[CurLen - 1]) shl 1;
    // Controllo di Kraft: più codici di quanti questa lunghezza ne può contenere
    if FirstCode[CurLen] + LenCount[CurLen] > (UInt64(1) shl CurLen) then
      raise Exception.Create('oversubscribed prefix lengths');
    NextCode := FirstCode[CurLen];
    for I := 0 to High(Lines) do       // l'ordine di file decide i pari
      if Lines[I].PrefixLen = CurLen then
      begin
        Lines[I].Code := Cardinal(NextCode);
        Inc(NextCode);
      end;
  end;
end;
Dalle in pasto le sei righe qui sopra e A prende 00, C prende 01, B prende 100, D prende 101 e E prende 110; F non prende codice. PDF Library for Delphi fa lo stesso lavoro con un passaggio di conteggio, stabile per costruzione e che evita di riscansionare la tabella 32 volte, e applica le stesse due guardie. Lunghezze in oversubscription falliscono con oversubscribed Huffman prefix codes; lasciarle passare significa che un pattern può corrispondere a due righe. Prefissi più lunghi di 32 bit falliscono per nome anch'essi, anche se T.88 li ammette sulla carta. Riteniamo quel tetto il giusto compromesso: ogni codice sta in una word macchina, e un file che ne richiede di più è assai più probabile che sia danneggiato che furbo
I valori richiedono la stessa attenzione. La riga di range inferiore si decodifica come HTLOW meno uno meno un offset unsigned a 32 bit, e con un intermediario Integer a 32 bit quella sottrazione può andare in wrap fino a diventare una larghezza positiva dall'aspetto ordinario. Il decoder lo fa a 64 bit e solleva Huffman value exceeds signed integer range quando il risultato vero non ci sta
Ordine dei selettori, e due trappole che si coprono a vicenda
Una text region o un symbol dictionary non nominano le proprie tabelle. Portano selettori a due bit, e ogni selettore impostato su custom prende il successivo segmento Tables dalla lista dei referenziati, in ordine di referenza. T.88 §7.4.3.1.2 ordina i selettori delle text region come FS, DS, DT, RDW, RDH, RDX, RDY e RSIZE; il §7.4.2.1.1 ordina i selettori dei symbol dictionary come DH, DW, BMSIZE e AGGINST. I valori 0 e 1 prendono tabelle standard, 3 prende una custom, e 2 è riservato sui campi che hanno solo due tabelle standard. PDF Library for Delphi rifiuta i valori di selettore riservati, e fallisce con missing custom Huffman table reference quando i selettori vogliono più tabelle custom di quante la region ne referenzia
Se scrivi un decoder tuo, qui due errori sono facili da fare, e ciascuno nasconde l'altro. Il primo morde in Delphi, o in FPC in modalità Delphi (la modalità objfpc rifiuta il codice come identificatore duplicato): un setter dei flag il cui parametro ha lo stesso nome del campo. Il parametro nasconde il campo, Flags := Flags assegna il campo a se stesso, e il campo resta zero. Ogni selettore poi legge zero, una text region usa le tabelle standard B.6, B.8 e B.11 per FS, DS e DT qualunque cosa il file abbia chiesto, e il percorso custom non gira mai
La seconda siede nel symbol dictionary. Un dizionario Huffman può memorizzare i propri simboli come collective bitmap non compressa (BMSIZE di zero), dove ogni riga finisce in un byte parziale. Il valore di padding è il numero di bit validi in quel byte, ed è una tentazione leggerlo come la posizione del bit valido più basso:
// Ultimo byte di una riga di collective-bitmap, bit letti MSB first.
// Padding := TotalWidth mod 8  -> numero di bit VALIDI in questo byte

// Sbagliato: tratta Padding come l'indice del bit più basso da copiare
for BitPos := 7 downto Padding do
  CopyPixel((LastByte shr BitPos) and 1);

// Giusto: l'indice del bit valido più basso è 8 - Padding (0 quando Padding = 0)
for BitPos := 7 downto ((8 - Padding) and 7) do
  CopyPixel((LastByte shr BitPos) and 1);

// CopyPixel sta per qualunque cosa scriva il pixel nel tuo decoder
Controlla le larghezze al confine. Una riga di 63 pixel ha un padding di 7: il ciclo sbagliato copia un bit dell'ultimo byte, quello giusto sette. Una riga di 9 pixel ha un padding di 1: il ciclo sbagliato copia sette, quello giusto ne copia uno. A 64 pixel entrambi copiano tutti e otto, quindi i multipli di 8 non lo espongono mai. Collective bitmap sintetiche larghe 7 e 9 pixel fissano entrambi i lati del confine del byte. E il danno viaggia, perché il refinement usa questi simboli come riferimenti
Se il tuo decoder ha entrambe le trappole, debuggarlo diventa misero. Correggi il setter da solo e il percorso custom finalmente gira, dritto nelle collective bitmap rotte, quindi la pagina sembra ancora sbagliata. Correggi il padding da solo e nulla cambia a vista, perché il percorso custom è ancora irraggiungibile. Prova entrambe con input sintetici prima di fidarti di una delle due correzioni. Un dettaglio affine: un symbol dictionary Huffman i cui simboli di input e nuovi sommano a uno prende dalla formula log2 una lunghezza del codice di simbolo pari a 0, eppure la variante Huffman scrive ogni symbol ID con almeno un bit. PDF Library for Delphi alza quella lunghezza a 1 in modalità Huffman
Dove legge la propria dimensione di bitmap il refinement Huffman?
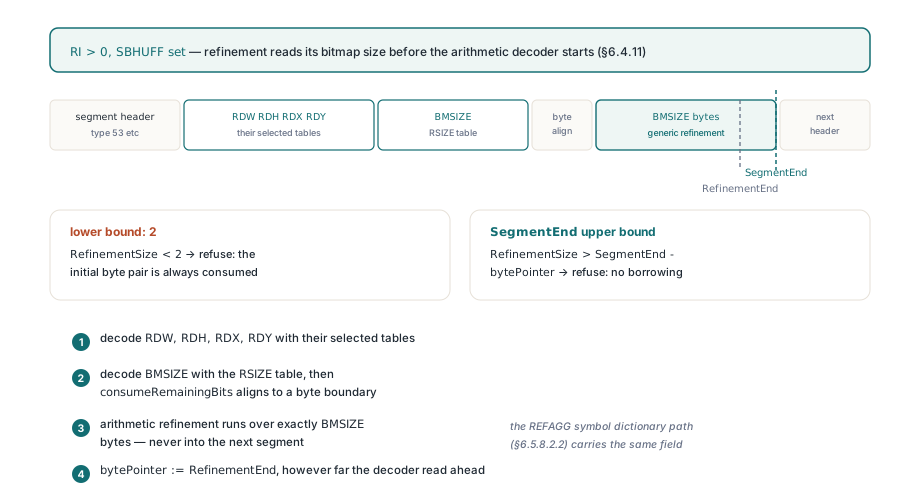
Da un campo BMSIZE che esiste solo in modalità Huffman, decodificato prima dei dati di refinement aritmetico. Quando un'istanza di text region ha refinement (RI diverso da zero) e SBHUFF è impostato, T.88 §6.4.11 fa leggere al decoder RDW, RDH, RDX e RDY con le loro tabelle selezionate, poi BMSIZE con la tabella RSIZE, poi saltare a un confine di byte, e solo allora eseguire la decodifica di refinement generica su esattamente BMSIZE byte. Le text region in modalità aritmetica un campo così non ce l'hanno, quindi un decoder che condivide un solo percorso tra le modalità lo salta, fa partire l'arithmetic decoder in anticipo, e raffina ogni simbolo contro rumore. Il percorso symbol dictionary con REFAGG e una singola istanza di refinement (§6.5.8.2.2) ha lo stesso campo
PDF Library for Delphi limita BMSIZE da entrambi i lati. Il minimo è 2, la coppia iniziale di byte che l'arithmetic decoder consuma sempre. Il massimo è ciò che resta del segmento corrente, deliberatamente non dell'intero stream: un BMSIZE che ci sta solo prendendo in prestito byte dal segmento successivo è malformato, e un controllo sulla lunghezza dello stream lascerebbe l'arithmetic decoder leggere dentro l'header seguente. Dimensioni fuori intervallo falliscono con invalid refinement bitmap size. Dopo, il reader Huffman riprende esattamente BMSIZE byte dopo il campo, indipendentemente da quanto abbia letto in avanti l'arithmetic decoder
La lunghezza dichiarata del segmento è il confine
Ogni header di segmento dichiara quanti byte di dati seguono, e il decoder tiene il segmento a quel numero in entrambe le direzioni: leggere oltre la fine è un errore, finire in anticipo è normale, e l'header successivo viene sempre letto da dove il file dice che inizia. Regole più piccole seguono. La lunghezza dati sconosciuta di T.88 §7.2.7 viene rifiutata all'inizio invece di cercare un terminatore. I segmenti referenziati devono portare numeri minori del corrente e devono già esistere. END_OF_PAGE e END_OF_FILE devono dichiarare zero byte di dati. Un segmento Profiles (tipo 52) deve essere esattamente 4 più 4 volte il conteggio di identificatori; viene poi saltato ma conservato, così i segmenti successivi possono ancora riferirsi a lui, e un identificatore di profilo sconosciuto non ferma la decodifica
Il caso classico di fine in anticipo è MMR. Un decoder MMR ha finito quando produce l'ultimo pixel dell'ultima riga, cosa che può accadere prima del terminatore EOFB che T.88 §6.2.5.7 mette alla fine dei dati. Un reader che presume di essere ormai all'header successivo parserizza i byte EOFB residui come numero di segmento e fallisce qualche byte più avanti, lontano dalla causa vera. Saltare alla fine dichiarata evita la domanda. La stessa abitudine attraversa il modo in cui PDF Library for Delphi parserizza strutture PDF non fidate in generale
Decodificare uno stream immagine JBIG2 da Delphi
Il decoder vive nell'unità PDFlibJBIG2 come TPLJBIG2Decoder. LoadFromByteArray prende i dati JBIG2 incorporati di un'immagine /JBIG2Decode e, facoltativamente, i dati del suo stream /JBIG2Globals, che è dove tabelle custom e symbol dictionary condivisi vivono di solito. Restituisce False su qualsiasi rifiuto e lascia il motivo in LastError; l'output di una chiamata precedente viene azzerato all'inizio di ogni chiamata, così una decodifica fallita non lascia mai pixel vecchi che il chiamante scambi per un risultato
uses
  System.SysUtils, PDFlibJBIG2;

// ImageBytes: i dati dello stream immagine con qualsiasi filtro prima
//   di JBIG2Decode già rimosso
// GlobalBytes: i dati dello stream /JBIG2Globals, o un array vuoto
function DecodeAndCountBlack(const ImageBytes, GlobalBytes: TJBIG2ByteArray;
  out BlackPixels: Int64): Boolean;
var
  Decoder: TPLJBIG2Decoder;
  Line: TJBIG2ByteArray;
  Row, Col: Integer;
begin
  BlackPixels := 0;
  Decoder := TPLJBIG2Decoder.Create;
  try
    Result := Decoder.LoadFromByteArray(ImageBytes, GlobalBytes);
    if not Result then
    begin
      // Forma: 'JBIG2 segment <n> (type <t>) at byte <offset>: <reason>'
      Writeln('JBIG2 refused: ', Decoder.LastError);
      Exit;
    end;
    for Row := 0 to Decoder.Height - 1 do
    begin
      Decoder.GetScanline(Row, Line);   // un byte per pixel, 0 o 1
      for Col := 0 to Decoder.Width - 1 do
        Inc(BlackPixels, Line[Col]);    // 1 = nero in JBIG2
    end;
  finally
    Decoder.Free;
  end;
end;
Il conteggio dei pixel neri è un controllo tuo, un'impronta economica da confrontare con un secondo renderer. I fallimenti a livello di segmento arrivano con prefisso numero di segmento, tipo e offset di byte, quindi un (type 53) davanti a oversubscribed Huffman prefix codes punta dritto a un segmento Tables. Tieni separati i due canali di errore: TPLJBIG2Decoder.LastError è il testo diagnostico di questo decoder, mentre TPDFlib.LastErrorCode è il codice numerico dell'API a livello di libreria. La selezione di pagina segue lo stream: il decoder restituisce la bitmap del primo segmento page-information che incontra e non va a cercare l'associazione di pagina 0, perché il JBIG2 incorporato in PDF porta una pagina sola e gli encoder la numerano abitualmente 1
Confrontare renderer su questi file richiede un po' di umiltà, perché decoder JBIG2 indipendenti non sempre concordano sui file con tabelle custom e refinement Huffman. Due decoder in disaccordo non stabiliscono niente. I campi del formato sì: quali tabelle hanno scelto i selettori, cosa dichiarava BMSIZE, dove finisce ogni segmento
La codifica è trattata nell'articolo sui backend encoder JBIG2 e come vengono collegati. Il percorso di lettura deve prendere ciò che l'encoder di qualcun altro ha emesso, e condivide le proprie regole con il decoder TIFF integrato e i suoi controlli BigTIFF e layout a tile: rifiutare per nome, non prendere mai in prestito byte oltre un confine dichiarato, tenere larga l'aritmetica intermedia. Se una cartella di PDF scansionati fa inciampare continuamente altri toolkit, controlla se le immagini sono JBIG2 Huffman-coded con tabelle custom, poi provale contro il percorso di lettura nativo Delphi e C++Builder descritto nella pagina del prodotto PDF Library for Delphi